Монга в контейнере?
да
 Vadzim


 yopp
всем привет, обновил монгу с 3 версии до 6. Смотрю на потребление оперативной памяти - монго практически всю съедает, возможно , конечно, так и до обновления было, но вряд ли. Может кто подскажет пожалуйста в какую сторону смотреть?
Память хост системы или контейнера?
В целом, базы данных не эффективно размещать на одном физическом хосте с другими активными потребителями памяти/дискового io
Монга расчитывает на два фактора: кеш данных и дисковый кеш ОС
Под кеш данных она по-умолчанию выделяет 50% «видимой памяти» (но не меньше 256Мб), но через конфиг можно установить фиксированный размер (storage.wiredTiger.engineConfig.cacheSizeGB).
Ещё какой-то объём она выделит под служебные структуры, включая различные буферы, например для сортировок или агрегаций.
На всё остальное расчёт что ОС заберёт это под свои задачи и всё остальное будет использовать под дисковый кеш.
В кеше данных все документы хранятся как есть, без компрессии. Монга расчитывает на свой алгоритм вытеснения «неактивных» и что только для активных потеря времени на компрессиию/декомпрессиию для них слишком большая.
Но на диске данные хранятся уже в сжатом виде.
Расчёт монги на то, что дисковый кеш ОС будет использоваться как «тёплый кеш», для данных которые требуются реже чем те, которые хранятся в кеше документов. Это всё равно на десяток порядков дешевле чем ходить на диск.
Плюс это будет резервом на случай если самой ОС, монге или каким-то другим процессам потребуется дополнительная память. Это уменьшает шанс что ос, монга или системные сервисы начнут уходить в отказ из-за отказа в выделении памяти
По этому если монга зарезервировала чуть больше половины памяти (если памяти >~1-2Gb), то это нормально и без явных причин с этим ничего делать не надо, иначе можно столкнуться со снижением производительности.
Если больше ~70%, то проверить конфиг, возможно там указан фиксированный размер кеша, который не соотвествует реально доступной памяти
#cacheSizeGB #память #wt #RAM
yopp
То есть получается, что нужно mongodb разбить на пару-тройку дисков?!
В 90% случаев не нужно :)
yopp
Лучше пока есть физическая возможность давать ей больше памяти
yopp
Когда такая возможность закончится, то оценить почему шардинг будет менее выгодным чем пытаться разнести часть dbPath по разным дискам, учитывая риски которые это за собой несет, в первую очередь проблема с реальной синхронзацией содержимого данных и содержимого журналам что критически важно при восстановлении после аварийного завершения
 Ghost
Лучше пока есть физическая возможность давать ей больше памяти
Понимаю... Просто речь идет о пока начальном изучении mongodb, установив его на свой ноутбук ))
 Alex
День добрый :)
Конфигурация - реплика монги
3 сервера (1 primary, 2 secondary)
Везде стоит Centos 7
Сегодня сел обновлять реплику монги с 4.2.20 до 5.0х
Успешно обновился до 4.4, потом случайно рубанул все три ноды разом, теперь монга не стартует :(
В логах пишет
“mongod.service start operation timed out”
Увеличил стартап до 150 минут - не помогло, через 150 минут крашит все тем же таймаутом
База совсем небольшая, использовалась под грейлог
Помогите монгу стартануть, плиз, руки уже опустились, гугл не помог(
Alex
Что в логе СУБД?
Извиняюсь, мне показалось я обновился до последней версии 4.4.х, где докой было предложено удалить строку “fork: true” из конфига, что я и сделал
А у меня почему-то встала 4.4.4. Вот она и причина, почему процесс не форкался и падал после таймаута запуска)
 Андрей
MongoDB еще не умеет перепаковывать коллекции с поднятым уровнем компрессии в конфиге?
Андрей
Например в HBase на хадупе это делается альтером и компактом.
 sp
для связи 1 ко многим look up не подходит?
 Niumandzi
Приветствую, есть бдшка, которая крутится в докер контейнере. В ней есть две коллекции, могу ли я как-либо скопировать две эти коллекции в формате json на свой пк?
Андрей
Приветствую, есть бдшка, которая крутится в докер контейнере. В ней есть две коллекции, могу ли я как-либо скопировать две эти коллекции в формате json на свой пк?
https://www.mongodb.com/docs/database-tools/mongoexport/
 Nick
MongoDB еще не умеет перепаковывать коллекции с поднятым уровнем компрессии в конфиге?
Нет, компрессия задается при создании коллекции и после не меняется
sp
Для этого $lookup и сделан
Да там все норм сорри за глупый вопрос). У меня лимит был установлен, поэтому не подхватывал все документы
Nick
@niumandzi засветили пароль от учетки БД, соответствующее сообщение удалил. Меняйте пароль и впредь повнимательнее
Niumandzi
Nick
mongo это адрес сервиса внутри докер подсети, но вы выполняете запрос сидя в другой подсети. Соответственно надо либо запускать экспорт также под докером либо стартовать монгу в хостовой сети либо глянуть ip у поднятого контейнера и долбиться по ip
Niumandzi
При попытке запустить экспорт из под докераничего не происходит
docker exec -it 5e724618497f mongoexport --host --port --db --collection --jsonArray > medical_cards.json
Nick
При попытке запустить экспорт из под докераничего не происходит
docker exec -it 5e724618497f mongoexport --host --port --db --collection --jsonArray > medical_cards.json
ну так экспорт выполнится внутри контенйра и файл экспорта останется там же. Чтоб на остался надо вольм пробрасывать. Лучше по ip сходите
Niumandzi
нет
Niumandzi
он не появляется внутри контейнера
Niumandzi
когда я делаю docker cp пишет, что файл not found
Niumandzi
делал внутри контейнера ls -a
Niumandzi
файлик тоже не появляется
Niumandzi
но никакой ошибки нет
Niumandzi
попробовал подключиться по ip контейнера
connection() error occurred during connection handshake: auth error: sasl conversation error: unable to authenticate using mechanism "SCRAM-SHA-1": (AuthenticationFailed) Authentication failed.
Nurlan
иногда когда в nodeJs создаю коннекшн с монго локалхост не находит.
но когда подключаюсь через монго компас все норм и nodejs тоже начинает норм видеть.
раньше такого не наблюдал. почему монго "засыпает" иногда ?
 Andrey K.
Вне контейнера
Niumandzi
2023-07-27T16:04:08.124+0000 connected to: mongodb://mongodb:27017/
2023-07-27T16:04:08.127+0000 Failed: (Unauthorized) command listCollections requires authentication
Niumandzi
вот с таким содержимым
Niumandzi
когда я делаю команду внутри контейнера
 Anton
привет всем, вопрос не по теме .. есть ли у кого сервера в hetzner? Замечали ли проблемы с доступом из билайн lte?
yopp
2023-07-27T16:04:08.124+0000 connected to: mongodb://mongodb:27017/
2023-07-27T16:04:08.127+0000 Failed: (Unauthorized) command listCollections requires authentication
вам нужно авторизоваться с логином/паролем который был установлен при создании контейнера через MONGO_INITDB_ROOT_USERNAME / MONGO_INITDB_ROOT_PASSWORD
см https://hub.docker.com/_/mongo раздел "Environment Variables"
 Kostya
 Kostya
 А
Здравствуйте, подскажите пожалуйста, по ценам монги, я бесплатно на сколько памяти могу использовать бд эту и какой минимальный платный тариф?
yopp
yopp
Здравствуйте, подскажите пожалуйста, по ценам монги, я бесплатно на сколько памяти могу использовать бд эту и какой минимальный платный тариф?
community версия не имеет ограничений
 Tony
Здравствуйте, подскажите пожалуйста, по ценам монги, я бесплатно на сколько памяти могу использовать бд эту и какой минимальный платный тариф?
Если ты про Atlas, то все на сайте. Если ты развернешь монгу у себя локально то ограничений нет
Kostya
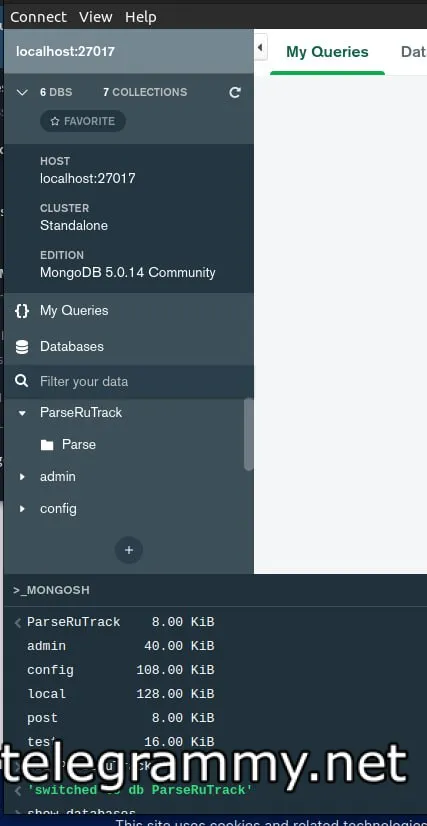
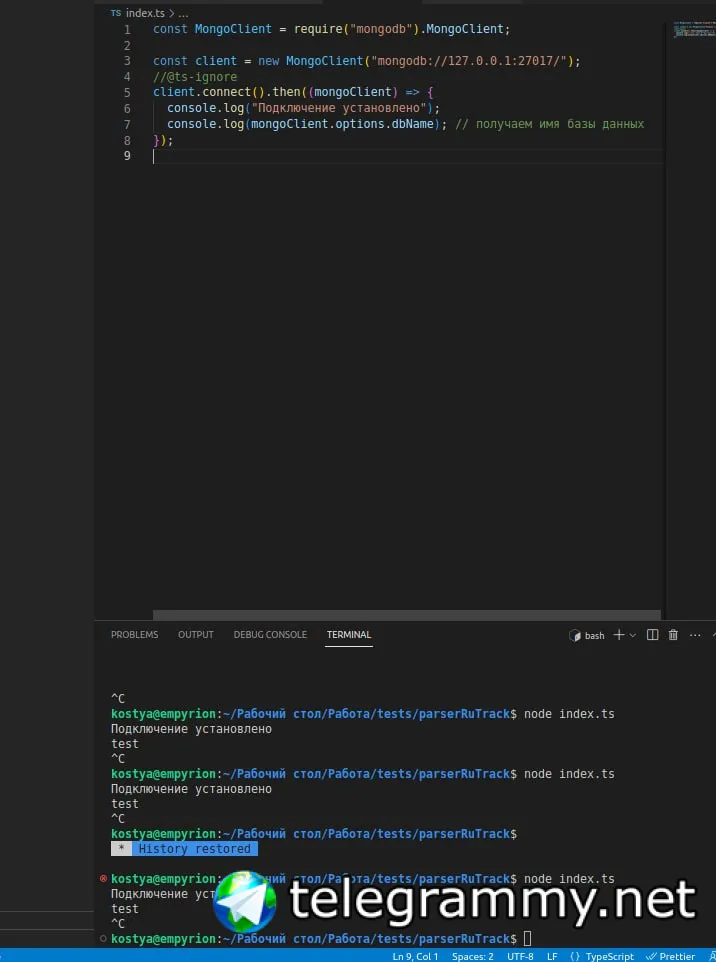
указать в конце строки подключения имя базы: mongodb://127.0.0.1:27017/dbname
Господи, спасибо вам, добрый человек!😂
А
community версия не имеет ограничений
а какие различия между бесплатной и платной и между разными платными пакетами?
скиньте пожалуйста где можно посмотреть
yopp
а какие различия между бесплатной и платной и между разными платными пакетами?
скиньте пожалуйста где можно посмотреть
нормальных сравнений нет, немного информации есть вот тут: https://www.mongodb.com/docs/manual/administration/upgrade-community-to-enterprise/
EE стоит $15k в год за каждые 256Гб оперативной памяти на каждом участнике кластера. Т.е. репликасет на 3 ноды с 128Гб: $45к/год
yopp
в эту сумму включена поддержка (TTO 1h), обучение и утилиты типа ops manager
В основном EE берут из-за поддержки, Ops Manager, encryption at rest и иногда in-memory хранилища
В остальном CE покрывает 99% потребностей.
Если нет серьёзных требований по хранению данных в своей инфраструтуре или у вас сходу нет сотни гигабайт данных, то даже CE не нужен, берите Atlas
А
в эту сумму включена поддержка (TTO 1h), обучение и утилиты типа ops manager
В основном EE берут из-за поддержки, Ops Manager, encryption at rest и иногда in-memory хранилища
В остальном CE покрывает 99% потребностей.
Если нет серьёзных требований по хранению данных в своей инфраструтуре или у вас сходу нет сотни гигабайт данных, то даже CE не нужен, берите Atlas
понял, спасибо за обьяснение, а что по кол-во подключений в секунду - тут нету ограничений по этому?
 Эмиль
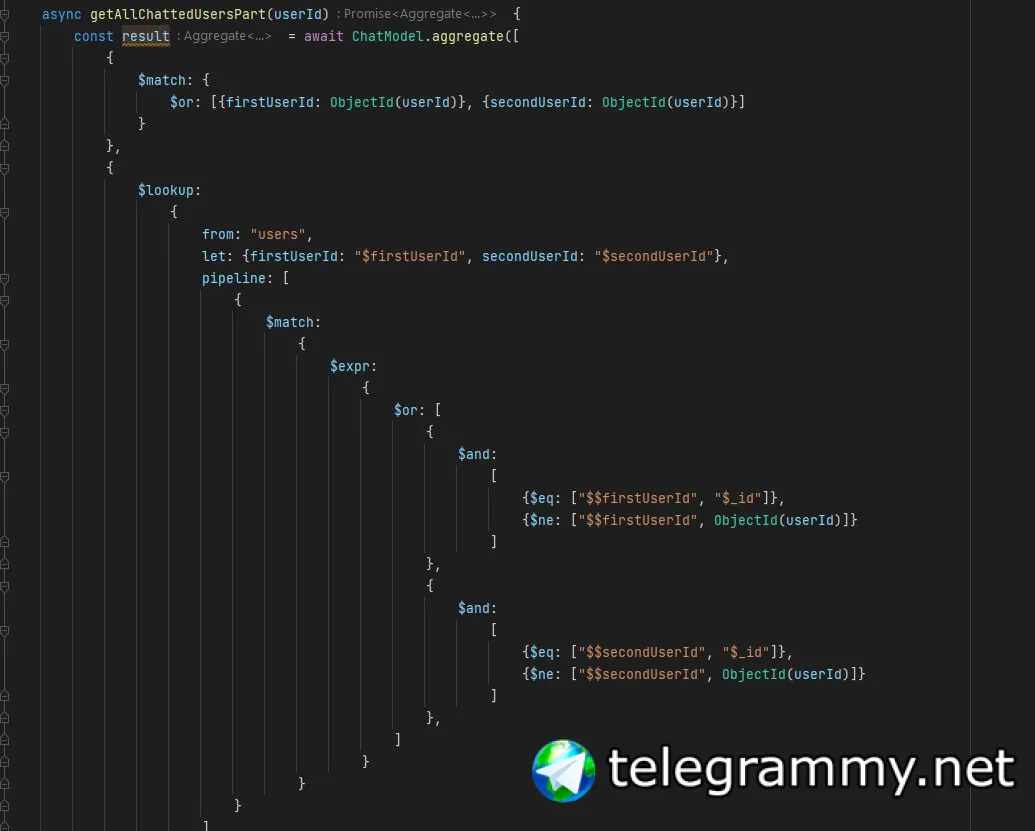
Здравствуйте, подскажите пожалуйста, как написать запрос.
Есть 2 коллекции:
1. User - просто пользователи
2. Chat - коллекция чатов, где хранятся 2 id двух пользователей: firstUserId и secondUserId
Нужно написать такой запрос, с помощью которого по id пользователя можно было бы найти всех пользователей, с которыми он когда-либо общался. То есть всех пользователей, которые есть с ним в паре в коллекции Chat.
В общем пытаюсь получить всех пользователей, с которыми когда-либо общался данный пользователь.
Nick
Здравствуйте, подскажите пожалуйста, как написать запрос.
Есть 2 коллекции:
1. User - просто пользователи
2. Chat - коллекция чатов, где хранятся 2 id двух пользователей: firstUserId и secondUserId
Нужно написать такой запрос, с помощью которого по id пользователя можно было бы найти всех пользователей, с которыми он когда-либо общался. То есть всех пользователей, которые есть с ним в паре в коллекции Chat.
В общем пытаюсь получить всех пользователей, с которыми когда-либо общался данный пользователь.
просто использовать $or в фильтре и потом при желании $project для отфильтровывания только id
Эмиль
просто использовать $or в фильтре и потом при желании $project для отфильтровывания только id
да, но там lookup надо еще юзануть, чтобы связать с таблицей пользователей. А вот по какому полю связывать - зависит от того, по какому именно условию в OR оно прокатило
Эмиль
если первый пользователь - наш, а второй - его собеседник, то по второму
а если второй пользователь - наш, а первый - его собеседник, то по первому
Nick
да, но там lookup надо еще юзануть, чтобы связать с таблицей пользователей. А вот по какому полю связывать - зависит от того, по какому именно условию в OR оно прокатило
если уже есть пользователь для которого надо чтото искать, то зачем лукап, id же уже есть
Nick
да, но там lookup надо еще юзануть, чтобы связать с таблицей пользователей. А вот по какому полю связывать - зависит от того, по какому именно условию в OR оно прокатило
без разницы по какому, потом надо просто выбрать относительно уже известного ид искомого юзера и можно прям в коде
 Alexander
Здравствуйте, подскажите пожалуйста, как написать запрос.
Есть 2 коллекции:
1. User - просто пользователи
2. Chat - коллекция чатов, где хранятся 2 id двух пользователей: firstUserId и secondUserId
Нужно написать такой запрос, с помощью которого по id пользователя можно было бы найти всех пользователей, с которыми он когда-либо общался. То есть всех пользователей, которые есть с ним в паре в коллекции Chat.
В общем пытаюсь получить всех пользователей, с которыми когда-либо общался данный пользователь.
У меня есть подобная задача. Чуть сложнее, но не суть важно...
Тоже сначала решали через $or. Но потом понадобилось заоптимизировать и сделали поле, содержащее список с обоими айдишниками — это всё сделало проще и быстрее.
Эмиль
 Эмиль
 Daniil
Эмиль
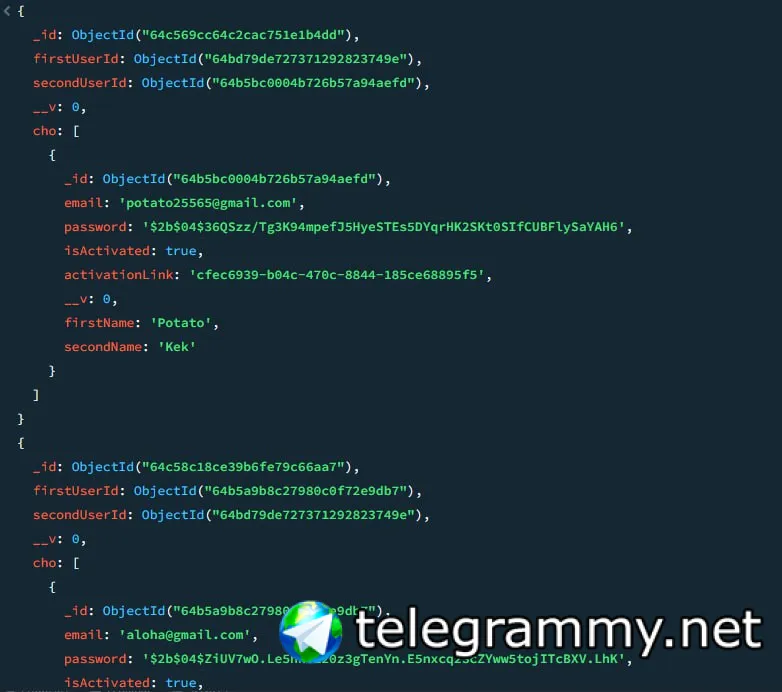
unwind после лукапа добавить и массив уйдет
ДА! Спасибо! Еще replaceRoot и вообще идеально всё проходит:
...
,{ $unwind : "$cho" }, { $replaceRoot: { newRoot: "$cho" } }
Получается просто список пользователей 👍
 Alexander "SonnySlave"
Добрый день.
Подскажите пожалуйста, видел ли кто-то бенчмарки MongoDB, собранного с помощью Profile-Guided Optimization (PGO)? Если да, то не могли бы вы, пожалуйста, поделиться со мной ссылкой на результаты бенчмарков. Интересуюсь с целью того, чтобы понять, сколько перфа можно выжать из MongoDB с помощью сборки с данной опцией.
Заранее спасибо.
Alexander "SonnySlave"
Впрочем, если кого-то заинтересует, то можете вот тут ознакомиться с моими результатами применения PGO к монге: https://github.com/zamazan4ik/awesome-pgo/blob/main/mongodb.md
 Stimul
Привет, ребята! Может кто-нибудь прояснить мне пару вопросов по поводу прфексов индекса?
Допустим, я имею индекс { a: 1, b: 1, c: 1 }. Он будет иметь префиксы { a: 1 } и `{ a: 1, b: 1 }`и они могут быть задействованы в запросах, как если бы я их создал отдельно, правильно? То есть создание этих индексов отдельно можно рассматривать как дублирование индексов?
Второй вопрос: если префикс { a: 1, b: 1 } может задействоваться при запросе, можно ли в таком случае перебирать коллекции в обоих направлениях, если a используется в фильтре, а b для сортировки? db.collection.find({ a: 'test' }).sort({ b: 1 }) и db.collection.find({ a: 'test' }).sort({ b: -1 }).
Nick
Привет, ребята! Может кто-нибудь прояснить мне пару вопросов по поводу прфексов индекса?
Допустим, я имею индекс { a: 1, b: 1, c: 1 }. Он будет иметь префиксы { a: 1 } и `{ a: 1, b: 1 }`и они могут быть задействованы в запросах, как если бы я их создал отдельно, правильно? То есть создание этих индексов отдельно можно рассматривать как дублирование индексов?
Второй вопрос: если префикс { a: 1, b: 1 } может задействоваться при запросе, можно ли в таком случае перебирать коллекции в обоих направлениях, если a используется в фильтре, а b для сортировки? db.collection.find({ a: 'test' }).sort({ b: 1 }) и db.collection.find({ a: 'test' }).sort({ b: -1 }).
Все верно по логике.
Но надо помнить что компаунд индексы могут достаточно большие и их задействование может не происходить если дешевле просто пробежаться по коллекции даже без использования индексов. Так что всеода используйте explain для понимания того как будет в реально сти выглядеть план выполнения запроса
Andrey K.
Привет, ребята! Может кто-нибудь прояснить мне пару вопросов по поводу прфексов индекса?
Допустим, я имею индекс { a: 1, b: 1, c: 1 }. Он будет иметь префиксы { a: 1 } и `{ a: 1, b: 1 }`и они могут быть задействованы в запросах, как если бы я их создал отдельно, правильно? То есть создание этих индексов отдельно можно рассматривать как дублирование индексов?
Второй вопрос: если префикс { a: 1, b: 1 } может задействоваться при запросе, можно ли в таком случае перебирать коллекции в обоих направлениях, если a используется в фильтре, а b для сортировки? db.collection.find({ a: 'test' }).sort({ b: 1 }) и db.collection.find({ a: 'test' }).sort({ b: -1 }).
еще сталкивался с прецедентом на большой шардированной коллекции...
Там не уехало на другой шард часть данных, и это все выглядело как 15, 16, 17, 32, 33, 34, 35, 36, 37, 38, .......
то есть значения 15, 16, 17 должны были уехать на другой шард. Но не уехали. И это провоцировало коллскан, а не использование индекса.
Yevhenii
Всем привет, запустил в докере монгу для тестов.
импортировал csv на 200млн записей.
пробую считать: db.pages.countDocuments(), выполняет порядка полторы минуты, что весьма долго.
судя по нагрузке, ресурсов процес почти не потребляет в момент выполнения запроса.
подскажите что можно подкрутить или это нормальное время выполнения для такого количества записей?
Андрей
Всем привет, запустил в докере монгу для тестов.
импортировал csv на 200млн записей.
пробую считать: db.pages.countDocuments(), выполняет порядка полторы минуты, что весьма долго.
судя по нагрузке, ресурсов процес почти не потребляет в момент выполнения запроса.
подскажите что можно подкрутить или это нормальное время выполнения для такого количества записей?
Счётчик хранится в статистике. Не надо ничё считать.
 Danish
 Danish
 Nick
Всем привет, запустил в докере монгу для тестов.
импортировал csv на 200млн записей.
пробую считать: db.pages.countDocuments(), выполняет порядка полторы минуты, что весьма долго.
судя по нагрузке, ресурсов процес почти не потребляет в момент выполнения запроса.
подскажите что можно подкрутить или это нормальное время выполнения для такого количества записей?
Да нормально, https://www.mongodb.com/docs/manual/reference/method/db.collection.countDocuments/#mechanics
Nurlan
Yevhenii
[
{
op: 'command',
ns: 'crawler.pages',
command: {
count: 'pages',
query: { 'page.hotelid:int': 2959 },
'$db': 'crawler'
},
millis: 163855,
}
]
всеравно как-то очень долго, и не вижу что бы диски или cpu грузились в момент запроса, памяти потреблять 40/100 гб
Nick
[
{
op: 'command',
ns: 'crawler.pages',
command: {
count: 'pages',
query: { 'page.hotelid:int': 2959 },
'$db': 'crawler'
},
millis: 163855,
}
]
всеравно как-то очень долго, и не вижу что бы диски или cpu грузились в момент запроса, памяти потреблять 40/100 гб
Какую задачу вы решаете? Зачем вам количество всех документов?