 -


Можно сортировать по самому objectId т.к. всё корректно отрабатывать будет, также время создания можно из ObjectId вытащить.
 Brykez7
 Nick
О спасибо об этом не знал.
Не надо использовать системное поле не предназначенное для хранения бизнес данных к которым относится у вас дата. И "можно достать дату" и "удобно работать с датой" это разные вещи и второе не про objectid.
 Турышев
https://medium.com/serpapi/mongodb-benchmark-3-4-vs-4-4-vs-5-0-vs-6-0-cb65146ae5ee
Всем здравствуйте! Хотим монгу на 6 версию с 4.4 обновить. Наткнулись на такую статью. Подскажите, пожалуйста, этой статье можно верить? Или кто-нибудь сталкивался с деградацией, после обновления?
Андрей
https://medium.com/serpapi/mongodb-benchmark-3-4-vs-4-4-vs-5-0-vs-6-0-cb65146ae5ee
Всем здравствуйте! Хотим монгу на 6 версию с 4.4 обновить. Наткнулись на такую статью. Подскажите, пожалуйста, этой статье можно верить? Или кто-нибудь сталкивался с деградацией, после обновления?
Все апгрейды продовых СУБД сначала прогоняются на дев среде, где определённое время происходит тестирование всей продуктовой логики в том числе нагрузочное и тогда любые вопросы про любые статьи с деградацией отпадают.
Nick
https://medium.com/serpapi/mongodb-benchmark-3-4-vs-4-4-vs-5-0-vs-6-0-cb65146ae5ee
Всем здравствуйте! Хотим монгу на 6 версию с 4.4 обновить. Наткнулись на такую статью. Подскажите, пожалуйста, этой статье можно верить? Или кто-нибудь сталкивался с деградацией, после обновления?
вот на неделе тестил релиз кандидат 7 версии по сравнению с текущей 6 - в редких запросах была деградация на 1-2% по времени исполнения, но на фоне общего ускорения типовых запросов (некоторые в 3 раза на 100кк коллекции) это не имеет значения.
Так что как сказали уже проводите свои тесты под свои потребности со своими данными на своих типах нагрузки, а не смотрите на выводы сделанные на синтетических тестах которые к вашему случаю скорее всего не относятся.
El
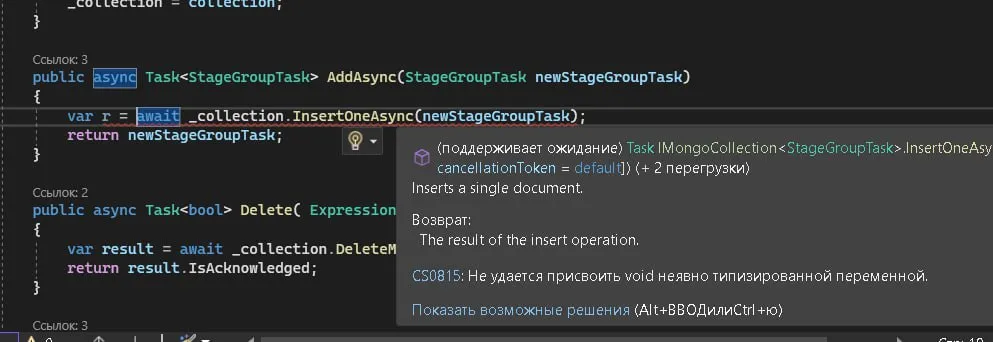
Я извиняюсь, есть ли в монге метод при создании документа что б его вернул? При обновлении нашел, а при создании не увидел. Иль самому делать доп запрос?
 Easy Rider
Я извиняюсь, есть ли в монге метод при создании документа что б его вернул? При обновлении нашел, а при создании не увидел. Иль самому делать доп запрос?
А какой в этом смысл? Она же не сама его создаёт, ты суешь его, уже готовый.
Easy Rider
Вот и делай дальше с ним что хочешь, монга ж просто вставляет его в коллекцию
Brykez7
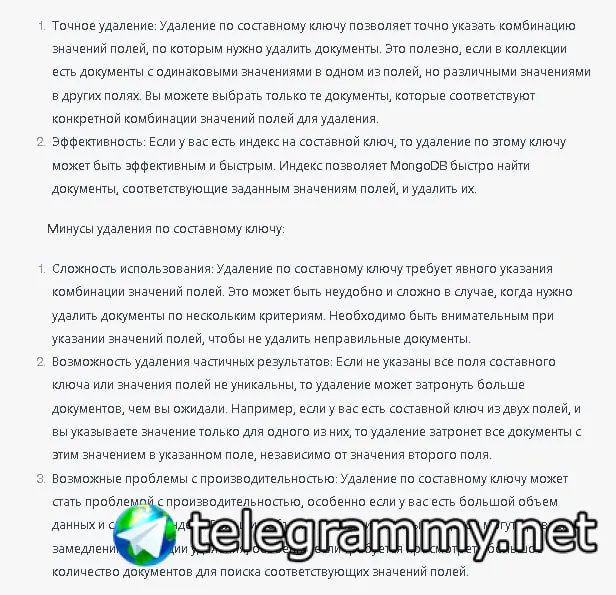
Насколько хорошей идеей будет удалять документ из MongoDB по составному индексу? Или это нежелательно и лучше удалять по id?
 of Astora 𒉭
Насколько хорошей идеей будет удалять документ из MongoDB по составному индексу? Или это нежелательно и лучше удалять по id?
Удаление документов из MongoDB по составному индексу возможно и может быть полезным в некоторых ситуациях. Однако, есть несколько вещей, которые следует учесть:
1. Производительность: Удаление документов по составному индексу может быть медленнее, чем удаление по идентификатору (id). При использовании составного индекса MongoDB должна выполнить дополнительные операции для поиска и удаления соответствующих документов.
2. Уникальность: Если составной индекс не является уникальным, удаление по нему может привести к удалению нескольких документов, соответствующих критериям индекса. В то время как удаление по идентификатору (id) гарантирует удаление только одного документа.
3. Читаемость кода: Удаление по идентификатору (id) является более понятным и ясным для других разработчиков. Они могут легко понять намерение удаления документа по его уникальному идентификатору.
В целом, рекомендуется использовать удаление по идентификатору (id), если это возможно. Однако, если у вас есть особые требования или конкретные сценарии использования, где удаление по составному индексу имеет смысл, то вы можете использовать его. Важно оценить производительность и уникальность составного индекса перед его использованием для удаления документов.
 El
Вот и делай дальше с ним что хочешь, монга ж просто вставляет его в коллекцию
Да тоже думал так и сделать и лишний раз не нагружать
Easy Rider
Да тоже думал так и сделать и лишний раз не нагружать
так оно просто по логике и не нужно, видимо от того и не стали делать, зачем делать то что излишне?
El
так оно просто по логике и не нужно, видимо от того и не стали делать, зачем делать то что излишне?
А зачем при обновлении сделали?
Easy Rider
А зачем при обновлении сделали?
потому что обновление меняет документ согласно логике оператора update, ты не заменяешь документ целиком
Easy Rider
то есть у тебя появляется как бы новый документ, который порождается этим оператором, а не тобой, и монга тебе его возвращает
El
то есть у тебя появляется как бы новый документ, который порождается этим оператором, а не тобой, и монга тебе его возвращает
Ну возможно пока я не столкнулся еще с этим примером, я пока мыслю что при изменении документа, так же на уровне фронта можно этими данными обновить документ, как и при создании. Типа если база ответила ок, то спокойно вставить то что послал в базу.
Easy Rider
Ну возможно пока я не столкнулся еще с этим примером, я пока мыслю что при изменении документа, так же на уровне фронта можно этими данными обновить документ, как и при создании. Типа если база ответила ок, то спокойно вставить то что послал в базу.
Ну ты можешь перехватывать ошибку при вставке, и самому понимать что он не вставился
Easy Rider
try{...insert... return true}catch{return false}
Easy Rider
как-то так. ну или возвращать объект или null в случае неуспеха
El
try{...insert... return true}catch{return false}
Ну да если не встал то показать ошибку которая пришла, а если встал и бэк прислал статус 200 к примеру, то ничего же не мешает вставить на уровне фронта обновленные данные
Easy Rider
Ну да если не встал то показать ошибку которая пришла, а если встал и бэк прислал статус 200 к примеру, то ничего же не мешает вставить на уровне фронта обновленные данные
ну вообще, логику надо разделять на слои. у меня например 3 слоя. 1 - контроллер. 2. бизнеслогика, сервисы. 3 - операции с базой данных.
на уровне бизнес-логики создаются транзакции, в которых могут участвовать сразу несколько операций с бд, если какая-то выдает ошибку, то в блоке catch на уровне бизнес-логики, транзакция целиком отменяется, потому что что-то пошло не так
El
Я пока не совсем понимаю разницы, между вставкой и обновлении, почему в первом случае решили не возвращать документ, а во втором сделали возврат
El
Я пока не совсем понимаю разницы, между вставкой и обновлении, почему в первом случае решили не возвращать документ, а во втором сделали возврат
И в первом и во втором случае можно обойтись без возврата
Brykez7
У меня возникают вопросы по поводу того почему insert не возвращает значение из за того что сама MongoDB может генерировать ObjectId но она его не возвратит.
El
И в первом и во втором случае можно обойтись без возврата
Ну по крайней мере айди то естественно нужен в любом случае, а вот остальное по сути и не надо
El
У меня возникают вопросы по поводу того почему insert не возвращает значение из за того что сама MongoDB может генерировать ObjectId но она его не возвратит.
Немного не понял, но инсерт возвращает айди в ответе
Brykez7
Немного не понял, но инсерт возвращает айди в ответе
 Easy Rider
 Nijat
Добрый день.
Не знаю, точно ли я по адресу, тем не менее, вдруг направите в нужном направлении.
Дано: 0 опыта и знаний по монго. Тем не менее, имеется одна БД в составе ПО, которая крутилась на отдельной виртуалке. Так вышло, что виртуализация поднакрылась медным тазом 29.06 вечером. Последний бэкап виртуалки целиком от 29.06 03:00. Быстренько восстановили виртуалку из бэкапа, данные продолжили писаться в неё. Однако удалось восстановить образ виртуалки с базой монго на момент накрытия тазом. В используемой в данный момент базе нет данных за 29.06. В восстановленном образе есть данные за 29.06, но нет всего, что после. Есть ли какие-либо способы внести в используемую сейчас базу утерянные данные за 29.06?
Nick
Добрый день.
Не знаю, точно ли я по адресу, тем не менее, вдруг направите в нужном направлении.
Дано: 0 опыта и знаний по монго. Тем не менее, имеется одна БД в составе ПО, которая крутилась на отдельной виртуалке. Так вышло, что виртуализация поднакрылась медным тазом 29.06 вечером. Последний бэкап виртуалки целиком от 29.06 03:00. Быстренько восстановили виртуалку из бэкапа, данные продолжили писаться в неё. Однако удалось восстановить образ виртуалки с базой монго на момент накрытия тазом. В используемой в данный момент базе нет данных за 29.06. В восстановленном образе есть данные за 29.06, но нет всего, что после. Есть ли какие-либо способы внести в используемую сейчас базу утерянные данные за 29.06?
если данных нет в бэкапах то восстановить неоткуда. разве что вы в логи писали данные и оттуда можно вытащить.
Андрей
Добрый день.
Не знаю, точно ли я по адресу, тем не менее, вдруг направите в нужном направлении.
Дано: 0 опыта и знаний по монго. Тем не менее, имеется одна БД в составе ПО, которая крутилась на отдельной виртуалке. Так вышло, что виртуализация поднакрылась медным тазом 29.06 вечером. Последний бэкап виртуалки целиком от 29.06 03:00. Быстренько восстановили виртуалку из бэкапа, данные продолжили писаться в неё. Однако удалось восстановить образ виртуалки с базой монго на момент накрытия тазом. В используемой в данный момент базе нет данных за 29.06. В восстановленном образе есть данные за 29.06, но нет всего, что после. Есть ли какие-либо способы внести в используемую сейчас базу утерянные данные за 29.06?
Экспортнуть по датам или таймштампам, если они присутствуют, и смёрджить импортом, если структура доков не слишком сложная для экспорта и он правильно всё прохавает. На отдельном инстансе проверяется.
Nijat
если данных нет в бэкапах то восстановить неоткуда. разве что вы в логи писали данные и оттуда можно вытащить.
Данные есть в восстановленном образе. Просто у меня такая ситуация сложилась - у меня одновременно крутится два клона одной виртуалки с различающимися версиями одной и той же базы. И я не могу придумать, как синхронизироваться. Т.е. та, что сейчас в продакшене хранит данные вплоть до 29.06 03:00 и после 30.06 00:00 условно. В другой виртуалке есть данные до 29.06 22:00, но нет того, что после. Вот эту разницу мне как-то внести бы в продакшен.
Easy Rider
Так я и говорю что он не возвращает Id.
значит так задумано. но по идее, это глупо, ведь id должен быть в модели, а тут еще один запрос надо делать
Easy Rider
причем искать надо как раз-таки по id, а его нет. тупик
Nijat
Экспортнуть по датам или таймштампам, если они присутствуют, и смёрджить импортом, если структура доков не слишком сложная для экспорта и он правильно всё прохавает. На отдельном инстансе проверяется.
Ок, т.е. можно сдампить данные за определённый срок и импортировать их в другую базу? Опять же, они полные клоны, просто в разных временах существуют будто бы.)
Easy Rider
но вообще я с таким не сталкивался, т.к. всегда делаю свои id, монговские иды мне как-то не нравятся
Easy Rider
свой ид можно сделать очень хитрожопый, например, такой что только у тебя на беке есть функция, которая чекает, входит ли id в некое подмножество которое показывает что этот ид сгенерен легально. помогает предотвращать на уровне логики некоторые ддос атаки
Easy Rider
то есть мы просто не лезем в базу, если предварительно поняли что этот ид - не настоящий, и ниче такого в базе быть не может по определению
Brykez7
Так я и про это. Напишут в своих библиотеках.... Приходится его на API генерировать а потом в базу уже готовый отправлять
Brykez7
значит так задумано. но по идее, это глупо, ведь id должен быть в модели, а тут еще один запрос надо делать
Brykez7
причем искать надо как раз-таки по id, а его нет. тупик
Андрей
Ок, т.е. можно сдампить данные за определённый срок и импортировать их в другую базу? Опять же, они полные клоны, просто в разных временах существуют будто бы.)
Да, попробуйте экспорт по условию с датой и потом импорт мердж модом.
Андрей
токо сначала на тесте
Nijat
Спасибо, поизучаю вопрос!
 Oleg
Всем привет. Подскажите, плиз, как вообще работает oplog? Не могу понять...
Сначала делаю фулл бэкап в директорию backup
Затем делаю изменения в бд, и делаю бэкап в директорию backup с флагом --oplog. Появляется файл oplog.bson.
Содержимое следующее
{"op":"n",
"ns":"",
"o":
"msg":{"periodic noop"},
"ts":{"$timestamp":{"t":1686761275,"i":1}},
"t":{"$numberLong":"6"},
"v":{"$numberLong":"2"},
"wall":{"$date":{"$numberLong":"1686761275306"}}}
Затем снова делаю изменения в монге, добавляю бд и коллекции. Запускаю mongodump с флагом —oplog. Файл oplog.bson просто перезатирается и не содержит информации, таймстамп о предыдущем бэкапе.
{"op":"n","ns":"",
"o":{"msg":"periodic noop"},
"ts":{"$timestamp":{"t":1686764685,"i":1}},
"t":{"$numberLong":"6"},
"v":{"$numberLong":"2"},
"wall":{"$date":{"$numberLong":"1686764685631"}}}
Так и должно быть или упускаю какие-то моменты?
Для фул бэкапа использую `mongodump --username backup_user --password backuppass12345 --host=rs0/mongodb-home-1:27017,mongodb-home-2:27017,mongodb-home-3:27017 --authenticationDatabase=admin --out=$(hostname)-$(date +%d%m%y)`
Для инкрементального `mongodump --username backup_user --password backuppass12345 --host=rs0/mongodb-home-1:27017,mongodb-home-2:27017,mongodb-home-3:27017 --authenticationDatabase=admin --out=$(hostname)-$(date +%d%m%y) --oplog`
Oleg
 yopp
Различные директории, в этом случае у вас будут срезы на момент бэкапа
 Alexandr
всем привет
при аггрегации я пытаюсь передать переменную в $densify.range.unit
"$densify": {
"field": "_id",
"range": {
"step": 1,
"unit": "$time_unit",
"bounds": "full"
}
}
и получаю ошибку
unknown time unit value: $time_unit
при этом я передаю эту же переменную в $dateTrunc.unit и все работает ок
в чем может быть дело?
 Vadzim
всем привет, у меня есть много баз данных и мне нужно сделать дамп всех за исключением одной бд( в которой находится две коллекции). Как я понял проигнорить при дампе конкретно одну бд нельзя , можно только коллекцию, используя аргумент excludeCollection. Но тогда приходится указывать аргумент db много раз, где необходимо перечислять все бд, которые у меня имеются. Можно ли как-то проще сделать?
Oleg
Различные директории, в этом случае у вас будут срезы на момент бэкапа
хотелось бы сохранить место. Я думал, что если буду делать бэкап в течение семи дней с флагом oplog, то смогу вернуться к бэкапу, который был например на 3ий день.
А так получается, какой бэкап крайний, тот и восстанавливается.
Андрей
Nick
хотелось бы сохранить место. Я думал, что если буду делать бэкап в течение семи дней с флагом oplog, то смогу вернуться к бэкапу, который был например на 3ий день.
А так получается, какой бэкап крайний, тот и восстанавливается.
походу это я ввел в заблуждение своим ответом. Через оплог можно накрутить инкремент бэкап, но в стандартной тулзе этого нет
Oleg
походу это я ввел в заблуждение своим ответом. Через оплог можно накрутить инкремент бэкап, но в стандартной тулзе этого нет
может быть уже есть готовые инструменты?
 .
Привет всем тут можно ссылку кидать?
 Alexandr
Только не кидайте на локальную бд😅
Easy Rider
есть бесплатные расширения для браузера
Easy Rider
еще есть бесплатный сыр
Nurlan
купи самый дешевый хостинг и сам себе сделай )
 Abdurazzoq
По поводу этого wylsacom недавно видосик сделал, посмотри
 Artem
Привет. Подскажите пж. Стэк: монга 6 + монгус и нода.
Так вышло что база упала (так и не понял почему), и заново не переподключилась пока вручную не перезапустил скрипт.
Соответственно скрипт работал и кидал запросы на базу, а она лежала и выходили ошибки.
Вопрос в том, как можно обезопаситься от таких ситуаций, на случай ночного падения базы, чтоб система условно заново реконнектнулась ?
Artem
База локально стоит
Андрей
Как обезопаситься от того, что вы не понимаете почему упала СУБД? Ответ в вопросе после запятой.
Nurlan
Привет. Подскажите пж. Стэк: монга 6 + монгус и нода.
Так вышло что база упала (так и не понял почему), и заново не переподключилась пока вручную не перезапустил скрипт.
Соответственно скрипт работал и кидал запросы на базу, а она лежала и выходили ошибки.
Вопрос в том, как можно обезопаситься от таких ситуаций, на случай ночного падения базы, чтоб система условно заново реконнектнулась ?
Есть плагины мангуста для пррверки коннекшна.
Если не подкл то само подклбчить.
Mongoose autoconnect
Типа такого. Погуглите даьлше плз сами
Nurlan
А так конечно Андрей выше праил но пишет что надо понять причину сначала
Artem
Artem
Но, разве есть совершенные системы которые не падают ?)
И допустим выявившуюся проблему я устранил, но это не гарантирует мне что «завтра» не вылезет следующая ночью и проект будет лежать до утра, разве нет ?)
Хочу просто обезопасить этот момень
Null
6.0.7 (Jun 28) ◦ 5.0.18 (May 18) • 4.4.22 (May 18)
🔥 Вышла версия 6.0.7 и релиз-кандидат 7.0.0-rc6
• Документация
• Официальный курсы: MongoDB University
• 🧑🔧 Консультации и поддержка MongoDB от 2190€ в месяц: @dd_bb
Stable: 6.0.7 (Jun 28) RC: 7.0.0-rc6 (June 28)
Bugfix: 5.0.18 (May 18)
Legacy: 4.4.22 (May 18, ☠️ Feb '24)
☠️ 4.2.24 (Apr '23), 4.0.28 (Apr '22), 3.6.23 (Mar ’21), 3.4.24 (Jan ‘20)
 Alexander
Всем пис братья
Artem
 Andrew
Добрый день дорогие колеги
Возможно кто-то сталкивался с похожий кейсом. Был бы очень признателен за совет.
я использую MEAN stack
И у меня возникли сложности при подключении к Mongo cloud https://cloud.mongodb.com/v2/
из приложения через nestjs/mongoose@10.0.0 or 9.2.2
const client = new MongoClient('mongodb+srv://username:password@hostname.fmq777h.mongodb.net/database');
await client.connect();
Error: querySrv ECONNREFUSED _mongodb._tcp.mongodb.net at QueryReqWrap.onresolve [as oncomplete] (node:internal/dns/promises:251:17)
Подключение к базе через Atlas все отлично (правда только через mongodb+srv://).
при использовании mongodb:// и стандартный порт 27017 подключиться не удаётся
Пробовал менять DNS на 8.8.8.8
Leonid
Всем привет. Может кто подскажет: какой командой добавить реплику к шарду? Хочу повысить отказоустойчивость. Новый сервер настроен и готов. Выполнять же все в роутере нужно?
yopp
Всем привет. Может кто подскажет: какой командой добавить реплику к шарду? Хочу повысить отказоустойчивость. Новый сервер настроен и готов. Выполнять же все в роутере нужно?
Здравствуйте! Да, подключаетесь через mongos и через sh.addShard добавляете реплику в шард
https://www.mongodb.com/docs/manual/tutorial/add-shards-to-shard-cluster/