Айпишник с которого мое приложение будет стартовать? Немного не понял
Смотри
 Mashxurbek

 Mashxurbek
@skkrrrrrra попробуй это. По дефолту с 4 версии там стоит 127.0.0.1 что не даёт подключаться. Поменяй это на [127.0.0.1, ИП твоего апп]
Здесь указал локалхост машины бд и машины твоего приложения. Если хочешь добавить свой комп добавь и его ип
 Илья
Здесь указал локалхост машины бд и машины твоего приложения. Если хочешь добавить свой комп добавь и его ип
Таки а чтобы мне просто подключиться с компасса что туда вписать?
Mashxurbek
Таки а чтобы мне просто подключиться с компасса что туда вписать?
ИП машины на которой компос
 mike
Добрый день, подскажите, как пропустить пустую строку в mongoose если в схеме required? Извиняюсь, что вопрос не по теме, но хз где спросить)
mike
ну это очевидно, только не в случае с mongoose, выдает validation failed
mike
да
mike
да, все вопрос решен) mongoose.Schema.Types.String.checkRequired(v => v != null);
mike
ок, спасибо
Air
Всем привет
В коллекции миллион товаров
У них у всех есть поле Категория
Уникальных категорий всего 15
Как вывести стату сколько товаров у каждой Категории?
Mashxurbek
Tetra
 LI
Доброе утро, форум, мне нужно 5 лучших веб-сайтов на английском языке, чтобы изучить MongoDB, пожалуйста, помогите (Примечание: эта ссылка автоматически переведена с Babel)
 Alexandrr
Доброе утро, форум, мне нужно 5 лучших веб-сайтов на английском языке, чтобы изучить MongoDB, пожалуйста, помогите (Примечание: эта ссылка автоматически переведена с Babel)
одного достаточно: https://www.mongodb.com/docs/manual/
Oleksandr
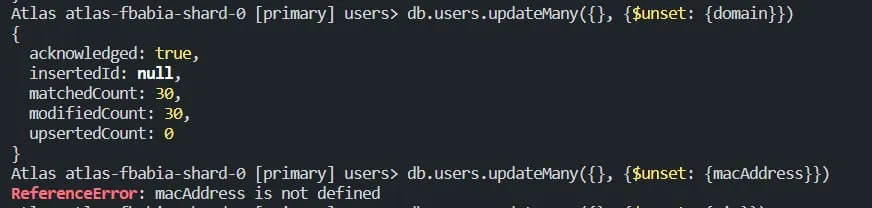
почему в одном случае команда сработала нормально, во втором - нет?
Oleksandr
 Roman
привет всем. нужна помощь
Roman
 Roman
 Roman
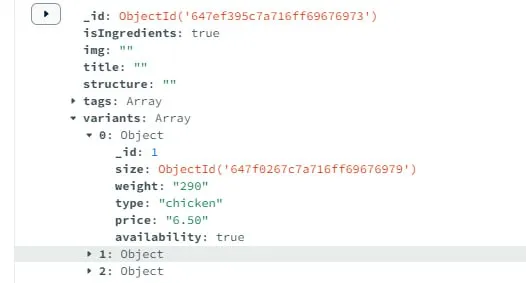
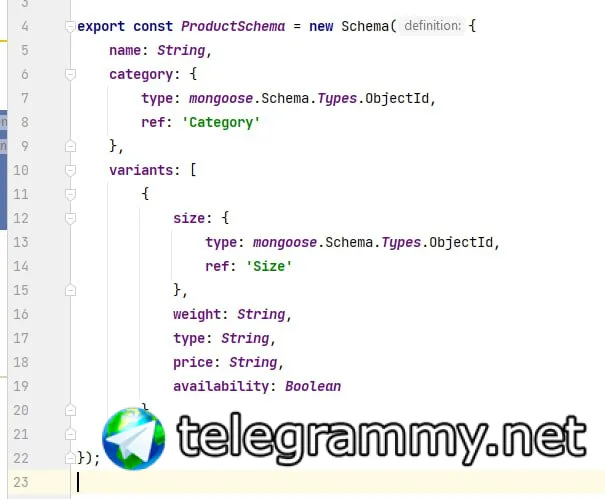
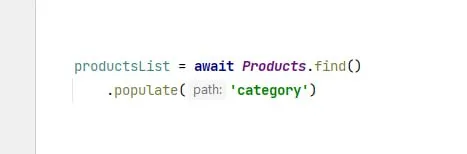
мне нужно каждому элементу прописать вместо ObjectId в поле size найденные данные из коллекции sizes
Roman
 Sergey
Привет! Подскажите, хочу сделать upsert, но в фильтрах помимо фильтра по id, есть ещё фильтр по одному полю (не уникальному), в тоге если он срабатывает, то пытается вставить документ. Хотелось бы что бы он вставлял только если нету документа по id, за 1 запрос. В какую сторону покопать?
 Nick
Привет! Подскажите, хочу сделать upsert, но в фильтрах помимо фильтра по id, есть ещё фильтр по одному полю (не уникальному), в тоге если он срабатывает, то пытается вставить документ. Хотелось бы что бы он вставлял только если нету документа по id, за 1 запрос. В какую сторону покопать?
киньте пример запроса как сейчас выглядит
Nick
Sergey
киньте пример запроса как сейчас выглядит
db.getCollection<Video>(collection).updateOne(
filter = and(
Video::id eq data.id,
Video::lastModifiedDate lt data.lastModifiedDate
),
target = data,
options = UpdateOptions().upsert(true)
)
 of Astora 𒉭
попробуй так
Sergey
Хочется что бы если нету по id - вставил, а если lastModifiedDate больше - ничего не делал
Nick
Хочется что бы если нету по id - вставил, а если lastModifiedDate больше - ничего не делал
да понял, что вопрос чутка в другом
Nick
Хочется что бы если нету по id - вставил, а если lastModifiedDate больше - ничего не делал
ничего в голову не приходит, кроме как ловить эксепшн про дубликат. Т.к. монга попробует вставить док еще раз то будет ошибка на дубль _id и второй док просто не вставится, надо только отловить ошибку чтобы дальше работа шла
Sergey
ничего в голову не приходит, кроме как ловить эксепшн про дубликат. Т.к. монга попробует вставить док еще раз то будет ошибка на дубль _id и второй док просто не вставится, надо только отловить ошибку чтобы дальше работа шла
Угу, сейчас так и есть, думал может как то красивше можно
Sergey
это вполне нормально
Наверное все же да, учитывая что вероятность такой ситуации довольно низкая. Спасибо!
Дима
Можно как-то обновить сразу несколько документов, причём нужному свое значение?
То есть одним запросом поменять, к примеру:
— у документа с id 5 переменные last_name и first_name на соответствующие id 5
— у документа с id 6 переменные last_name и first_name на соответствующие id 6
— у документа с id 7 переменные last_name и first_name на соответствующие id 7 и тд
Nick
Можно как-то обновить сразу несколько документов, причём нужному свое значение?
То есть одним запросом поменять, к примеру:
— у документа с id 5 переменные last_name и first_name на соответствующие id 5
— у документа с id 6 переменные last_name и first_name на соответствующие id 6
— у документа с id 7 переменные last_name и first_name на соответствующие id 7 и тд
Нормальный ответ - нет, ненормальный - апдейт с агрегацией с $switch
Дима
Нормальный ответ - нет, ненормальный - апдейт с агрегацией с $switch
А как по нормальному можно это реализовать? Если к примеру одновременно надо обновить 100 или даже 1000 юзеров?
Alexandrr
Можно как-то обновить сразу несколько документов, причём нужному свое значение?
То есть одним запросом поменять, к примеру:
— у документа с id 5 переменные last_name и first_name на соответствующие id 5
— у документа с id 6 переменные last_name и first_name на соответствующие id 6
— у документа с id 7 переменные last_name и first_name на соответствующие id 7 и тд
структура у документов какая? тут не гадалки собрались ;)
Nick
А как по нормальному можно это реализовать? Если к примеру одновременно надо обновить 100 или даже 1000 юзеров?
Ну взять и реализовать, никакой магии собрать пайп для агрегации нет
Nurlan
Можно как-то обновить сразу несколько документов, причём нужному свое значение?
То есть одним запросом поменять, к примеру:
— у документа с id 5 переменные last_name и first_name на соответствующие id 5
— у документа с id 6 переменные last_name и first_name на соответствующие id 6
— у документа с id 7 переменные last_name и first_name на соответствующие id 7 и тд
Можно. ChatGPT может облегчить. Но ваш запрос придется несколько пересказывать)
 Nick
А как по нормальному можно это реализовать? Если к примеру одновременно надо обновить 100 или даже 1000 юзеров?
Но лучше сделайте по апдейту на каждого юзера это и проще и быстрее
Дима
Но лучше сделайте по апдейту на каждого юзера это и проще и быстрее
Я думаю быстрее одним запросом обновлять чем тысячей, ведь весь код будет ждать выполнения
Nick
Я думаю быстрее одним запросом обновлять чем тысячей, ведь весь код будет ждать выполнения
да хоть и ждать, монга сама по себе плюс минус одинаково по времени отработает что тыщу одиночных апдейтов что один на тыщу параметров.
Alexandrr
Ну взять и реализовать, никакой магии собрать пайп для агрегации нет
вроде же обновлять много доков нельзя пайплайном?
только спец метод апдейт_мани, но он под капотом подключение поднимает и держит отправляя всё равно постепенно + синхронно, разве что модуль асинка использовать, тогда можно через N коннектов N обновлений заслать, всё выполнится точно быстрее, но это возможно только с пулом подключения поднятым гораздо заранее, иначе спавнить много коннектов тоже займёт время и неизвестно, что получится быстрее при какой текущей нагрузке и стоимостях каждой операции в пачке
Nick
вроде же обновлять много доков нельзя пайплайном?
только спец метод апдейт_мани, но он под капотом подключение поднимает и держит отправляя всё равно постепенно + синхронно, разве что модуль асинка использовать, тогда можно через N коннектов N обновлений заслать, всё выполнится точно быстрее, но это возможно только с пулом подключения поднятым гораздо заранее, иначе спавнить много коннектов тоже займёт время и неизвестно, что получится быстрее при какой текущей нагрузке и стоимостях каждой операции в пачке
да можно и много доков обновлять пайплайном, так же как и обычный агргеат с $merge по сути, только явно видно что там доки обновляются а не просто выборка
 anonymous
подскажите как в windows сделать задачу чтобы по расписанию поднимал службу mongodb
anonymous
если остановиться
 Daniil
Всем привет, реализовываю фильтрацию с помощью монги.
На данный момент есть несколько этапов агрегации (match, sort, project), при этом в составлении запроса для match используется 2 отдельных запроса к базе для получения промежуточных данных.
После агрегации происходит populate
Нужно добавить фильтрацию по полям, которые получаются через populate, для этого я решил populate заменить на несколько lookup'ов (4) помещенных в начало агрегации. Но в результате время выполнения запроса неприятно выросло.
Понимаю, что причина этого в том, что все lookup'ы выполняются над всей коллекцией последовательно, но не знаю, на что можно их заменить, чтобы уменьшить время обработки запроса.
Может есть уже проверенные временем подходы оптимальные или кто-то сталкивался с подобного рода проблемами?
Alexandrr
Всем привет, реализовываю фильтрацию с помощью монги.
На данный момент есть несколько этапов агрегации (match, sort, project), при этом в составлении запроса для match используется 2 отдельных запроса к базе для получения промежуточных данных.
После агрегации происходит populate
Нужно добавить фильтрацию по полям, которые получаются через populate, для этого я решил populate заменить на несколько lookup'ов (4) помещенных в начало агрегации. Но в результате время выполнения запроса неприятно выросло.
Понимаю, что причина этого в том, что все lookup'ы выполняются над всей коллекцией последовательно, но не знаю, на что можно их заменить, чтобы уменьшить время обработки запроса.
Может есть уже проверенные временем подходы оптимальные или кто-то сталкивался с подобного рода проблемами?
пересматривай структуру данных, надо избавляться от 4х лукапов
у меня похожая проблема полгода назад была.
пробовал и через facet, и на уровне кода асинком кидаться, только изменяя структуру данных удалось ускориться
Daniil
пересматривай структуру данных, надо избавляться от 4х лукапов
у меня похожая проблема полгода назад была.
пробовал и через facet, и на уровне кода асинком кидаться, только изменяя структуру данных удалось ускориться
Структуру данных поменять навряд ли выйдет, так как время на это никто выделять не будет)
Daniil
Всего 4 join, думал, обычная тема даже для монги)
Alexandrr
Всего 4 join, думал, обычная тема даже для монги)
ну если оно не умеет в 4 записи параллельных
Alexandrr
Структуру данных поменять навряд ли выйдет, так как время на это никто выделять не будет)
ну если не будет выделять, пусть тогда запросы по 5 секунд работают у них
Daniil
ну если оно не умеет в 4 записи параллельных
populate же параллельно обрабатывает? Просто странно, что похожего процесса нет для стейджов.
Alexandrr
populate же параллельно обрабатывает? Просто странно, что похожего процесса нет для стейджов.
Метод populate в Mongoose поддерживает асинхронную обработку запросов к базе данных
в чём вопрос не пойму?
Alexandrr
populate же параллельно обрабатывает? Просто странно, что похожего процесса нет для стейджов.
второй вопрос:
" match используется 2 отдельных запроса к базе для получения промежуточных данных" - зачем тебе 2 запроса для матча? как 2 запроса, как ты пишешь связаны с аггрегацией вообще? что за винигрет?)
Alexandrr
у тебя в самой аггрегации это всё можно выполнить.
1. в матче ищешь что нужно
2. сортируешь
3. фильтруешь
4. проецируешь
о каких 2х запросах или 4х тем более речь?
Daniil
у тебя в самой аггрегации это всё можно выполнить.
1. в матче ищешь что нужно
2. сортируешь
3. фильтруешь
4. проецируешь
о каких 2х запросах или 4х тем более речь?
2 match'а писал не я, я наоборот хочу всё в одном скоупе агрегации сделать. Проблема в том, что для матча надо заджойнить 4 коллекции, так как к ним применяются некоторые фильтры и данные с них нужны клиенту.
Раньше это выполнялось через два отдельных запроса в базу + отдельным populate. Я попробовал заменить эту методику на lookup'ы с фильтрацией на месте, но время выполнения запроса выросло почти в два раза, Отсюда такие вопросы
Nick
2 match'а писал не я, я наоборот хочу всё в одном скоупе агрегации сделать. Проблема в том, что для матча надо заджойнить 4 коллекции, так как к ним применяются некоторые фильтры и данные с них нужны клиенту.
Раньше это выполнялось через два отдельных запроса в базу + отдельным populate. Я попробовал заменить эту методику на lookup'ы с фильтрацией на месте, но время выполнения запроса выросло почти в два раза, Отсюда такие вопросы
переделайте порядок лукапов, чтобы на первых было отсеяно максимальное количество доков, либо денормализируйте данные/меняйте структуру
Alexandrr
2 match'а писал не я, я наоборот хочу всё в одном скоупе агрегации сделать. Проблема в том, что для матча надо заджойнить 4 коллекции, так как к ним применяются некоторые фильтры и данные с них нужны клиенту.
Раньше это выполнялось через два отдельных запроса в базу + отдельным populate. Я попробовал заменить эту методику на lookup'ы с фильтрацией на месте, но время выполнения запроса выросло почти в два раза, Отсюда такие вопросы
пробуй тогда другой подход, грузить не БД, а приложение этой работой.
если оптимизировать запрос не удаётся, а в этом случае как не изменяй, и через facet будет тот же результат
придётся писать асинхронщину, разбив каждый запрос на мини-запрос, итого 4 шт. асинхронно
единственная оптимизация скорее будет в фильтрации на уровне БД + проекция
ну а в приложении уже соединить в один джсончик
методом подбора, как написал Ник выше, пускай самый тяжёлый мини-запрос - первым по очереди
Daniil
переделайте порядок лукапов, чтобы на первых было отсеяно максимальное количество доков, либо денормализируйте данные/меняйте структуру
пробовал добавлять в каждый из лукапов нужные матчи, результат хуже)
Nick
пробовал добавлять в каждый из лукапов нужные матчи, результат хуже)
а какие размеры связываемых таблиц? есть ли индексы на полях по которым идет фильтрация?
Daniil
Связываемые таблицы небольшие: 70 объектов в самой большой. Индексы в основной таблице есть и используются, на счет связываемых не уверен: база данных от индусов досталась, так что там в основном всё грустно
В связываемых тоже индексы есть
Alexandrr
Связываемые таблицы небольшие: 70 объектов в самой большой. Индексы в основной таблице есть и используются, на счет связываемых не уверен: база данных от индусов досталась, так что там в основном всё грустно
В связываемых тоже индексы есть
значит тем более не еби себе мозги, делай на уровне приложения, как я тебе написал, конечно, если кто в корне ещё другой вариант решения не предложит, в теории и на практике такие микрооптимизации работали всегда быстрее, пробуй разные варианты, Ника вариант тоже хорош.
тебе осталось протестировать, а за тебя уже подумали ;)
Daniil
Парни, спасибо, поставил match первым и взлетело)
 Borislav
Всем привет. Вопрос мне не профильный но мучаюсь с ним я.
Есть mongo.
в ней есть тейбл.
Условно структура
db.tasks
[{ "some_field": "some value",
"execution": {
"artifacts": {
"hash1234":
"url": "10.10.10.10/somedata"
},
"hash5324":
"url": "10.10.10.10/somedata"
}
},
{ "some_field": "some value",
"execution": {
"artifacts": {
"hash12341":
"url": "10.10.10.10/somedata"
},
"hash1235324":
"url": "10.10.10.10/somedata"
}
},
et.c.
Мне нужно поменять во всей таблице url с 10.10 на 0.0 условно.
Добраться через forEach не получается, т.к. там дальше дикт с уникальными ключами.
Хелп)
Работаю через монговский терминал
anonymous
Это понятно как сделать bat фаилик чтобы добавить в планировщик
Alexandrr
Всем привет. Вопрос мне не профильный но мучаюсь с ним я.
Есть mongo.
в ней есть тейбл.
Условно структура
db.tasks
[{ "some_field": "some value",
"execution": {
"artifacts": {
"hash1234":
"url": "10.10.10.10/somedata"
},
"hash5324":
"url": "10.10.10.10/somedata"
}
},
{ "some_field": "some value",
"execution": {
"artifacts": {
"hash12341":
"url": "10.10.10.10/somedata"
},
"hash1235324":
"url": "10.10.10.10/somedata"
}
},
et.c.
Мне нужно поменять во всей таблице url с 10.10 на 0.0 условно.
Добраться через forEach не получается, т.к. там дальше дикт с уникальными ключами.
Хелп)
Работаю через монговский терминал
что за структура данных такая:
{"hash12341": "url": "10.10.10.10/somedata"}
?
Borislav
что за структура данных такая:
{"hash12341": "url": "10.10.10.10/somedata"}
?
Ну в питоне я б сказал что это словарь)
Borislav
Вообще во всей бд во всех вложенных полях один url на другой нужно поменять
Borislav
BJSON
Nick
Всем привет. Вопрос мне не профильный но мучаюсь с ним я.
Есть mongo.
в ней есть тейбл.
Условно структура
db.tasks
[{ "some_field": "some value",
"execution": {
"artifacts": {
"hash1234":
"url": "10.10.10.10/somedata"
},
"hash5324":
"url": "10.10.10.10/somedata"
}
},
{ "some_field": "some value",
"execution": {
"artifacts": {
"hash12341":
"url": "10.10.10.10/somedata"
},
"hash1235324":
"url": "10.10.10.10/somedata"
}
},
et.c.
Мне нужно поменять во всей таблице url с 10.10 на 0.0 условно.
Добраться через forEach не получается, т.к. там дальше дикт с уникальными ключами.
Хелп)
Работаю через монговский терминал
и всетаки в бд
"hash1235324": {
"url": "10.10.10.10/somedata"
}
или както иначе, а то в примере что привели невалидный json
Borislav
это далеко не словарь, это херь какая-то)
словарь выглядит явно по-другому
Сейчас скину валидный пример)
anonymous
Есть у кого-нибудь батник,на скрипт,чтобы служба mongo запускалась
anonymous
Скиньте пожалуйста