 Андрей


/path_to_mongod/mongod -f /path_to_config/mongodb.conf
 Артем
Или возможно обновление не нужно😅
Андрей
параллельно в отдельной консоли повесив tail -f на файл лога СУБД
Андрей
Ну и апгрейдить пакеты какого-либо ПО, обрабатывающего пользовательские данные без бэкапа этих данных, - дальше можно не продолжать. Первая самая важнейшая шишка в работе с СУБД набита 😏
Андрей
А и еще забыть про системду как таковую при дебаге и не посылать туда людей особенно начинающих, о чём уже говорил. Это барахло со своими код=килд и сигнал= настолько тупорылое, насколько это описывается в анекдоте "штурман - приборы". Есть же подробнейший лог у всего и вся в линуксе, который на понятном английском языке обозначен в конфиге чего-угодно 😉
NO WAR!
https://www.mongodb.com/community/forums/t/core-dump-on-mongodb-4-4-19-on-rpi-4/215223 - прям ваш случай.
Спасибо, большое.
Помогло.
🤝
 Сергей
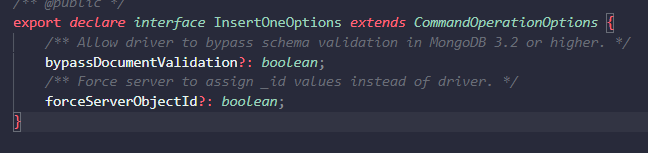
в аргументах метода указать return_document: True
нет такого параметра они его убрали если он был😔
Сергей
 Alexandrr
нет такого параметра они его убрали если он был😔
с версий 4.х было убрано, оставили только в find_one_and_update
Alexandrr
Сергей
с версий 4.х было убрано, оставили только в find_one_and_update
вообщем у меня всё равно кластер спит, его только серверній фронт некста бьёт иногда, так что не критично повторным запросом вытащить документ в нужном виде) спасибо
а вообще странное решение, значит при апдейте больше операций и есть опция вернуть документ даже до и после апдейта, а в простом добавлении нету 🤡
Странная логика
 Aram
вообщем у меня всё равно кластер спит, его только серверній фронт некста бьёт иногда, так что не критично повторным запросом вытащить документ в нужном виде) спасибо
а вообще странное решение, значит при апдейте больше операций и есть опция вернуть документ даже до и после апдейта, а в простом добавлении нету 🤡
Странная логика
А чем тебе findOneAndUpdate не подходит? Можно его с upsert использовать
Сергей
А чем тебе findOneAndUpdate не подходит? Можно его с upsert использовать
да я недавно начал работать с этой базой, название метода супер неочевидное для этого кейса
Aram
Ну, rm -rf тоже многим кажется неочевидным
 Lukaš 🇨🇿
вообщем у меня всё равно кластер спит, его только серверній фронт некста бьёт иногда, так что не критично повторным запросом вытащить документ в нужном виде) спасибо
а вообще странное решение, значит при апдейте больше операций и есть опция вернуть документ даже до и после апдейта, а в простом добавлении нету 🤡
Странная логика
Ну я например имею структуру, которую передаю в метод для обновления документа и эту же структуру и возвращаю из него
Сергей
Ну я например имею структуру, которую передаю в метод для обновления документа и эту же структуру и возвращаю из него
Да, так тоже можно сделать.
Но у меня такой кейс, что слишком много функционала зависит от данных и что в них. А потом на основе этих данных ещё и нужно работать с базой данных. Все приложение в одном потоке работает SPA, но при этом ещё на стороне сервера постоянно проверяются и заготавливаются страницы со всей динамикой но в виде статики.
Вообщем. Моя истина там это то, что лежит в бд. Так что нарушать этот подход - bad practic
Lukaš 🇨🇿
Ну не знаю, бэд, не бэд, данные есть данные
Lukaš 🇨🇿
Если эти данные не записались в базу, то они уж точно никак не должны быть возвращены
Сергей
Тут больше речь о человеческом факторе. Особенно когда много универсальных функций и т.д. и т.п.
Проходит время и ты хочешь добавить что-то и вот такой возврат данных при условии что страница не должна обновляется может вылезть боком.
Во всяком случае я так считаю, не раз уже проходил эту историю :)
Lukaš 🇨🇿
Ну я не спорю, но не очень понимаю как возврат данных на обновлении страницы сказывается
Lukaš 🇨🇿
Ну ты оберни метод запроса в нечто вроде Result или Either из haskell, и тогда ты просто прогарантируешь, что он выполнился и результат тот, который ты ждал. Для тебя перестанет иметь значение как возврат делать, имхо
Сергей
Та это дело больше вкуса, мне проще сделать так. Потому что в моём случае данные с бд забирает только сервер на котором динамически формируется фронт, или когда администратор использует множество интерфейсов для изменения или добавления данных.
В среднем у меня на кластере 1 запрос в секунду. Это неочём.
Сергей
Даже если будет 10000 пользователей сидеть на ресурсе, ситуация не изменится
Lukaš 🇨🇿
Привет всем.
У меня есть 3 таблички.
user_account { id, billing_account_ids: [id] }
billing_account {id, user_id, currency_id }
currency { id }
Я пытаюсь из user_account собрать это все в один объект. Но получилось как-то сильно громоздко. Может можно как-то проще?
db.getSiblingDB("billing").getCollection("user_account")
.aggregate([
{
$match: {
_id: ObjectId("64549f7b5c809efe8f9bdb11")
}
},
{
$lookup: {
from: "billing_account",
localField: "billing_account_ids",
foreignField: "_id",
as: "billing_accounts"
}
},
{
$unwind: {
path: "$billing_accounts",
preserveNullAndEmptyArrays: true
}
},
{
$lookup: {
from: "currency",
localField: "billing_accounts.currency_id",
foreignField: "_id",
as: "billing_accounts.currency"
}
},
{
$unwind: {
path: "$billing_accounts.currency",
preserveNullAndEmptyArrays: true
}
},
{
$group: {
_id: "$_id",
billing_accounts: {$push: "$billing_accounts"},
otherFields: {$first: "$$ROOT"}
}
},
{
$replaceRoot: {
newRoot: {
$mergeObjects: ["$otherFields", {
billing_accounts: {
$cond: [
{"$eq": [{"$size": "$otherFields.billing_account_ids"}, 0]},
[],
"$billing_accounts"
]
}
}]
}
}
},
])
 Nick
Привет всем.
У меня есть 3 таблички.
user_account { id, billing_account_ids: [id] }
billing_account {id, user_id, currency_id }
currency { id }
Я пытаюсь из user_account собрать это все в один объект. Но получилось как-то сильно громоздко. Может можно как-то проще?
db.getSiblingDB("billing").getCollection("user_account")
.aggregate([
{
$match: {
_id: ObjectId("64549f7b5c809efe8f9bdb11")
}
},
{
$lookup: {
from: "billing_account",
localField: "billing_account_ids",
foreignField: "_id",
as: "billing_accounts"
}
},
{
$unwind: {
path: "$billing_accounts",
preserveNullAndEmptyArrays: true
}
},
{
$lookup: {
from: "currency",
localField: "billing_accounts.currency_id",
foreignField: "_id",
as: "billing_accounts.currency"
}
},
{
$unwind: {
path: "$billing_accounts.currency",
preserveNullAndEmptyArrays: true
}
},
{
$group: {
_id: "$_id",
billing_accounts: {$push: "$billing_accounts"},
otherFields: {$first: "$$ROOT"}
}
},
{
$replaceRoot: {
newRoot: {
$mergeObjects: ["$otherFields", {
billing_accounts: {
$cond: [
{"$eq": [{"$size": "$otherFields.billing_account_ids"}, 0]},
[],
"$billing_accounts"
]
}
}]
}
}
},
])
но можно ваше условие про $size указать во втором лукапе, посмотрите на пример https://www.mongodb.com/docs/manual/reference/operator/aggregation/lookup/#perform-an-uncorrelated-subquery-with--lookup
Lukaš 🇨🇿
Понял, спасибо
 Nichita
привет, не понимаю почему появляются дубликаты при определенной сортировке, только по полю даты обновления продукта все ок
Nichita
была теория что из-за того что поля сортировки не было в прожекшене, убрал полностью прожекшен - не помогло
Nichita
хотя у меня индекс создан по тому фильтру именно по полю даты обновления, остальное сортирует в памяти, возможно в этом проблема? решит проблему если я добавлю все поля сортировки?
Nichita
решил проблему, добавив еще одну сортировку
 Andrey K.
знает ли кто-нибудь, как я могу посмотреть значения в коллекции config.settings ?
в доке написано, что она внутренняя, описан ее update, при этом я не вижу ее ни через гуи, ни через show collections.
db.settings.find({ "_id" : "balancer" }) также не показывает
версия 4.2
Andrey K.
Кластер построен?
да, шардированный, работает ок.
Вообще я хотел посмотреть, какая сейчас стоит настройка _secondaryThrottle для миграции чанков.
По дефолту д.б. отключена, но хотел проверить
 yopp
Эти коллекции не доступны на data нодах
yopp
К сожалению не помню, доступны ли они через mongos
Andrey K.
К сожалению не помню, доступны ли они через mongos
посмотрю через конфиг-сервера. Апдейт производится через монгос, поэтому на монгосе я и ожидал возможность просмотра
yopp
(Помоему должна быть доступна, так как это часть cluster view которым пользуются mongos)
Andrey K.
На любой из CSRS нод
не, на cfg аналогичная ситуация. ну ладно. 99,999% , что применяется дефолтная настройка.
А не могли бы еще подсказать, вот тут про миграцию чанков говорится, что
Independent of any _secondaryThrottle setting, certain phases of the chunk migration have the following replication policy:
MongoDB briefly pauses all application reads and writes to the collection being migrated, on the source shard, before updating the config servers with the new location for the chunk, and resumes the application reads and writes after the update. The chunk move requires all writes to be acknowledged by majority of the members of the replica set both before and after committing the chunk move to config servers.
When an outgoing chunk migration finishes and cleanup occurs, all writes must be replicated to a majority of servers before further cleanup (from other outgoing migrations) or new incoming migrations can proceed.
Правильно понимаю, что последовательность такая
- чанк переехал
- запись/чтение на шардированную коллекцию замерла
- инфа на cfg обновилась
- запись/чтение на шардированную коллекцию стартовала
если так, то почему написано The chunk move requires all writes to be acknowledged by majority of the members of the replica set both BEFORE and AFTER committing the chunk move to config servers, или тут речь идет о цфг-серверах ?
Andrey K.
это я пытаюсь понять, почему тормозит миграция чанков
Anonymous
👍
Anonymous
Всем привет. Нахожу запись в базе по _id. Как взять эту запись и ещё 99 предыдущих?
Nick
Всем привет. Нахожу запись в базе по _id. Как взять эту запись и ещё 99 предыдущих?
что значит "предыдущих"?
Anonymous
Которые лежат в базе
Nick
это не ответ на вопрос, нужен критерий предыдущести
Артем
Всем привет. Нахожу запись в базе по _id. Как взять эту запись и ещё 99 предыдущих?
Может быть какой-нибудь $gt и limit
Артем
это не ответ на вопрос, нужен критерий предыдущести
он хочет получить 100 записей начиная с конкретного _id
Артем
только не 100 вперед, а 100 назад, включая текущую
Nick
так мы опять подходим в вопросу о порядке, в монге нет просто "порядка документов"
Nick
вы должны явно обозначить как задается этот порядок
Anonymous
Пока что на уме только:
.find({}).sort({_id: -1}).find({_id: {$lte: ...}}).limit(100)
Артем
так мы опять подходим в вопросу о порядке, в монге нет просто "порядка документов"
_id разве не порядок ?
Anonymous
вы должны явно обозначить как задается этот порядок
Ну как они по факту в базе лежат, такой порядок
Anonymous
Пока что на уме только:
.find({}).sort({_id: -1}).find({_id: {$lte: ...}}).limit(100)
Но два .find нельзя вызвать
Nick
_id разве не порядок ?
т.е. сортирвоака по _id, но это не тоже самое "как лежит в базе"
Anonymous
Возможно придётся агрегацию писать
Артем
т.е. сортирвоака по _id, но это не тоже самое "как лежит в базе"
ты душнишь как-то...
Anonymous
Но в базе уже 100 000 записей и планируется ещё тысяч 500
Nick
ты душнишь как-то...
да, без этого на вопрос не ответить. Потому что если человек хочет $natural порядок, то это одно, если по возрастанию _id другое, если у него порядок задается в какомто другом поле то вообще третье
Артем
да, без этого на вопрос не ответить. Потому что если человек хочет $natural порядок, то это одно, если по возрастанию _id другое, если у него порядок задается в какомто другом поле то вообще третье
_id не гарантирует порядок по дате добавления в базу разве ?
Nick
_id не гарантирует порядок по дате добавления в базу разве ?
прям гарантируется только если он проставляется на нешардирвоанном сервере, плюс опять же не гарантируется порядок отправки из разных приложений, так что "гарантии" он реально про подушнить)
Nick
Пока что на уме только:
.find({}).sort({_id: -1}).find({_id: {$lte: ...}}).limit(100)
вот и решение под требования
Anonymous
Хотя дёргать не часто будут. Если запрос будет выполняться меньше секунды, то норм
Anonymous
Ну хорошо
Anonymous
Но два .find выполнить нельзя. Тогда агрегацию писать?
Артем
Ну, нашёл в оффицальной документации
Получается в монге сложно отсортировать именно по порядку вставки в базу
Связь между порядком ObjectIdзначений и временем генерации не является строгой в пределах одной секунды. Если несколько систем или несколько процессов или потоков в одной системе генерируют значения в течение одной секунды; ObjectIdзначения не представляют строгий порядок вставки. Рассогласование часов между клиентами также может привести к нестрогому порядку даже для значений, поскольку клиентские драйверы генерируют ObjectIdзначения.
David
Добрый вечер, коллеги! Может кто сможет здесь помочь. В кратце, пишу бота для телеграм. При начале диалога (/start) бот выводит сообщение для пользователя и параллельно делает запись в бд(монго, логично), НО! Если пользователь будет несколько раз производить тыкательные движения по отношению к данной команде, в базу данных записываются дублирующие записи. Теперь вопрос-мольба о помощи: как сделать проверку на наличие в коллекции определённой записи и не допустить дублирование?
Nick
Ну, нашёл в оффицальной документации
Получается в монге сложно отсортировать именно по порядку вставки в базу
Связь между порядком ObjectIdзначений и временем генерации не является строгой в пределах одной секунды. Если несколько систем или несколько процессов или потоков в одной системе генерируют значения в течение одной секунды; ObjectIdзначения не представляют строгий порядок вставки. Рассогласование часов между клиентами также может привести к нестрогому порядку даже для значений, поскольку клиентские драйверы генерируют ObjectIdзначения.
я бы добавил, не сложно отсортировать, но нужно учитывать где именно генерируется ObjectId и на сколько большая точность в очередности требуется
Артем
David
Артем
можно ещё использовать find update с upsert наверное