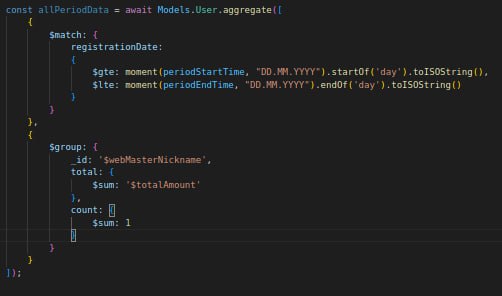
может фронт запрашивает
Наверное
 Constantin


 Ivan
 Vladyslav
 Constantin
 Constantin
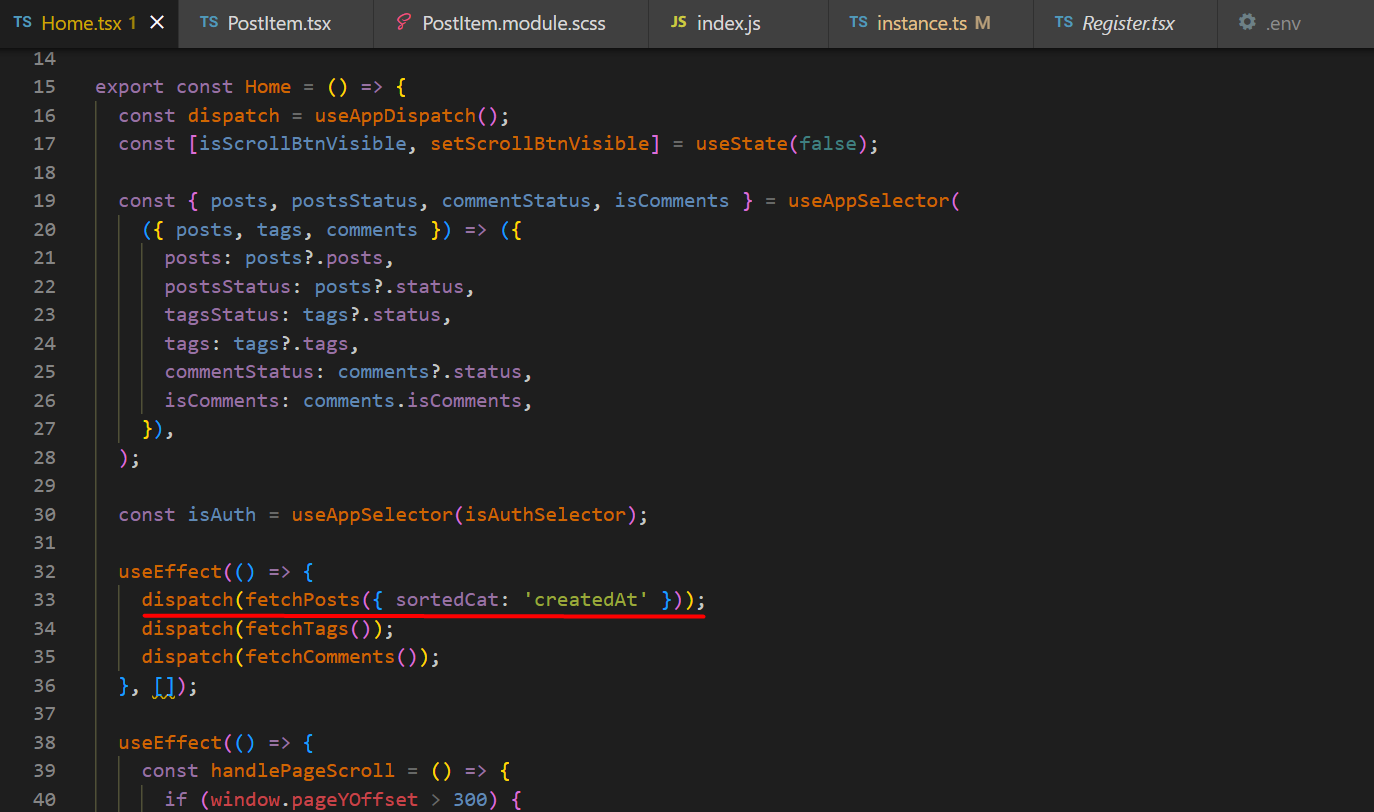 Constantin
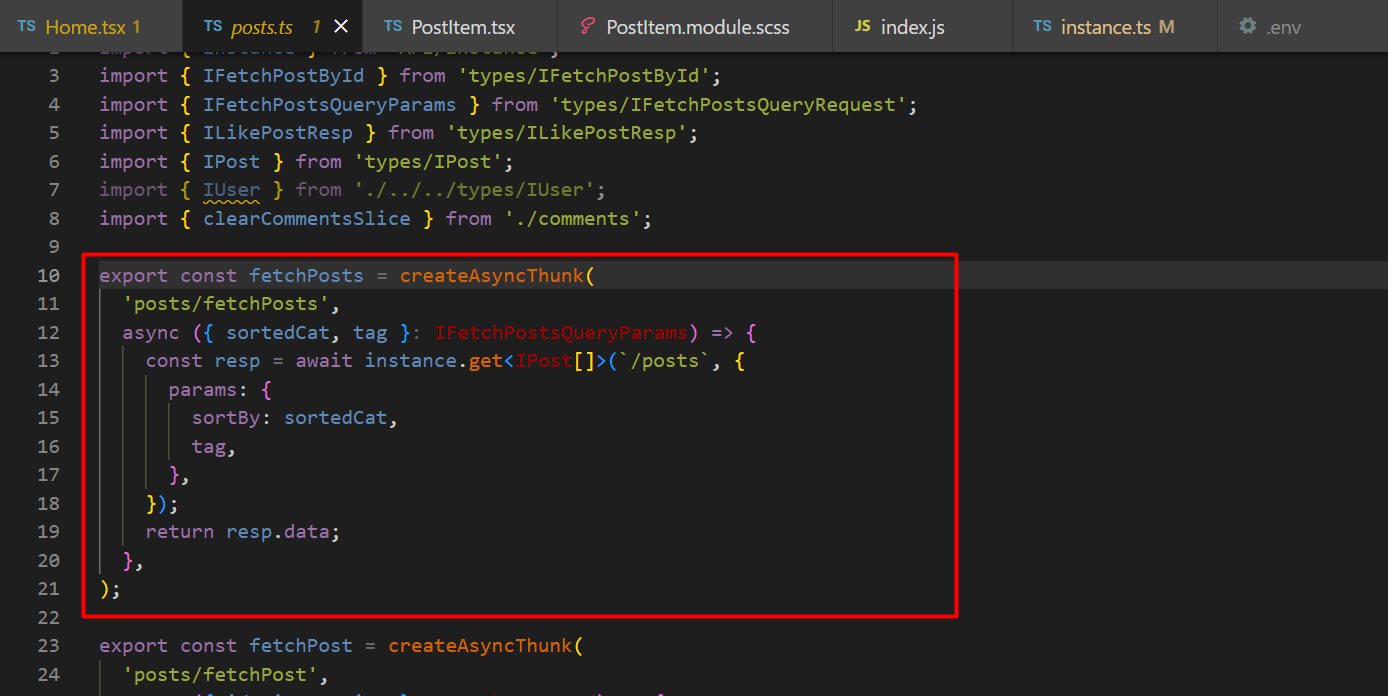 Constantin
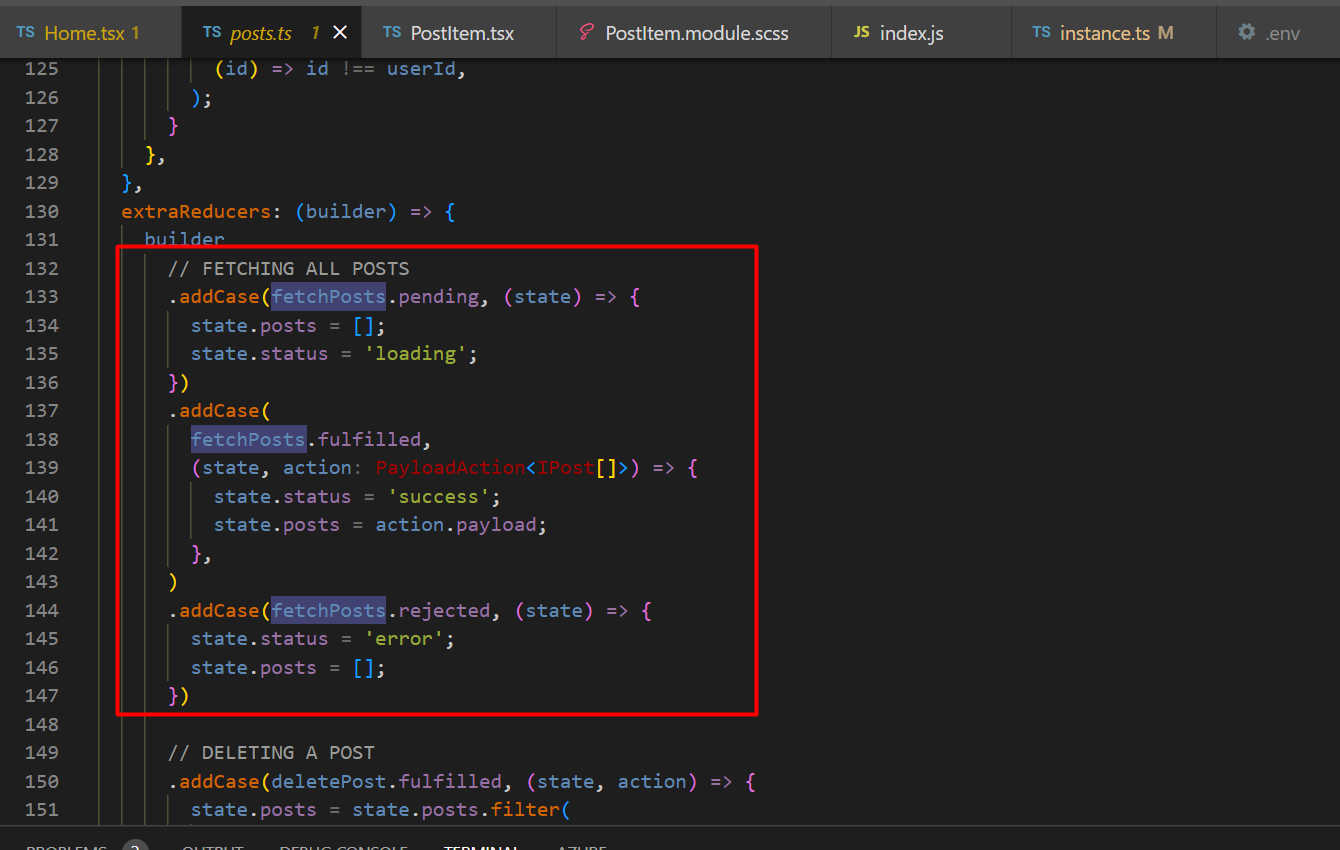 Constantin
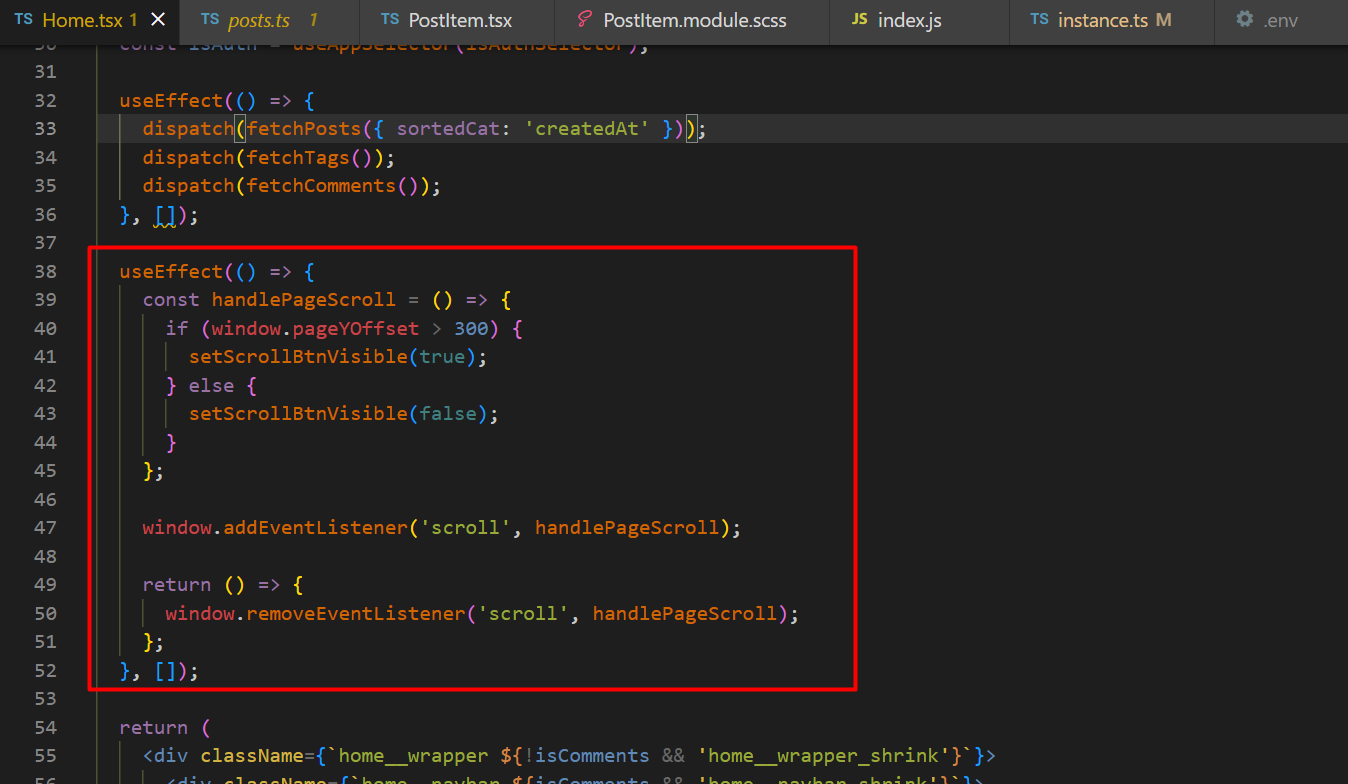 Vladyslav
 Александр
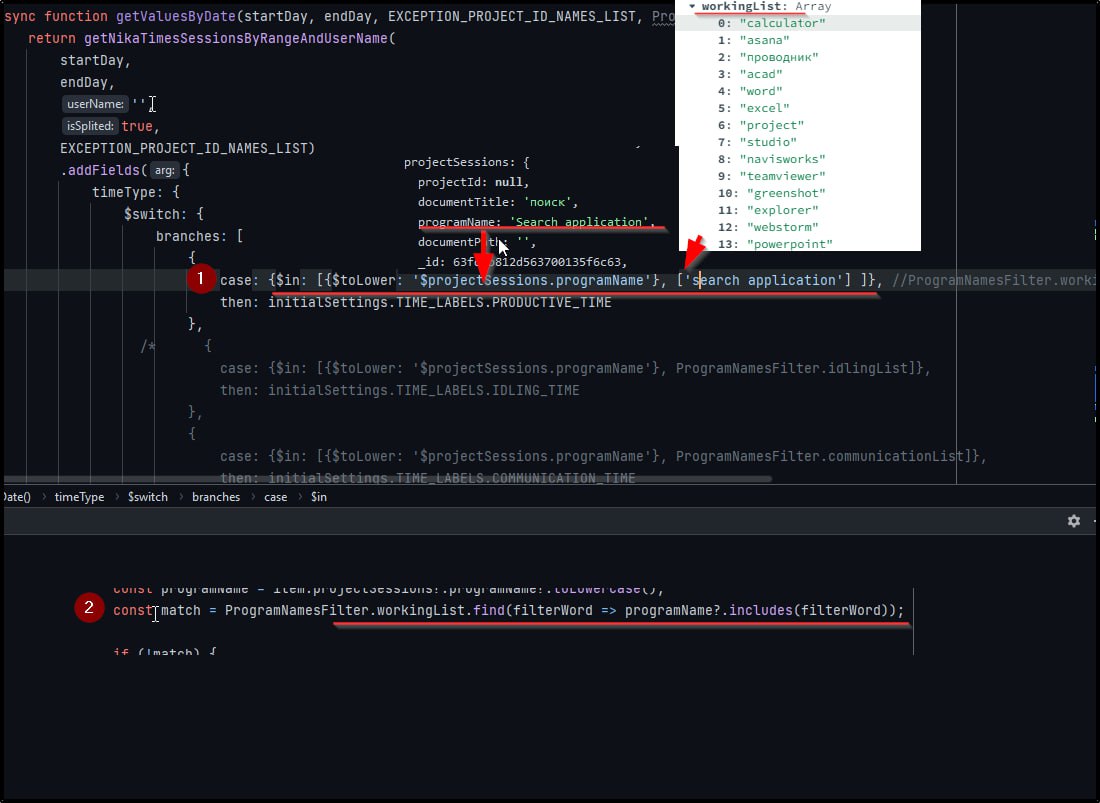
 Nick
Viktar
Подскажите, что это за слоу квери
{"t":{"$date":"2023-03-16T13:25:18.564+00:00"},"s":"I", "c":"COMMAND", "id":51803, "ctx":"conn1088","msg":"Slow query","attr":{"type":"command","ns":"catalog.$cmd","command":{"update":"personCatalog","ordered":false,"lsid":{"id":{"$uuid":"7e3f94d7-9d61-45f0-bb07-9283119390fd"}},"$db":"catalog"},"numYields":27,"reslen":60,"locks":{"ParallelBatchWriterMode":{"acquireCount":{"r":527}},"FeatureCompatibilityVersion":{"acquireCount":{"w":527}},"ReplicationStateTransition":{"acquireCount":{"w":527}},"Global":{"acquireCount":{"w":527}},"Database":{"acquireCount":{"w":527}},"Collection":{"acquireCount":{"w":527}},"Mutex":{"acquireCount":{"r":500}}},"flowControl":{"acquireCount":527,"timeAcquiringMicros":694},"storage":{"data":{"bytesRead":17663416,"timeReadingMicros":748776}},"remote":"10.124.0.7:48648","protocol":"op_msg","durationMillis":1429}}
Nick
Подскажите, что это за слоу квери
{"t":{"$date":"2023-03-16T13:25:18.564+00:00"},"s":"I", "c":"COMMAND", "id":51803, "ctx":"conn1088","msg":"Slow query","attr":{"type":"command","ns":"catalog.$cmd","command":{"update":"personCatalog","ordered":false,"lsid":{"id":{"$uuid":"7e3f94d7-9d61-45f0-bb07-9283119390fd"}},"$db":"catalog"},"numYields":27,"reslen":60,"locks":{"ParallelBatchWriterMode":{"acquireCount":{"r":527}},"FeatureCompatibilityVersion":{"acquireCount":{"w":527}},"ReplicationStateTransition":{"acquireCount":{"w":527}},"Global":{"acquireCount":{"w":527}},"Database":{"acquireCount":{"w":527}},"Collection":{"acquireCount":{"w":527}},"Mutex":{"acquireCount":{"r":500}}},"flowControl":{"acquireCount":527,"timeAcquiringMicros":694},"storage":{"data":{"bytesRead":17663416,"timeReadingMicros":748776}},"remote":"10.124.0.7:48648","protocol":"op_msg","durationMillis":1429}}
"command":{"update":"personCatalog","ordered":false,"lsid":{"id":{"$uuid":"7e3f94d7-9d61-45f0-bb07-9283119390fd"}},"$db":"catalog"}
Viktar
 Егор
Всем привет! Я провожу небольшой ресерч инструментов для полнотекстового поиска. Хотел бы задать несколько вопросов о работе с Mongo Text Search или elasticsearch. Буду рад, если напишете мне в лс
Dmitry
Air
Пытаюсь сделать
\mongoimport --mode merge --headerline --upsertFields code --db test --collection items --file C:\shoes.csv --type csv
Получаю ошибку
Failed: read error on entry #656458: line 656460, column 14: extraneous " in field
Получается в бд(не в .csv файлике) есть ошибка на 656460 строке? Как запросить эту строку чтоб посмотреть?
 Alexandrr
Пытаюсь сделать
\mongoimport --mode merge --headerline --upsertFields code --db test --collection items --file C:\shoes.csv --type csv
Получаю ошибку
Failed: read error on entry #656458: line 656460, column 14: extraneous " in field
Получается в бд(не в .csv файлике) есть ошибка на 656460 строке? Как запросить эту строку чтоб посмотреть?
Да, вероятнее всего ошибка возникла в строке 656460 в вашей базе данных MongoDB.
Вы можете запросить эту строку, чтобы просмотреть ее содержимое, используя команду db.collection.find() в MongoDB shell. Предположим, что вы хотите найти строку в коллекции items вашей базы данных test. Вот как это можно сделать:
Откройте MongoDB shell, введя команду mongo в командной строке вашей Linux системы.
Подключитесь к базе данных test, выполнив команду use test.
Выполните команду db.items.find().skip(656459).limit(1), чтобы найти строку с индексом 656460 (нумерация индексов в MongoDB начинается с 0).
Эта команда найдет строку в коллекции items, начиная с индекса 656459 и возвращающую только один результат.
Обратите внимание, что если вы не уверены, что ошибка находится в строке 656460, вам может потребоваться выполнить поиск по более широкому диапазону строк, чтобы найти ее местоположение.
Air
Да, вероятнее всего ошибка возникла в строке 656460 в вашей базе данных MongoDB.
Вы можете запросить эту строку, чтобы просмотреть ее содержимое, используя команду db.collection.find() в MongoDB shell. Предположим, что вы хотите найти строку в коллекции items вашей базы данных test. Вот как это можно сделать:
Откройте MongoDB shell, введя команду mongo в командной строке вашей Linux системы.
Подключитесь к базе данных test, выполнив команду use test.
Выполните команду db.items.find().skip(656459).limit(1), чтобы найти строку с индексом 656460 (нумерация индексов в MongoDB начинается с 0).
Эта команда найдет строку в коллекции items, начиная с индекса 656459 и возвращающую только один результат.
Обратите внимание, что если вы не уверены, что ошибка находится в строке 656460, вам может потребоваться выполнить поиск по более широкому диапазону строк, чтобы найти ее местоположение.
Спасибо за вывод по индексу 👍
Ошибку пока не нашел
И что означает column 14
Это вообще что
Я думал есть только line
Alexandrr
Спасибо за вывод по индексу 👍
Ошибку пока не нашел
И что означает column 14
Это вообще что
Я думал есть только line
ну если смотреть по разделителям .csv файла, то согласно них 16 колонка
Air
ну если смотреть по разделителям .csv файла, то согласно них 16 колонка
🤔
А то что я в начале файлика указал
code, name
Не означает что из должно быть всего 2
Alexandrr
Спасибо за вывод по индексу 👍
Ошибку пока не нашел
И что означает column 14
Это вообще что
Я думал есть только line
Строка column 14 означает, что ошибка произошла на 14-ом символе в 656460-ой строке.
Обычно, когда вы импортируете CSV-файл в MongoDB, MongoDB пытается разобрать каждую строку CSV-файла и сохранить ее как документ в коллекцию. Если строка имеет неправильный формат, MongoDB не сможет разобрать ее и вы получите ошибку импорта.
Как я уже упоминал, вероятнее всего, ошибка происходит из-за неправильно экранированных кавычек в CSV-файле. Вы можете попробовать проверить CSV-файл в текстовом редакторе и найти строку, содержащую кавычки, которые не были правильно экранированы.
Alexandrr
Нет, это не означает, что в каждой строке должно быть только два поля. Это означает, что первая строка CSV-файла содержит имена полей, которые будут использоваться в качестве ключей для значений в каждой последующей строке.
Каждая строка в CSV-файле может содержать любое количество полей, но каждое поле должно быть разделено запятой (или другим разделителем, если вы используете нестандартный разделитель). В вашем случае, каждая строка в файле C:\shoes.csv должна содержать два поля: code и name, разделенные запятой.
Пример строки в CSV-файле, который соответствует формату, заданному вами, может выглядеть так:
A001, Nike Air Max
Здесь A001 - значение поля code, а Nike Air Max - значение поля name.
Alexandrr
Оказывается, ошибку я не мог найти, потому что тупой 🤦♀
Спасибо
это кстати были не мои ответы, а чата-гопника))
Vik II
findOneAndUpdate. как сказать, если апдейт не произошло, то возвращать null ?
Alexandrr
findOneAndUpdate. как сказать, если апдейт не произошло, то возвращать null ?
В MongoDB, метод findOneAndUpdate() по умолчанию возвращает предыдущую версию документа, а не обновленную версию. Однако, если вы хотите, чтобы метод findOneAndUpdate() вернул null, если обновление не произошло, вы можете использовать опцию returnDocument и указать значение "after" вместо "before".
Например:
const filter = { _id: ObjectId("60d6b3c3c08b6f5c5fb9e6c4") };
const update = { $set: { name: "John Doe" } };
const options = { returnOriginal: false, returnDocument: "after" };
const result = await collection.findOneAndUpdate(filter, update, options);
if (result === null) {
console.log("Document not updated");
}
В этом примере, если обновление не произошло, то метод findOneAndUpdate() вернет null и выведется сообщение "Document not updated". Если обновление произошло, метод вернет обновленную версию документа.
pvlmrzv
Всем привет!
В компасе через агрегацию получил список id.
Как мне опять по коллекции пробежаться и на основании этого списка выбрать с доп фильтром данные?
Если это не через агрегацию мб через монго шел можно?
Потом эти записи нужно будет вообще удалить.
В какую сторону копать и где вообще лучше писать такие последовательные скрипты?
 Yury
Всем привет!
В компасе через агрегацию получил список id.
Как мне опять по коллекции пробежаться и на основании этого списка выбрать с доп фильтром данные?
Если это не через агрегацию мб через монго шел можно?
Потом эти записи нужно будет вообще удалить.
В какую сторону копать и где вообще лучше писать такие последовательные скрипты?
Создать еще одну новую агрегацию и туда скормить айдишники из первой?
pvlmrzv
Создать еще одну новую агрегацию и туда скормить айдишники из первой?
с этим я проде разобрался одной правильной агрегацией.
А как мне на удаление пробежаться по всем докам из агрегации?
этот финт можно то же в агрегации делать?
Alexandrr
А что если заюзать в options {new: true} вместо {return document: after}?
Если использовать опцию {new: true} вместо {returnDocument: "after"}, то результатом операции findOneAndUpdate() будет обновленный документ, а не документ до обновления, что соответствует опции {returnOriginal: false} в MongoDB. В этом случае, если обновления не произошло, будет возвращен пустой объект.
Constantin
Ну,то есть, если я правильно понял, то new true === return document after
Alexandrr
Всем привет!
В компасе через агрегацию получил список id.
Как мне опять по коллекции пробежаться и на основании этого списка выбрать с доп фильтром данные?
Если это не через агрегацию мб через монго шел можно?
Потом эти записи нужно будет вообще удалить.
В какую сторону копать и где вообще лучше писать такие последовательные скрипты?
Для выполнения всей последовательности операций в одном запросе мы можем использовать агрегационный фреймворк MongoDB. Вот пример запроса на языке MongoDB Query Language (MQL), который должен выполнить требуемые операции:
db.collection.aggregate([
// Сначала фильтруем документы по условию
{ $match: { field1: value1 } },
// Затем находим нужные id и сохраняем их в поле "ids"
{ $group: { _id: null, ids: { $push: "$_id" } } },
// Преобразуем массив id в объект для использования в следующем этапе
{ $project: { _id: 0, ids: 1 } },
{ $unwind: "$ids" },
{ $group: { _id: "$ids" } },
// Здесь мы можем добавить дополнительные операции, которые необходимо выполнить с выбранными документами, например, фильтрацию или изменение полей
{ $match: { field2: value2 } },
// Наконец, удаляем документы
{ $lookup: { from: "collection", localField: "_id", foreignField: "_id", as: "docs" } },
{ $unwind: "$docs" },
{ $replaceRoot: { newRoot: "$docs" } },
{ $out: "collection" }
])
В этом запросе мы сначала фильтруем документы по нужному условию, затем находим нужные id и сохраняем их в поле "ids", преобразуем массив id в объект, чтобы использовать его в следующем этапе, выбираем документы с нужными id, фильтруем их по дополнительному условию, и наконец удаляем выбранные документы.
Примечание: в запросе используется оператор $out, который удаляет выбранные документы и сохраняет результаты в новую коллекцию. Поэтому убедитесь, что вы используете этот оператор осторожно и только если уверены в том, что хотите удалить выбранные документы. Если вам нужно сохранить результаты в текущей коллекции, вы можете использовать оператор $merge вместо $out.
Alexandrr
Всем привет!
В компасе через агрегацию получил список id.
Как мне опять по коллекции пробежаться и на основании этого списка выбрать с доп фильтром данные?
Если это не через агрегацию мб через монго шел можно?
Потом эти записи нужно будет вообще удалить.
В какую сторону копать и где вообще лучше писать такие последовательные скрипты?
Вот пример решения на JavaScript с использованием функций aggregate и find из MongoDB Node.js Driver:
const ids = [ObjectId('id1'), ObjectId('id2'), ObjectId('id3')];
db.collection('myCollection').aggregate([
{ $match: { _id: { $in: ids } } },
{ $match: { someField: 'someValue' } }
]).toArray((err, results) => {
if (err) {
console.error(err);
} else {
db.collection('myCollection').deleteMany({ _id: { $in: ids } }, (err, result) => {
if (err) {
console.error(err);
} else {
console.log(`Deleted ${result.deletedCount} documents`);
}
});
}
});
Этот код получает список ids через агрегацию, затем выбирает все документы с этими ids и дополнительным фильтром по полю someField. После этого удаляет эти документы с помощью функции deleteMany.
Пожалуйста, замените 'myCollection' на имя вашей коллекции, а 'id1', 'id2', 'id3' на реальные идентификаторы документов.
pvlmrzv
да через фремворки я то же горазд код писать
pvlmrzv
мне интересно через шел напрямую
pvlmrzv
но все равно спасибо!
pvlmrzv
или я эт могу в шел запхать?
Alexandrr
мне интересно через шел напрямую
выполняющий всю операцию в одном запросе к СУБД MongoDB через Mongo Shell:
db.myCollection.deleteMany({
_id: {
$in: db.myCollection.aggregate([
{ $match: { someField: "someValue" } },
{ $group: { _id: null, ids: { $push: "$_id" } } },
{ $project: { _id: 0, ids: 1 } }
]).next().ids
}
});
Этот код найдет все документы в коллекции myCollection, удовлетворяющие условию { someField: "someValue" }, получит из них список _id через агрегацию, а затем удалит все документы с этими _id. Операция производится в одном запросе к СУБД, как требуется.
 Google
 Google
🆘
Vladyslav
Google
 Google
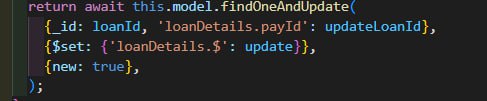
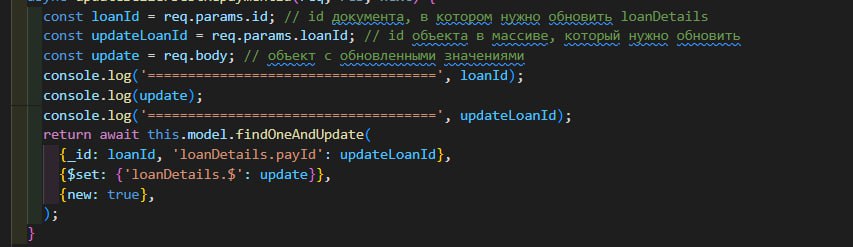
Вот весь function
Google
Object обновляется и пропадает который я не передаю на изменение как исправить ?
Google
{id: "77777", title: "help", status: false, desc: "inform"}
Google
{i status: true, desc: "sos"} Я передаю так
Alexandrr
Google
 Alexandrr
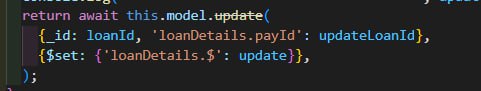
Он обновляет но который я не передаю на изменение в Object он пропадает
Это происходит из-за того, что $set: {'loanDetails.$': update} полностью заменяет массив loanDetails в документе на update. Если вы хотите обновить только определенные поля во вложенном объекте, вам нужно использовать операторы обновления для этих полей.
Google
Это происходит из-за того, что $set: {'loanDetails.$': update} полностью заменяет массив loanDetails в документе на update. Если вы хотите обновить только определенные поля во вложенном объекте, вам нужно использовать операторы обновления для этих полей.
я все пробовал есть пример как исправить ?
Google
Это происходит из-за того, что $set: {'loanDetails.$': update} полностью заменяет массив loanDetails в документе на update. Если вы хотите обновить только определенные поля во вложенном объекте, вам нужно использовать операторы обновления для этих полей.
{ $set: { "loanDetails.$.amount": update.amount } } так писать и обновить не получется потому что я могу передать другие параметры если не прописанно то обновление не будетже
Google
Решил проблему
 Mark
 Can
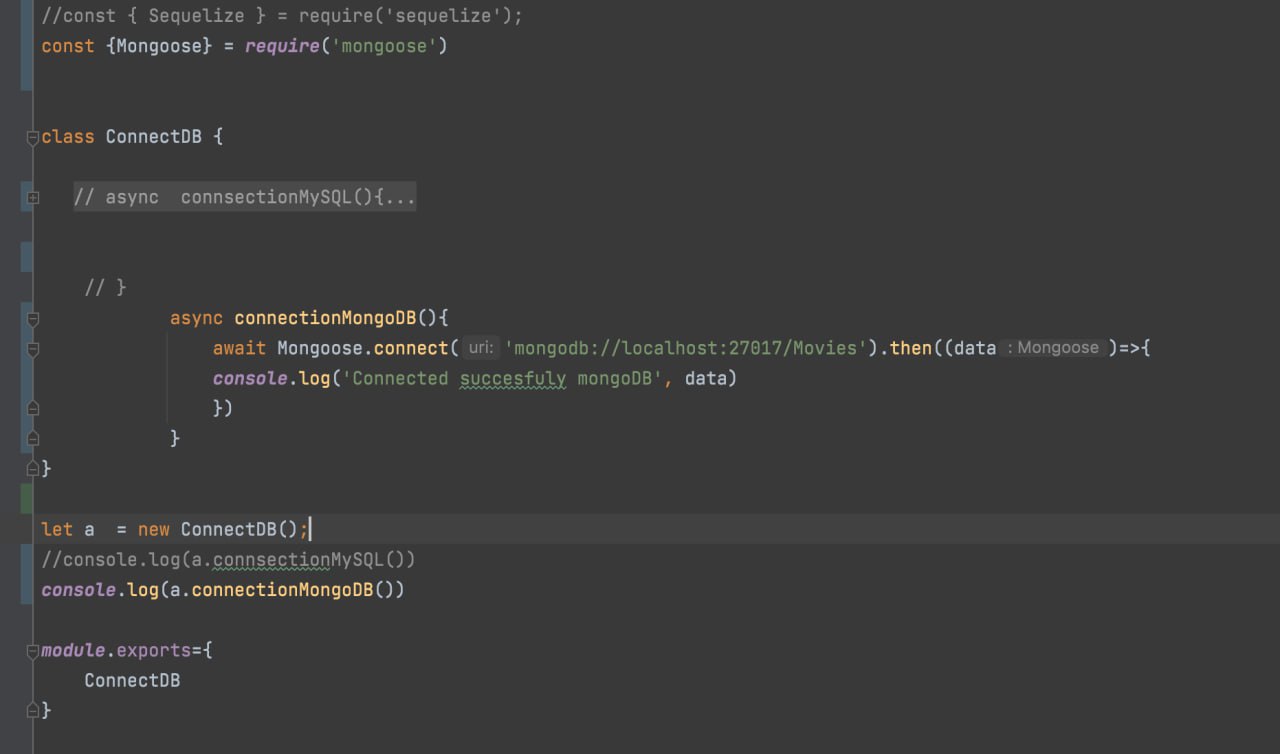
Здравствуйте всем.
Начал изучать mongodb и mongoose и столкнулся с такой проблемой:
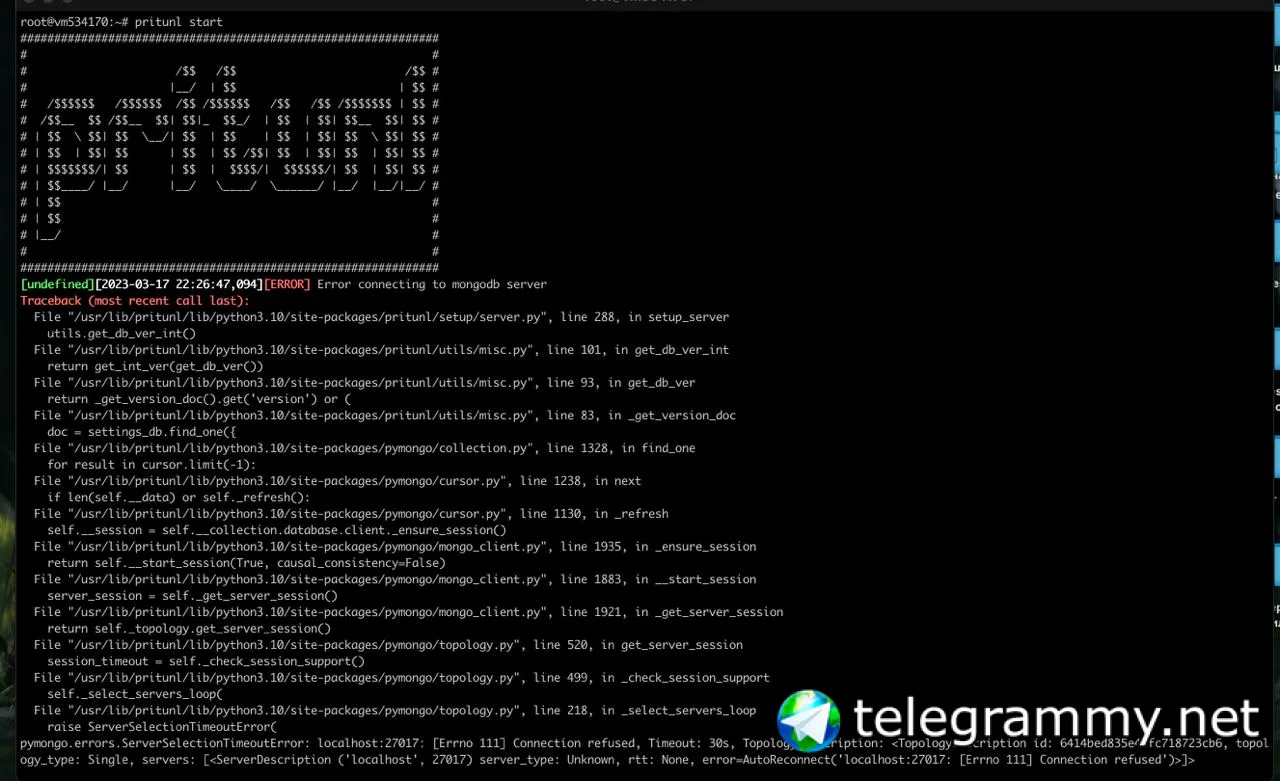
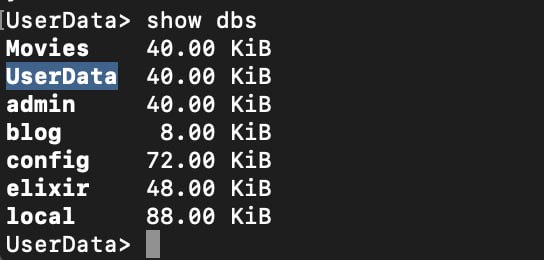
Не получается подключиться к БД через mongoose
выводит ошибку - TypeError: Mongoose.connect is not a function
В чем может быть проблема?
Can
 Can
 $heriF
Scorn
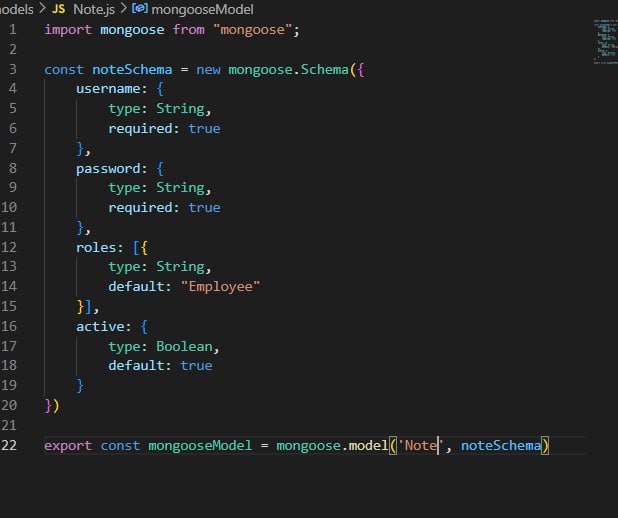
import*
Scorn
"type": "module"
Scorn
 Аскольд
аче
Anonymous
Привет! Хелпаните плиз за фин. вознаграждение (500р).
Документ:
{
...fields,
payload: {
ticks: [{v: Number, ts: Number}]
}
}
Задача:
1. Обновить в масиве subdoc поле "v" используя поиск по timestamp (ts), если сабдокумента нет, то добавить новый в массив "ticks". Желательно через updateOne
2. Сложность может быть, что в общем документе может не существовать "ticks" массива и тогда если делаем поиск <model>.updateOne({_id: <doc_id>, 'payload.ticks.ts': 1000000000}, { <что то тут> })
3. Если длина больше 20 значений в массиве, то обрезать все с конца, это наверное "$slice: -20" ?
Alexandrr
Привет! Хелпаните плиз за фин. вознаграждение (500р).
Документ:
{
...fields,
payload: {
ticks: [{v: Number, ts: Number}]
}
}
Задача:
1. Обновить в масиве subdoc поле "v" используя поиск по timestamp (ts), если сабдокумента нет, то добавить новый в массив "ticks". Желательно через updateOne
2. Сложность может быть, что в общем документе может не существовать "ticks" массива и тогда если делаем поиск <model>.updateOne({_id: <doc_id>, 'payload.ticks.ts': 1000000000}, { <что то тут> })
3. Если длина больше 20 значений в массиве, то обрезать все с конца, это наверное "$slice: -20" ?
для выполнения задачи с использованием одного запроса и учетом возможности отсутствия массива "ticks", можно использовать следующий запрос:
db.collection.updateOne(
{
_id: <doc_id>
},
{
$push: {
"payload.ticks": {
$cond: {
if: { $isArray: "$payload.ticks" },
then: {
$map: {
input: "$payload.ticks",
in: {
$cond: {
if: { $eq: ["$$this.ts", <timestamp>] },
then: { v: <new_value>, ts: <timestamp> },
else: "$$this"
}
}
}
},
else: [{ v: <new_value>, ts: <timestamp> }]
}
}
},
$slice: ["payload.ticks", -20]
},
{
upsert: true
}
);
Здесь мы сначала проверяем существование массива payload.ticks с помощью оператора $isArray. Если массив существует, то мы используем оператор $map для поиска сабдокумента по полю ts и обновления поля v. Если сабдокумент не найден, то он будет добавлен в массив. Если массив payload.ticks не существует, то мы создаем новый массив с одним элементом. Затем мы используем оператор $slice для обрезания массива до 20 элементов, если его длина превышает 20. И, наконец, мы добавляем опцию upsert: true, чтобы создавать новый документ, если его не существует.
 Artem