 Artem


супер большое спасибо
 Batyr
попробуйте toLong
https://www.mongodb.com/docs/manual/reference/operator/aggregation/toLong/
Сел почитать про лонги. Так оно же просто int64. Мне хотя бы uint256 нужен
Batyr
Кто-нибудь знает, как внутри $cond в поле then\else получить и отредактировать string поле из таблицы? Я хочу строку в бигинты перевести для перемножения
Может есть способ встроить в aggregation запрос кастомную функцию, которая бы имела доступ к переменным из запроса?
upd. Нашел $function, но ее на js писать(
Batyr
У меня имеется вот такая запись документов:
type Object struct {
Id string `json:"id" bson:"_id"`
Arr []Arr `json:"arr" bson:"arr"`
}
type Arr struct {
Multiplier int64 `json:"mul" bson:"mul"`
Amount string `json:"amount" bson:"amount"`
}
В Arr я добавляю две записи: arr[0] и arr[1]
Я хочу агрегировать список Object по новому полю Value, перемножив Amount на значение в поле Multiplier.
Какая проблема: в Amount у меня хранятся бигинты в строковом виде.
Мне нужно как-то провернуть операцию умножения над строкой. Кто сталкивался с подобным или знает как решить это?
P.S. По итогу Value получится тоже строковым значением (биг интом), мне потом как-то надо будет сделать сортировку по нему 😖
P.P.S. Я планирую проводить эту агрегацию не чаще пары раз в день, поэтому эффективность кода особо не имеет значения.
P.P.S. Поразмыслив часик другой, прихожу к выводу, что внутри запроса к монго мне это не сделать. Попробую выгрузить в память и покрутить уже за пределами монги. Но если кто-то найдет решение, буду рад изучить.
 yopp
Тогда математика будет доступна в самой монге
 Nick
Ох уж эта крипта с их суперчислами)
Batyr
Однако, если вы знаете что числа хоть и 256бит, но они укладываются в обычные 64 то надо всеголишь поконверить
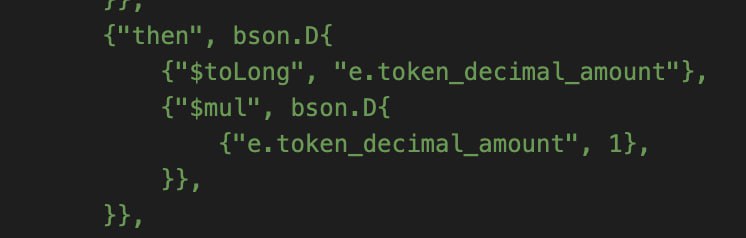
Не знаете, есть ли возможность сконвертить поле внутри then?
Nick
Не знаете, есть ли возможность сконвертить поле внутри then?
приходит в голову только использование регулярки для отрезания нулей лидирующих и дальше уже туЛонг
Batyr
приходит в голову только использование регулярки для отрезания нулей лидирующих и дальше уже туЛонг
 Nick
но кажется что это не будет быстрее, чем один раз перестроить все доки и вытащить числовые значения если уместятся в децимал128 или даже в обычные 64бита лонга
 dima shumov
Вопрос на засыпку - как mongodump из коллекции размером 1.35гб
сделал bson в 10гб?
Nick
Вопрос на засыпку - как mongodump из коллекции размером 1.35гб
сделал bson в 10гб?
в монге данные жмутся для хранения на диск snappy алгоритмом по умлочанию. Сделайте дамп с gzip ключом
 Alexandrr
Ох уж эта крипта с их суперчислами)
есть много и других бесполезных источников траты ресурсов)
Nick
есть много и других бесполезных источников траты ресурсов)
но в этих источниках не нужно ломать голову как работать с 256битным числом, а тут хотя бы разминка для мозга
Alexandrr
но в этих источниках не нужно ломать голову как работать с 256битным числом, а тут хотя бы разминка для мозга
я уже писал про астрофизику и времяисчисление в ней)
с числами тоже самое там
 Alexander
Подскажите, после $replaceRoot индексы вообще используются? Имеет ли смысл при такой аггрегации индексировать a и b?
[{
"$match": {
"x": {
"$lte": 100
}
}
}, {
"$sort": {
"x": -1
}
}, {
"$group": {
"_id": {
"y": "$y",
"z": "$z"
},
"r": {
"$first": "$$CURRENT"
}
}
}, {
"$replaceRoot": {
"newRoot": "$r"
}
}, {
"$match": {
"a": true,
"b": "value"
}
}
]
Если кто-то зарегистрирован, можно ответить на StackOverflow.
 Air
Сейчас в коллекции 5 млн документов
В документе по 3 поля
Нормально если увеличить до 30 полей в документах? Это не будет влиять на скорость поиска по индекс полю?
Air
Эти данные используются на 2 страницах
В одном нужны всё те же 3 поля
Во втором все 30
Не будет ли от этого страдать скорость прогрузки первой страницы
yopp
Сейчас в коллекции 5 млн документов
В документе по 3 поля
Нормально если увеличить до 30 полей в документах? Это не будет влиять на скорость поиска по индекс полю?
Нет, скорость поиска по индексу не зависит от размера документов
Андрей
Сейчас в коллекции 5 млн документов
В документе по 3 поля
Нормально если увеличить до 30 полей в документах? Это не будет влиять на скорость поиска по индекс полю?
У меня были доки по 180+ полей и их было миллиарды. Всё зависит от вашей логики.
 Aleksandr
Привет, кто-то работал с могоДБ? нужно помощь, не могу разобраться.
Viktar
Привет, кто-то работал с могоДБ? нужно помощь, не могу разобраться.
Вы расскажите какая у вас проблема. Если кто то сталкивался, вам помогут
Aleksandr
Есть база, работает с кейстон, сейчас нужно подключиться на прямую, и обновить скриптом некоторые данные.
Aleksandr
Не могу подключиться и получить коллекцию.
Aleksandr
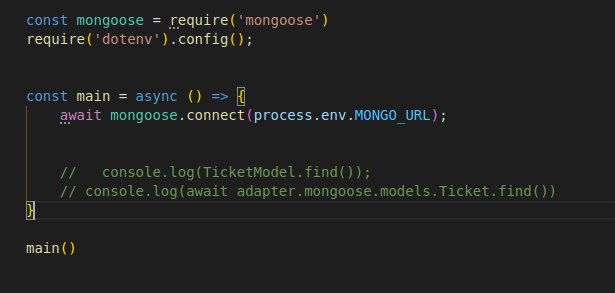 Aleksandr
не пойму как к коллекции подключиться.
Aleksandr
Не работал с монгой.
Aleksandr
нужно получить коллекции, или модели, не создавать их, а уже те что есть.
Aleksandr
Подскажете, как это правильно сделать, а то даже в документации написано, как создавать, а потом пользоваться.
Viktar
Коллекция создаётся автоматически, если вы в неё что то записываете. Я так понимаю у вас нет проблем с подключением. А вы не знаете как прочитать данные
Aleksandr
да
Viktar
Тогда покажите, что именно у вас не получается.
Aleksandr
Ну я сделал конешин, к базе подключился. Как мне получить коллекию?
Kenya-West
Как же я замотался, культурно говоря, переносить типы из библиотеки Baileys в схемы Mongoose… два дня этим сексом занимаюсь
А есть какой-то, скажем, автокомпилятор схем Mongoose из типов TypeScript? На основе reflect-metadata или просто до компиляции, лишь бы TS не ругался...
Alexandrr
Ну я сделал конешин, к базе подключился. Как мне получить коллекию?
connect. get_collection()
Nick
У меня были доки по 180+ полей и их было миллиарды. Всё зависит от вашей логики.
а не расскажите для чего потребовалось столько полей?
Alexandrr
а не расскажите для чего потребовалось столько полей?
я думаю настройки профиля какие-нибудь
Андрей
а не расскажите для чего потребовалось столько полей?
Банковские выписки собираюсь увезти из HBase в монгу и потестировать. Там 300+ полей в общем по спекам, но они все одновременно не присутствуют в каждой записи, конечно же 😉
Nick
Банковские выписки собираюсь увезти из HBase в монгу и потестировать. Там 300+ полей в общем по спекам, но они все одновременно не присутствуют в каждой записи, конечно же 😉
просто для долговременного для хранения или аналитику хотите строить?
Андрей
просто для долговременного для хранения или аналитику хотите строить?
На постоянку уехать с хадупа вообще хочу.
Андрей
Оно используется по факту как любая транзакционка по нагрузке
Андрей
Просто специфика сканирований по префиксу ключа и засканить например условные 5 записей в пределах месяца.
Андрей
Ну нафиг для такого хадуп держать? Вот я и педалю съезд во что-то вменяемое.
Nick
Оно используется по факту как любая транзакционка по нагрузке
просто для олап задач с рендомными анлитическими запросами будет жестковато. А олтп в самый раз
Андрей
Тем более в монге это и весить будет меньше в ZSTD, будет бегать по XFS хорошо, чтение уедет на стэндбаи, дампы будут быстрее делаться, никаких тебе компактов, которые просаживают производительность, никаких разъездов локалити по регионам из-за отвала нод и т.д. и т.п. всего хадуповского говна, от которого я уже рыгать скоро начну.
Alexandrr
Банковские выписки собираюсь увезти из HBase в монгу и потестировать. Там 300+ полей в общем по спекам, но они все одновременно не присутствуют в каждой записи, конечно же 😉
так всё-таки, сколько полей, 180+ или 300+?
Андрей
300+ это по спекам проекта
Андрей
HBase же схемалэс
Batyr
 Alexander
Batyr
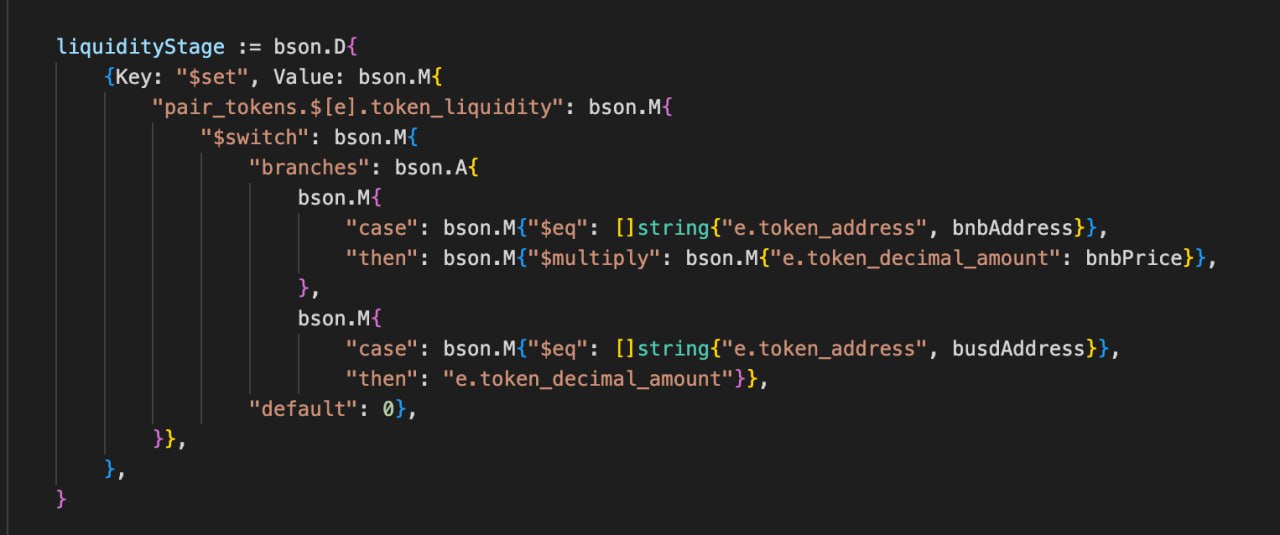
А что за ошибка?
(Location16410) Invalid $set :: caused by :: FieldPath field names may not start with '$'. Consider using $getField or $setField.
Batyr
Но исправление ничего не даст
(Location40324) Unrecognized pipeline stage name: '$setField'
Alexander
Alexander
У вас имя поля начинается с $. Скорее всего из-за этого $[е]
Batyr
У вас имя поля начинается с $. Скорее всего из-за этого $[е]
Не (только) из-за этого, далее будет ругаться на .
Я уже по-разному перепробовал. Мне бы помощь, кто точно знает в чем тут проблема
Alexander
Не (только) из-за этого, далее будет ругаться на .
Я уже по-разному перепробовал. Мне бы помощь, кто точно знает в чем тут проблема
Попробуйте в mongo compass построить запрос и экспортировать его в Go
Air
const item = await collection.find({name: new RegExp(name, 'i')}).toArray();
сейчас таким образом делаю поиск по string по 5млн записям
прогрузка результата занимает около 10-13 секунд
индекс name_1 добавил
как можно ускорить?
Nick
Nick
тогда никак
Nick
точнее дальше уход на нормальные поисковые движки. Можно еще извращатсья и реализовывать похожее в монге
 Igor
Ребят подскажите можно ли отобрать документы за конкретную дату, дата хранится в ISOdate как я понял, когда отбираю больше\меньше все работает:
"$match": {"createDate": {
"$gte": datetime.datetime(2022, 12, 1),
"$lt": datetime.datetime(2022, 12, 2)
}}
А когда пишу условие eq то не работает
"$match": {"createDate": {
"$eq": datetime.datetime(2022, 12, 1)
}}
Это в питоне.
Igor
Через компасс - { "createDate": {$eq: new Date('2023-01-01')} } - не отбирает не какие записи
Sunrise
Подскажите, пытаюсь в голове набросать структуру бд. цель - реализация чатов.
сабж в организации комнат и хранении сообщений, как себе представляю, будет коллекция Chats , в которой содержатся комнаты чатов, внутри: id комнаты, id участников, сообщения из этой комнаты.
Верный ли подход?
Alexandrr
Alexandrr
Ребят подскажите можно ли отобрать документы за конкретную дату, дата хранится в ISOdate как я понял, когда отбираю больше\меньше все работает:
"$match": {"createDate": {
"$gte": datetime.datetime(2022, 12, 1),
"$lt": datetime.datetime(2022, 12, 2)
}}
А когда пишу условие eq то не работает
"$match": {"createDate": {
"$eq": datetime.datetime(2022, 12, 1)
}}
Это в питоне.
там надо импортировать .utc(), что бы формат даты подходил, почитайте стандарт iso-date
Igor
там надо импортировать .utc(), что бы формат даты подходил, почитайте стандарт iso-date
Блин странно просто на больше меньше работает все ок
Air
тестовый индекс использовать
Ещё быстрее можно сделать? Или это у меня прогрузка медленная а монго отдает свой максимум
Alexandrr
Ещё быстрее можно сделать? Или это у меня прогрузка медленная а монго отдает свой максимум
ну тестовый индекс будет за сотые секунды отдавать результат, если строки не слишком длинные, не длиннее 1к символов, потом производительность резко падает, мне так тесты показали.
дело в том, что все, в том числе эластики всякие и полнотекстовый поиск монги используют под капотом жабий lucene.
так что не особо важно, где тестировать полнотекстовый поиск, результаты скорости будут одинаковые, только эластик сильнее интегрирован с люсей
Nick
Ребят подскажите можно ли отобрать документы за конкретную дату, дата хранится в ISOdate как я понял, когда отбираю больше\меньше все работает:
"$match": {"createDate": {
"$gte": datetime.datetime(2022, 12, 1),
"$lt": datetime.datetime(2022, 12, 2)
}}
А когда пишу условие eq то не работает
"$match": {"createDate": {
"$eq": datetime.datetime(2022, 12, 1)
}}
Это в питоне.
в базе именно даты у документов или дата со временем?
Igor
в базе именно даты у документов или дата со временем?
Вот такой формат = 2023-03-06T04:31:55.972Z, я так понимаю из-за этого не может отобрать на равно
Nick
Вот такой формат = 2023-03-06T04:31:55.972Z, я так понимаю из-за этого не может отобрать на равно
так при $eq идет полное совпадение, т.е. время полночь для сравнения просто даты
Alexandrr
Вот такой формат = 2023-03-06T04:31:55.972Z, я так понимаю из-за этого не может отобрать на равно
дело в десятитысячных скорее всего