 Artem


хотя должен вывести Клиент
 Nick
если только по началу, то это для регулярок задача. Фултекст в монге очень ограниченный и покрывает только поиск по полным словам в разных словоформах
Artem
так он у меня не чего не выводит
Artem
только когда я полностью напишу
Nick
поведение ровно как я и описал
Nick
если вам надо поиск по частям слов, то это в регулярки $regex или в облачную монгу где атлас серч это поддерживает, ну или ставить рядом чтото нормальное для фултекста
Artem
понял, спасибо большое)
Nick
то есть использование на локалях это бесполезно?
локали лишь позволяют корректно побить предложения на слова с учетом алфавитов и правильно выделить основы словоформ (поглужбже можно прочитать про stepping)
Artem
Спасибо огромное) тогда дальше буду разбираться
Nick
Всем привет. Подскажите, пожалуйста, кто-то пробовал FerretDB https://www.ferretdb.io/ как альтернативу MongoDB. Если да, то поделитесь фидбеком, как работает, какие подводные камни есть, есть ли возможность переехать из MongoDВ в FerretDB без существенных доработок?
и судя по открытым ишью на гитхабе там далеко не полностью поддерживаются агрегации, тот же $sort запилили только (https://github.com/FerretDB/FerretDB/issues/1917). И баги в наличии в реализации, так что еще годик подождать придется до возможности "просто переключиться"
Artem
 Artem
в чем проблема не понятно
Artem
хотя в документации
Artem
написанно так
Artem
и без массива пробовал
Artem
указывал просто locale: 'ru'
Artem
извиняюсь не @nick, а @yatoba
Nick
указывал просто locale: 'ru'
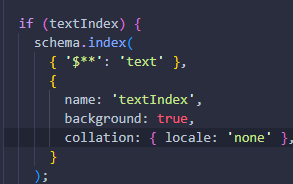
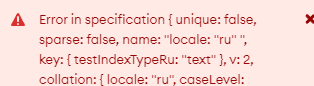
в ошибке указывается по другому, как вы создаете индекс? через что
Artem
 Artem
@yatoba , создаю в коде проекта
Artem
 Artem
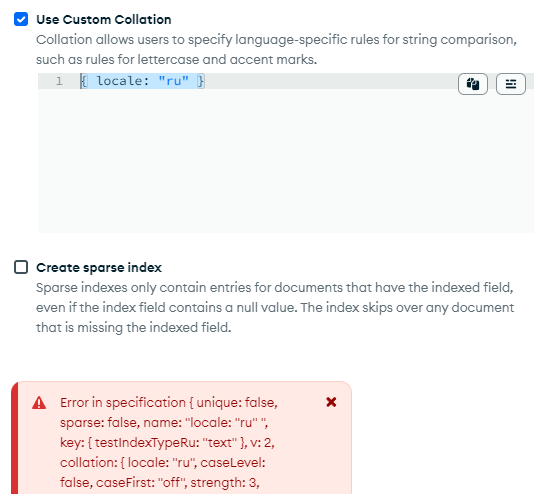
это если создаю через compass
Artem
 Artem
Но в compass не особо важно
Artem
самое главное в коде
Nick
в коде - вопросы к монгусу, чтото там наверчено значит. В компасе тоже чтото свое, не ясно зачем передавать дефолтные параметры
Artem
Хм, спасибо)
Nick
хотя очень странное "backwards: false, version: "57.1""
Artem
а с чем это может быть связанно
Nick
а с чем это может быть связанно
с тем что не используется нормальное создание коллекций с помощью скриптов и монгошела
 Air
const mongoClient = new MongoClient("mongodb://test:password@192.168.5.70:27017/?tls=false&authMechanism=DEFAULT&authSource=test");
$MONGO_USER = test
как мне в подключении заменить username на переменную и нужно ли подключить какой-нибудь пакет в nodejs?
const mongoClient = new MongoClient(`mongodb://${MONGO_USER}:password@192.168.5.70:27017/?tls=false&authMechanism=DEFAULT&authSource=test`);
начало так должно быть?
Nick
const mongoClient = new MongoClient("mongodb://test:password@192.168.5.70:27017/?tls=false&authMechanism=DEFAULT&authSource=test");
$MONGO_USER = test
как мне в подключении заменить username на переменную и нужно ли подключить какой-нибудь пакет в nodejs?
const mongoClient = new MongoClient(`mongodb://${MONGO_USER}:password@192.168.5.70:27017/?tls=false&authMechanism=DEFAULT&authSource=test`);
начало так должно быть?
да типа такого, либо полностью строку выносите в переменные и тот же env, либо отдельно юзер и пароль и собираете при формирвоании монго клиента
Air
да типа такого, либо полностью строку выносите в переменные и тот же env, либо отдельно юзер и пароль и собираете при формирвоании монго клиента
Получается есть разница между process.env.MONGO_USER (nodejs) и ${MONGO_USER}?
Nick
Получается есть разница между process.env.MONGO_USER (nodejs) и ${MONGO_USER}?
тут не спец, может кто другой скажет, ну или можете протестить
Air
тут не спец, может кто другой скажет, ну или можете протестить
В этом проблема что не могу потестить 🥲
По process.env синтаксис и откуда берётся могу понять
Nick
чет вспомнил даже, у вас должна быть объявлена переменная в коде MONGO_USER и используются апострофы для формирвоания строки из енва оно не подтянется само
 Artem
 Artem
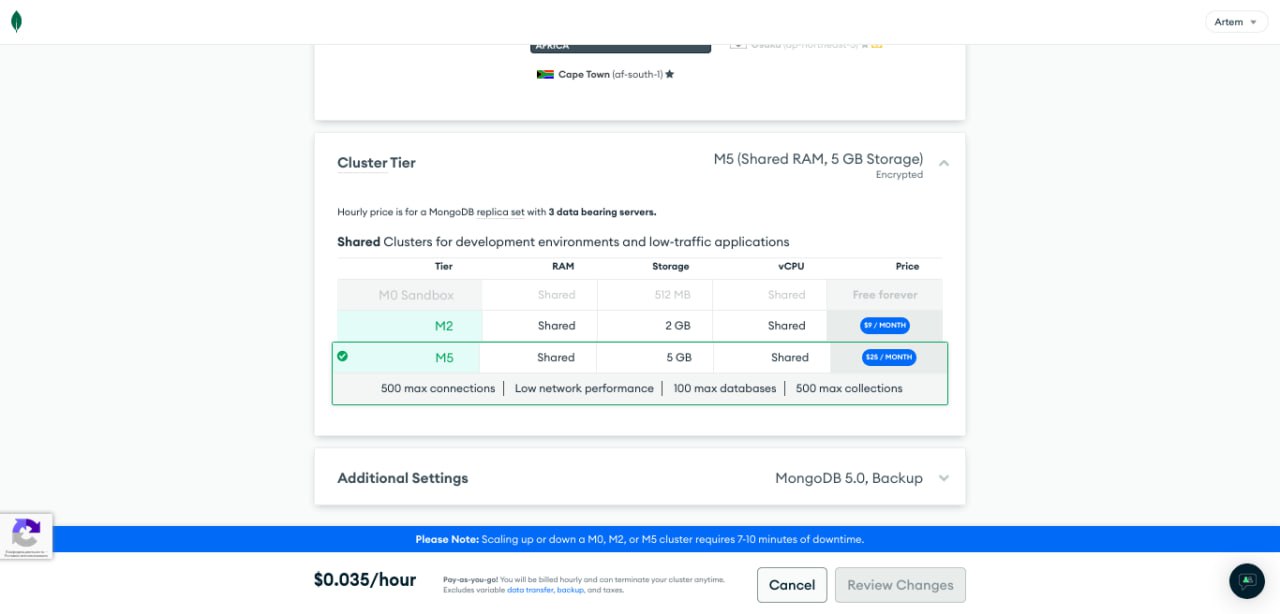
потому что замечаю что проскакивают недолёты данных до самой нагруженной коллекции, грешу на бесплатную базу
 Alexandrr
Anonymous
 Artem
оформите лучше тут корректно подработку и пусть вам специалист по монго сделает правильно, качественно и быстро работу
дак мне просто сказать какой-то бюджетный тариф) те кто хоть раз покупал базу должны шарить
Viktar
почему запрос по ИД попадает в слоу квери, хотя это должно быть быстро
{"t":{"$date":"2023-03-02T13:22:19.600+00:00"},"s":"I", "c":"COMMAND", "id":51803, "ctx":"conn29052","msg":"Slow query","attr":{"type":"command","ns":"catalog.personCatalog","command":{"find":"personCatalog","filter":{"_id":{"$oid":"563aa50ea219445d52dadd74"}},"limit":1,"$db":"catalog","$readPreference":{"mode":"nearest"},"lsid":{"id":{"$uuid":"8a41f2fd-18ce-48cc-9a50-6736df56c72b"}},"$clusterTime":{"clusterTime":{"$timestamp":{"t":1677763335,"i":1}},"signature":{"hash":{"$binary":{"base64":"OoWPRj+iTcXg71FB0egDG7qJGt8=","subType":"0"}},"keyId":7203737749801664516}}},"planSummary":"IDHACK","keysExamined":1,"docsExamined":1,"cursorExhausted":true,"numYields":1,"nreturned":1,"queryHash":"740C02B0","queryFramework":"classic","reslen":9615,"locks":{"FeatureCompatibilityVersion":{"acquireCount":{"r":2}},"Global":{"acquireCount":{"r":2}},"Mutex":{"acquireCount":{"r":1}}},"readConcern":{"level":"local","provenance":"implicitDefault"},"storage":{"data":{"bytesRead":135333,"timeReadingMicros":116910}},"remote":"10.124.0.37:41054","protocol":"op_msg","durationMillis":117}}
Viktar
не совсем вас понял
Viktar
это запись из лога монги.
 yopp
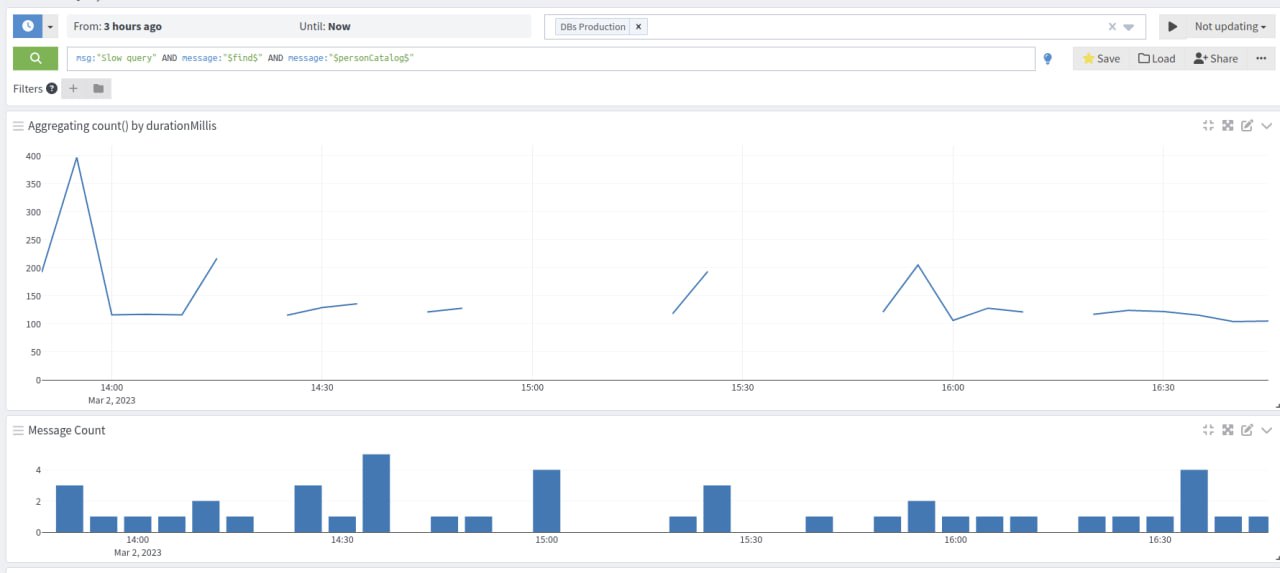
постоянно. судя по графику, то нет закономерности.
А с какой частотой? Раз в день, в час, в минуту? :)
 Viktar
в среднем раз в полчаса
yopp
Судя по 116мс в timeReading, причину стоит искать в районе пропускной способности диска
Viktar
загрузка не большая. в пиках доходит до 15%
yopp
загрузка не большая. в пиках доходит до 15%
Лучше смотреть на latency и queue depth, «загрузка диска» это совсем архаичный попугай который несет очень мало смысла
Viktar
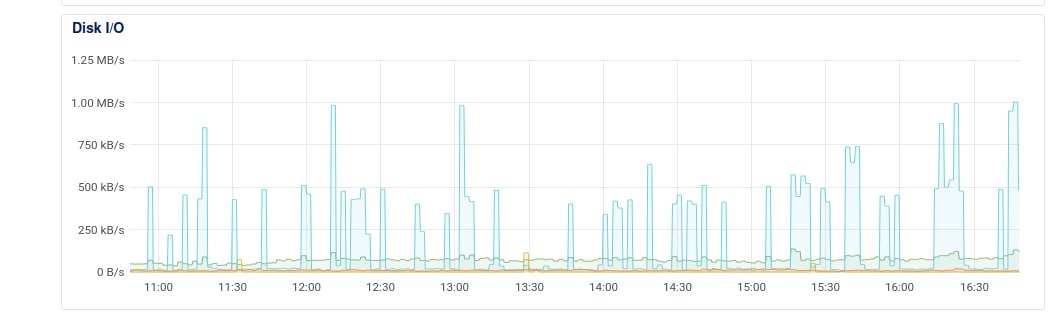 yopp
Плюс если индекс требует чтения с диска, то у вас вероятно не хватает памяти под горячие данные
Viktar
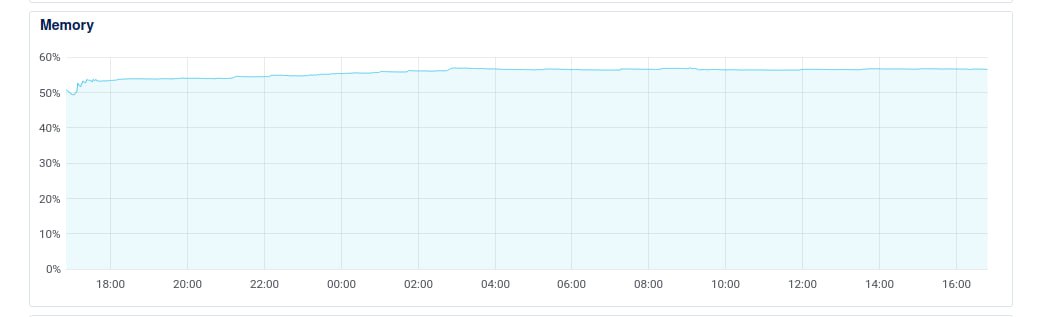 Viktar
памяти тоже хватает
Viktar
80% стоит использование в конфиге
yopp
Viktar
Не совпадают временные отметки, но кажется что есть корреляция между пиками синего (чтение?) и медленными запросами
Я накладывал по точному времени. Частично совпадают.
yopp
Viktar
Есть ли у вас сбор метрик из монги?
Нет. С монги только логи собираем на анализ медленных запросов
Viktar
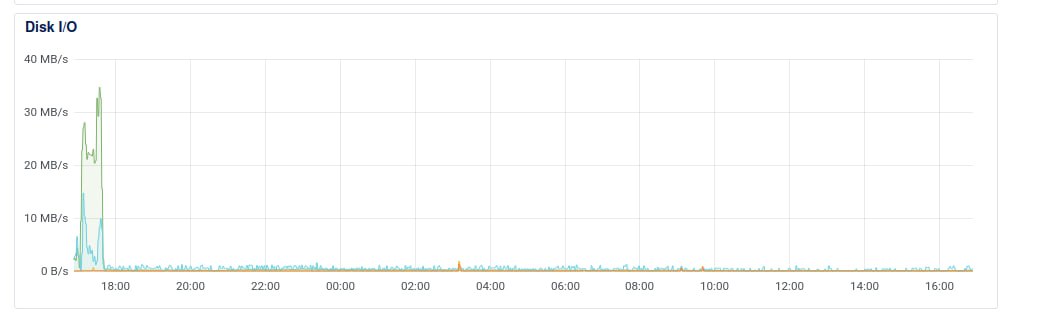 Viktar
это за 24 часа
yopp
Вероятнее всего у вас cache trashing: горячие данные не влазят в кеш и идет постоянное вытеснение из кеша «старых» и чтение в кеш данных для обработки запросов
yopp
Если у вас есть возможность собрать телеметрию с монги, то вас интересует wiredtiger cache evicted pages
yopp
Плюс cache read in
Viktar
Спасибо, попробую в эту сторону покапать
yopp
Если много вытеснений и большой поток чтений, то вероятнее всего вам нужно больше памяти.
Напомню что размер кеша через конфиг монги устанавливать больше чем на 50% приводит к тому что в память помещается меньше данных, а не больше :)
yopp
В кеше самой монги данные лежат без компрессии, по этому увеличение размера кеша монги уменьшает доступную «свободную» память которую ОС отдает под дисковый кеш.
А вот в дисковом кеше данные уже сжаты выбранным алгоритмом
 Личность
подскажите пожалуйста , у меня есть курс , он в себе содержит имя , разделы курса, материалы курса и файлы . Как мне хранить это в бд, хранить все в одной таблице или же разделы, материалы и файлы разнести в разные таблицы ?
 Alexander
А зачем их отделять? В отдельную коллекцию?
Alexander
Ну я по этому и спросил как лучше сделать .
Это зависит от того, что вы в дальнейшем будете делать с этим. Как часто будет неободимость работать с фаайлами из рахных курсов. Насколько часто курсы будут иметь одинаковые файлы. И т.д. Исходя из описанния я не вижу причин разделять на 2 коллекции.
yopp
подскажите пожалуйста , у меня есть курс , он в себе содержит имя , разделы курса, материалы курса и файлы . Как мне хранить это в бд, хранить все в одной таблице или же разделы, материалы и файлы разнести в разные таблицы ?
Если разделы курса это отдельная сущность, которая может быть использована без информации о самом курсе, то есть смысл выделить их в отдельную коллекцию
Viktar