отдельный тред удаляет данные, если память не изменяет, то раз в минуту. он выбирает документы у которых значение поля по которому построен TTL индекс, равно или больше текущего времени + значения expireAfterSeconds.
Если сделать дамп, а потом его загрузить обратно, то если дата + expireAfterSeconds будет в прошлом, то тред начнёт удалять документы
спасибо, это и нужно было узнать, а то в доке написано, что тред, но не понятна его логика работы при восстановлении из дампа, получается, она не меняется и идёт такое же сравнение.
а где прочесть про "1 минуту"?
а то для меня 1 минута критична...
 Alexandrr


 Dmitry
спасибо, это и нужно было узнать, а то в доке написано, что тред, но не понятна его логика работы при восстановлении из дампа, получается, она не меняется и идёт такое же сравнение.
а где прочесть про "1 минуту"?
а то для меня 1 минута критична...
https://www.mongodb.com/docs/manual/core/index-ttl/#:~:text=documents%20runs%20every-,60%20seconds,-.%20As%20a%20result
 yopp
спасибо, это и нужно было узнать, а то в доке написано, что тред, но не понятна его логика работы при восстановлении из дампа, получается, она не меняется и идёт такое же сравнение.
а где прочесть про "1 минуту"?
а то для меня 1 минута критична...
https://github.com/mongodb/mongo/blob/1e84419513046d4f5755f06bfeebaf8ec442583e/src/mongo/db/ttl.idl#L39
yopp
в документации нет упоминания ttlMonitorSleepSecs, но его можно настроить через serverParams
Alexandrr
в документации нет упоминания ttlMonitorSleepSecs, но его можно настроить через serverParams
как думаешь, имеет смысл свой внешний воркер сделать с доп. запросами на удаление, что бы нивелировать этот "зазор" в 0-60 секунд?
или это сильно грузанёт субд?
yopp
как думаешь, имеет смысл свой внешний воркер сделать с доп. запросами на удаление, что бы нивелировать этот "зазор" в 0-60 секунд?
или это сильно грузанёт субд?
не думаю что есть существенная разница между тем откуда удалять документы. основные настройки можно задать и для ttl монитора. с точки зрения точности времени, внешний источник тоже не гарантирует что документы удалятся «мгновенно». в целом, мгновенно удалить документы нельзя, всё равно будет задержка.
если нужно гарантировать что какие-то документы должны быть недоступны строго после какого-то времени, то надёжнее к TTL ещё и условие в выборках задавать
Alexandrr
не думаю что есть существенная разница между тем откуда удалять документы. основные настройки можно задать и для ttl монитора. с точки зрения точности времени, внешний источник тоже не гарантирует что документы удалятся «мгновенно». в целом, мгновенно удалить документы нельзя, всё равно будет задержка.
если нужно гарантировать что какие-то документы должны быть недоступны строго после какого-то времени, то надёжнее к TTL ещё и условие в выборках задавать
отличная идея, хоть и немного замедлит запросы, но будет сразу возвращать только то, что "не попало в корзину"
yopp
если не ошибаюсь, то планировщик может использовать ttl индекс. можно проверить через explain. затраты не очень большие должны быть
yopp
а о каких объёмах документов речь?
Alexandrr
а о каких объёмах документов речь?
150-550к постоянно обновляющихся, где 290 млн записей
записи шифрованные и сжатые, по этому весят мало
yopp
а какой процент под ttl попадает?
Alexandrr
а какой процент под ttl попадает?
каждые 5 минут примерно до 550к
в зависимости от нагрузки RPS
каждую секунду примерно 500-1850 документов
Alexandrr
а какой процент под ttl попадает?
ну вообщем попробую по совету, спасибо, на счёт explain-а, если сильно скажется на производительности, то буду "сборщик мусора" свой писать
yopp
а какая точность по времени нужна?
Alexandrr
я вот думаю, мож редиску для этой задачи использовать, но похоже там такой же механизм с задержками 0-60
 Котик
 ᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠ
Котик
это работает и в случае с SQL подобными БД
ᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠ
MongoDB не реляционная БД, где информация хранится в JSON формате. О каких таблицах идет речь?
 Andrey
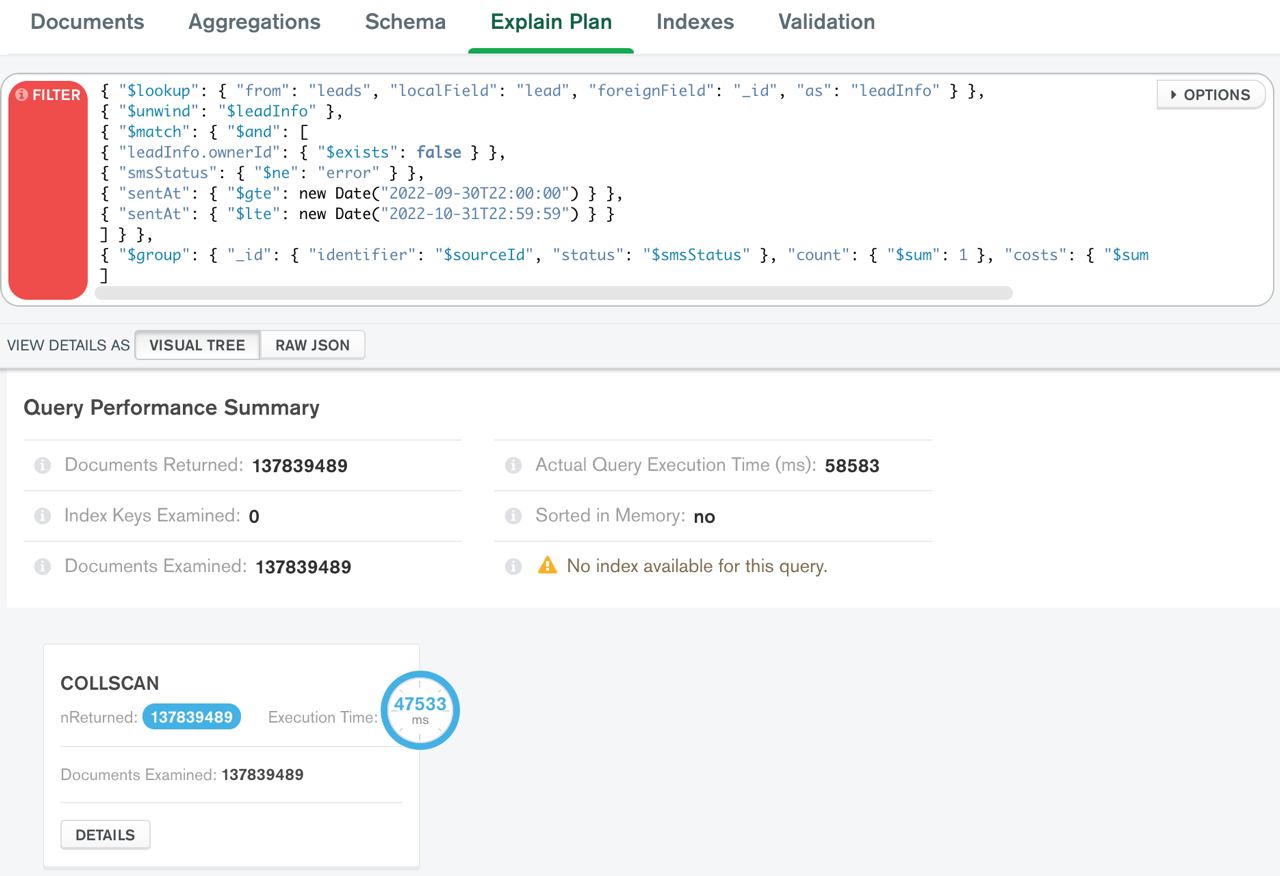
всем привет! подскажите пожалуйста как можно ускорить запрос, коллекция примерно 100млн документов. через MongoDB Compass (Explain Plan) такой запрос обрабатывается почти 2 минуты.
db.messages.aggregate([
{ "$lookup": { "from": "leads", "localField": "lead", "foreignField": "_id", "as": "leadInfo" } },
{ "$unwind": "$leadInfo" },
{ "$match": { "$and": [
{ "leadInfo.ownerId": { "$exists": false } },
{ "smsStatus": { "$ne": "error" } },
{ "sentAt": { "$gte": new Date("2022-09-30T22:00:00") } },
{ "sentAt": { "$lte": new Date("2022-10-31T22:59:59") } }
] } },
{ "$group": { "_id": { "identifier": "$sourceId", "status": "$smsStatus" }, "count": { "$sum": 1 }, "costs": { "$sum": "$cost" } } }
])
 Vladyslav
всем привет! подскажите пожалуйста как можно ускорить запрос, коллекция примерно 100млн документов. через MongoDB Compass (Explain Plan) такой запрос обрабатывается почти 2 минуты.
db.messages.aggregate([
{ "$lookup": { "from": "leads", "localField": "lead", "foreignField": "_id", "as": "leadInfo" } },
{ "$unwind": "$leadInfo" },
{ "$match": { "$and": [
{ "leadInfo.ownerId": { "$exists": false } },
{ "smsStatus": { "$ne": "error" } },
{ "sentAt": { "$gte": new Date("2022-09-30T22:00:00") } },
{ "sentAt": { "$lte": new Date("2022-10-31T22:59:59") } }
] } },
{ "$group": { "_id": { "identifier": "$sourceId", "status": "$smsStatus" }, "count": { "$sum": 1 }, "costs": { "$sum": "$cost" } } }
])
какой индекс используется?
и с explain предоставьте "nReturned", "totalDocsExamined" и "executionTimeMillis". (для уверености лучше 2: один без группировки и 2 с ней)
Andrey
Vladyslav
 Andrey
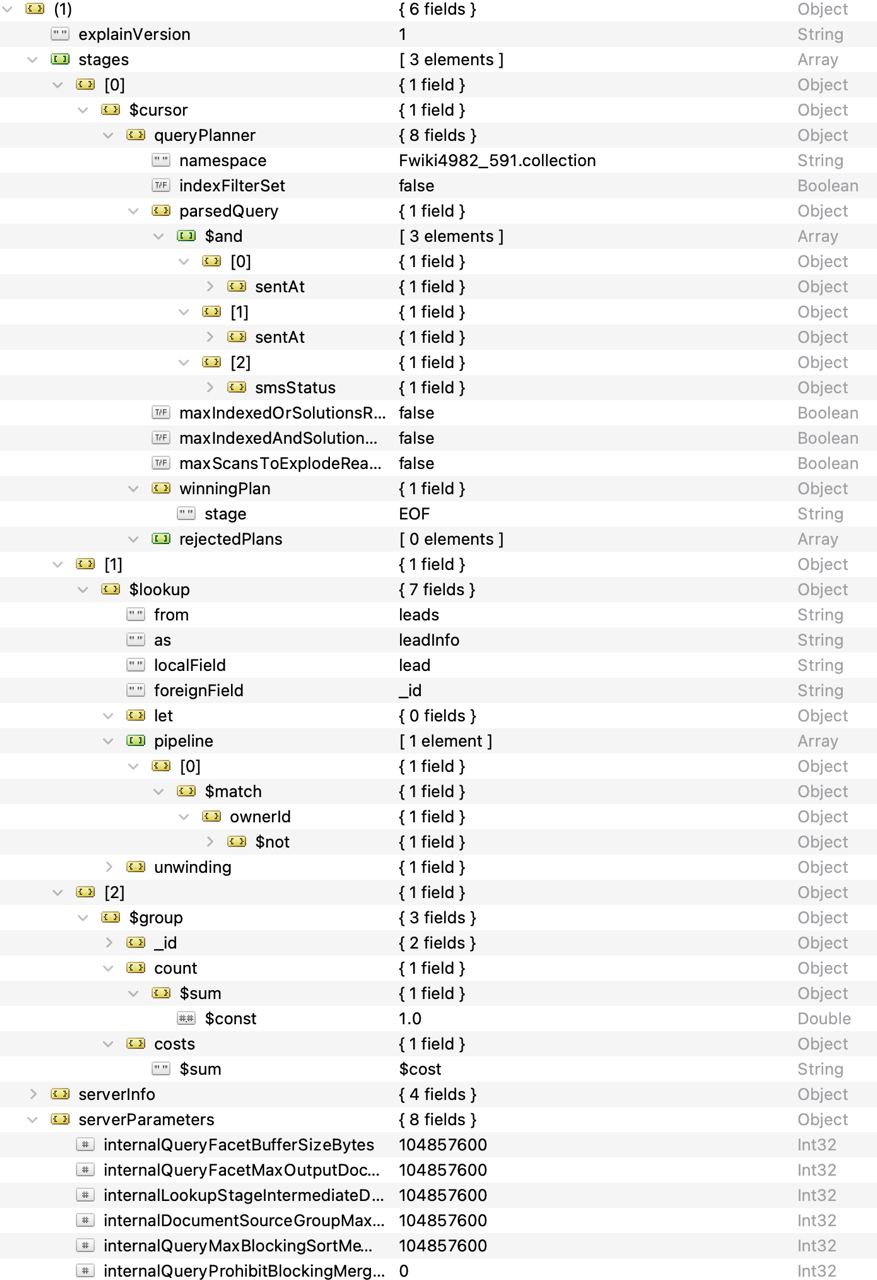
индекс я неправильно настроил скорее всего, потому что он не используется..
Andrey
Andrey
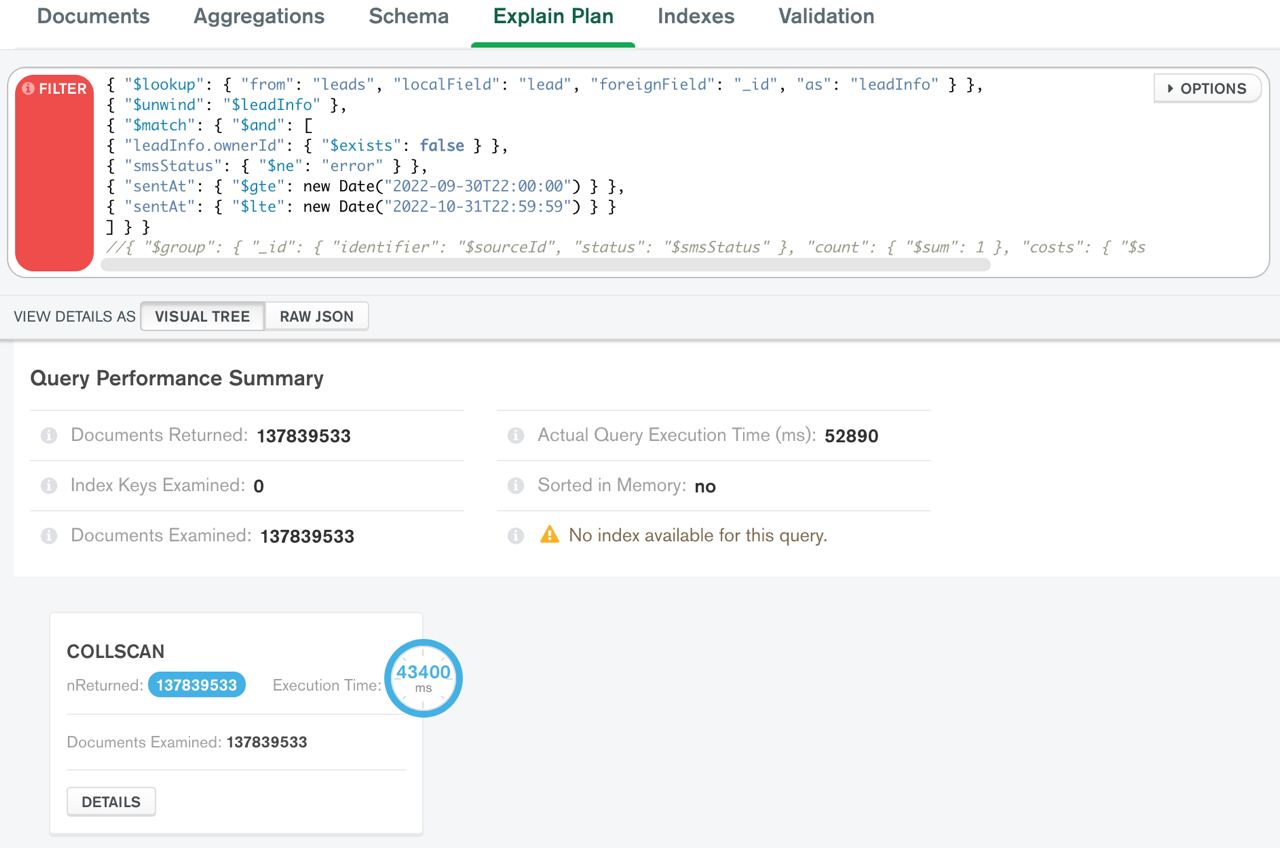
правильно понимаю, что группировка занимает х3 времени?
сейчас 50к мс, до этого был скрин 180к мс с ней - верно?
нет, вот посмотрите оба скрина
Andrey
да, я вчера вечером делал, сервер был в нагрузке, сегодня заново
Vladyslav
в любом случае, настройте индекс и уже будет лучше)
Alexandrr
 Andrey
в любом случае, настройте индекс и уже будет лучше)
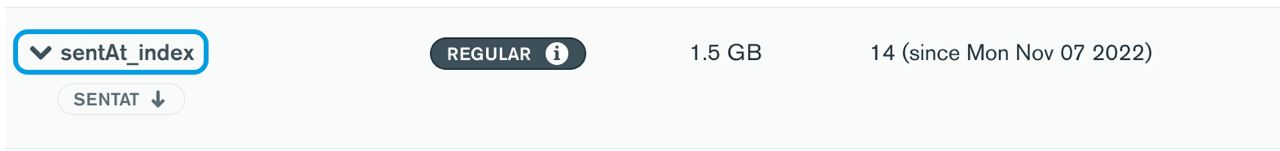
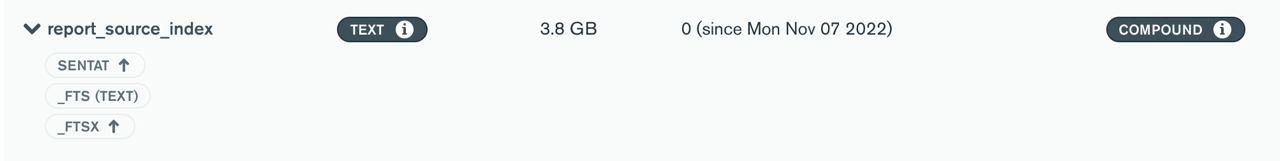
я пробовал добавлять индексы отдельно по sentAt, по sourceId и по smsStatus - но почему-то автоматически он не используется
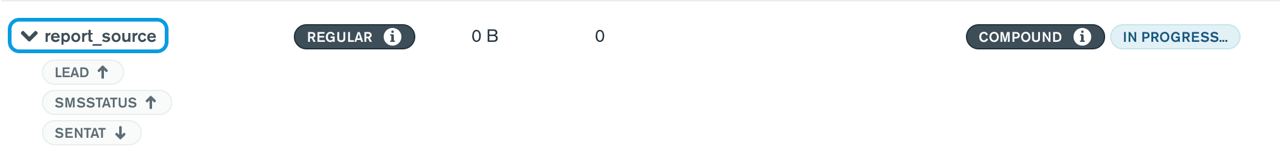
пробовал делать составной индекс - но то же самое.
странно, почему так?
Andrey
 Andrey
 Vladyslav
я пробовал добавлять индексы отдельно по sentAt, по sourceId и по smsStatus - но почему-то автоматически он не используется
пробовал делать составной индекс - но то же самое.
странно, почему так?
у вас должен быть составной индекс.
в explain - можна найти инфу, какие индексы монго пробовала заюзать и что выбрала в итоге.
Wassilevs
по отдельности индексы, нет смысла, планер использует только один, нужен составной по правилу ESR
Wassilevs
@BEL0V
можете попробовать такой
db.messages.createIndex({"leadInfo.ownerId":1,"smsStatus":1,"sentAt":-1})
Andrey
 Andrey
@BEL0V
можете попробовать такой
db.messages.createIndex({"leadInfo.ownerId":1,"smsStatus":1,"sentAt":-1})
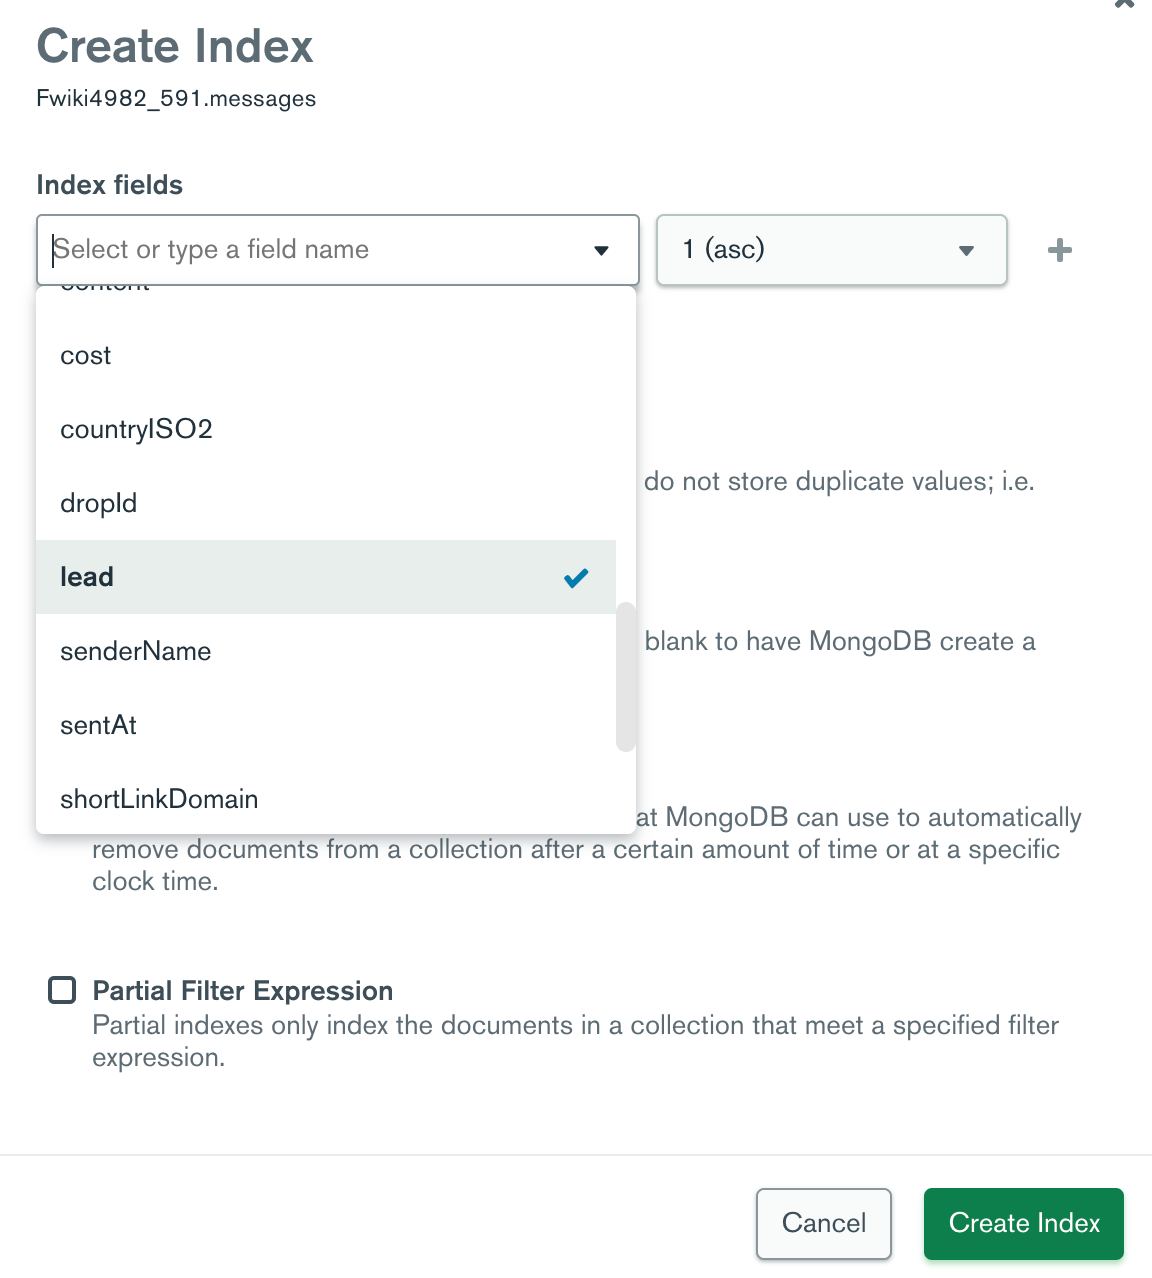
если пробовать создавать индекс в Compass (руками), то я не могу обратиться к дочерней коллекции (lead), т.е вот такой индекс не могу создать leadInfo.ownerId":1
Andrey
 Andrey
 Wassilevs
@BEL0V я тупанул, по explain видно что первый этап идёт на smsStatus, потом sentAt
так что лучше попробовать сначала по этим полям
db.messages.createIndex({"smsStatus":1,"sentAt":1})
Andrey
Ivan
 Wassilevs
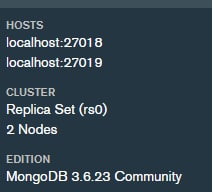
какой статус реплики?
rs.status()
 Nick
Ivan
то есть переустановить монгу, самый быстрый способ ?
Кылыч
ку! господа, помогите плиз найти решение. условно есть одна коллекция, где содержатся список товаров, и есть у нас другая коллекция(грубо говоря в одной записи айдишник юзера + массив айдишек популярных товаров), задача следующая, при фильтрации каждому юзеру нужно сперва показать именно те которые считаются рекомендоваными, а потом только обычные товары. как лучше всего это сделать? так как список популярных товаров для каждого юзера примерно 200 шт, и не хочется похерить монгу используя оператор $in по айдишкам. тут еще один момент, список юзеров с массивом популярных для них товаров содержится в произвольном виде, то есть эти данные можно хранить в любом формате, главное чтобы выплывание наверх этих товаров работало. подскажите плиз варианты решения?) заранее благодарю!)
Nick
да, потмоу что 3.6 версия давно не поддерживается и там вполне может быть несовместимость с компасом
Alexandrr
такие вещи огромные скидывайте на пастебин лучше
Ivan
спасибо за совет
Кылыч
ку! господа, помогите плиз найти решение. условно есть одна коллекция, где содержатся список товаров, и есть у нас другая коллекция(грубо говоря в одной записи айдишник юзера + массив айдишек популярных товаров), задача следующая, при фильтрации каждому юзеру нужно сперва показать именно те которые считаются рекомендоваными, а потом только обычные товары. как лучше всего это сделать? так как список популярных товаров для каждого юзера примерно 200 шт, и не хочется похерить монгу используя оператор $in по айдишкам. тут еще один момент, список юзеров с массивом популярных для них товаров содержится в произвольном виде, то есть эти данные можно хранить в любом формате, главное чтобы выплывание наверх этих товаров работало. подскажите плиз варианты решения?) заранее благодарю!)
Дополню, есть пагинация, и если скажем список рекомендованных товаров не заполнили одну страницу, то тогда нужно допинать уже из дефолтной выборки и так далее
Wassilevs
Alexandrr
Дополню, есть пагинация, и если скажем список рекомендованных товаров не заполнили одну страницу, то тогда нужно допинать уже из дефолтной выборки и так далее
с пагинациями лучше через локалсторадж, если бизнес-логика говорит, что дальше 20 товара по счету рекомендованного пользователи очень часто лазят
 Murena
все привет - подскажите, как изменять индекс документа в массиве субдокументов, знаю что есть оператор position - но он только работает с push , есть ли еще какой то способ просто изменять очередность елементов в массиве монги (без добавление вспомагательных полей типа order для сортировки)
Nick
все привет - подскажите, как изменять индекс документа в массиве субдокументов, знаю что есть оператор position - но он только работает с push , есть ли еще какой то способ просто изменять очередность елементов в массиве монги (без добавление вспомагательных полей типа order для сортировки)
Можно пересобрать через concatArray и слайс
spectrum
Подскажите пожалуйста, если файлы уже загружены на сервер (Express) и я хочу записать их в MongoDB используя Mongoose, можно ли обойтись без Multer/Multer-gridfs-storage пакетов? Можно ли как то используя только Mongoose и GridFS загрузить файлы с сервера в MongoDB? Заранее благодарю за помощь.
 fierylife
Can't find a codec for class java.lang.Object аааааааааааааааааааа
fierylife
что за дичь))
Тимур
ребят, подскажите пж, как отфильтровать коллекцию по длине строки?
Alexey
ребят, подскажите пж, как отфильтровать коллекцию по длине строки?
https://stackoverflow.com/questions/29577713/string-field-value-length-in-mongodb
Ivan
Добрый день. Нужен ваш совет. В рамках mongodb транзакции стоит использовать, если обновляешь две и более коллекции или как-то иначе ?
Nick
Добрый день. Нужен ваш совет. В рамках mongodb транзакции стоит использовать, если обновляешь две и более коллекции или как-то иначе ?
Как и везде транзакции используются для выполнения либо всех запросов либо ни одного. Сколько доков меняется и где они лежат не имеет значения
ASAP
 ASAP
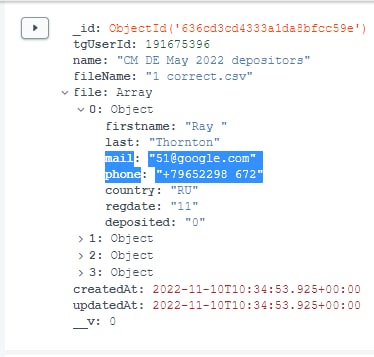
Ребята, всем привет, подскажите, как правильнее было бы решить задачу:
имеется струткура (скрин), нужно при каждом новом добавлении новой модели
проверять, есть ли выделенные значения со скрина (значения полей mail/phone, эти ключи могут меняться,
они приходят по-разному с фронта: mail, email, e-mail...)в других моделях.
Если да, то считать количество таких дубликатов, запоминать, где конкретно они встретились (наверное по _id)
и при этом, если оба значения в этих полях совпадают, то это "полный дубликат", если хотя бы одно, то "частичный".
Нужно отдать два значения на фронт и если пользователь решает удалить какие-то из дубликатов, мы эти поля удаляем из ДБ.
Проблема в том, что нужно делать это для каждого элемента. То есть, к примеру создалась новая модель, где есть file:[{mail:'exmaple'}
,{email: 'examplemail},{mail:'xxx},{}] и мне нужно брать каждый объект и сравнивать с каэжым объектом из уже имеющихся. Есть ли какое-то решение
с методом, наподобие нативного filter в js? Могу еще дополнительно скинуть пример кода, как я реализовал это на фронте.
Но там я проверяю только в рамках одной будущей коллекции на этапе ее формирования еще.
//Находим последнее вхождение в нашу коллекцию
app.models.ParsedList.find({},
(_, data) => {
let ID = data[data.length - 1].id
app.models.ParsedList.find({'_id': ID},
(_, data) => {
console.log(data)
})
})
//Обновляем или удаляем наше значение
app.models.ParsedList.findOneAndUpdate(
{_id: '636b7e1d2a6e60a01f4aa6e2', 'file.mail': 'test' },
{
$set: {
'file.$.mail': 'test'
}
// , $unset: { 'file.$.phone': '1' }
},
{new: true},
(_, data) => {
console.log(data)
}
)
ASAP
А не хотите просто запретить использовать разные названия полей для одного и того же?
даже если я имею статичное название, то все равно не совсем понимаб, как реализовать данную логику
Nick
даже если я имею статичное название, то все равно не совсем понимаб, как реализовать данную логику
Фаинд или агрегация по значению, в один запрос
ASAP
Фаинд или агрегация по значению, в один запрос
app.models.ParsedList.updateMany(
{'file.deposited': '0'},
{
$set: {
'file.$[].mail': 'test'
}
// $unset: {'file.$[].mail': '1'}
},
{new: true},
(_, data) => {
console.log(data)
}
)
есть еще такой метод, который просто все вхождения из query заменит везде, где найдет. но я не понимаю, как ему давать каждый раз правильную query
ASAP
и нужно каждый раз давать ему новый query, если у меня много элементов, правильно понимаю?
Nick
и нужно каждый раз давать ему новый query, если у меня много элементов, правильно понимаю?
Это вопрос к вам, вы же требования по задаче собирали)
Nick
app.models.ParsedList.updateMany(
{'file.deposited': '0'},
{
$set: {
'file.$[].mail': 'test'
}
// $unset: {'file.$[].mail': '1'}
},
{new: true},
(_, data) => {
console.log(data)
}
)
есть еще такой метод, который просто все вхождения из query заменит везде, где найдет. но я не понимаю, как ему давать каждый раз правильную query
Ничего не мешает вам доработать структуру в базе, чтобы стало удобнее и эту задачу решить и возможно другие
Alex
Ребята пытался локально установить на Ubuntu 22 MongoDB, но ни файлы в tgz не работают после распаковки и server и mongos не инсталяться! Уже перепробовал версию Ubuntu 20.04, Debian 11, 10. Версии 22.04 нет там. В зеркале яндекса тоже не увидел Монго. Кто может подсказать, как установить?
 fenogentov
 Αρτέμιος
Serb
Могу ли я внутри документа сослаться на поле в этом же документе? Заранее спасибо
Dmitry
Могу ли я внутри документа сослаться на поле в этом же документе? Заранее спасибо
В каком плане сослаться?