 Александр


Коллеги доброго дня использую mongoose помогите разобраться хочу в документ в вложить другой документ создал две схемы при запросе API получаю ID документа name который нужно в писать в поле но чего не то не получается совсем если может кто помочь всю инфу скину
 Dmitry
Коллеги доброго дня использую mongoose помогите разобраться хочу в документ в вложить другой документ создал две схемы при запросе API получаю ID документа name который нужно в писать в поле но чего не то не получается совсем если может кто помочь всю инфу скину
Пропиши ref в схеме и вызови populate
vital
всем привет, а подскажите что в mongodb значит returned document?
 Alexandrr
всем привет, а подскажите что в mongodb значит returned document?
 vital
А то есть это кол-во запросов в монгу?
vital
именно через find()
vital
правильно понимаю?
 Nick
зависит от контекста
Nick
дайте больше инфы о том где вы такой термин увидели
vital
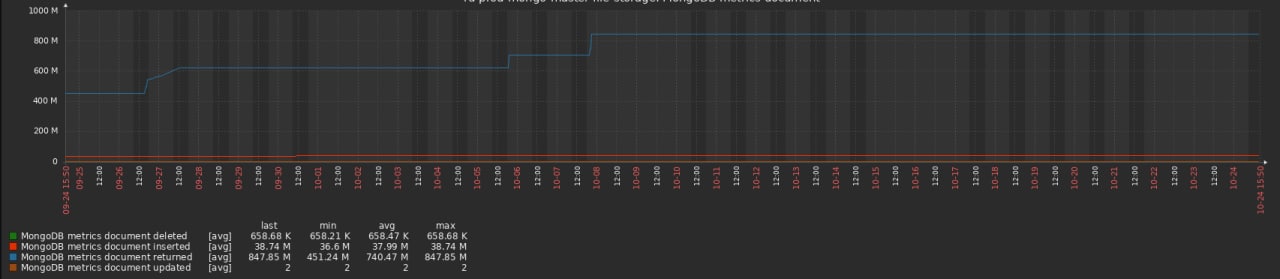
да в zabbix нарвался на график)
vital
 vital
но выглядит правдоподобно)
Nick
тогда да как человек выше написал - это общее количество возвращенных доков по выборкам. Туда наверняка попадают и агрегации, если отдельной метрики нет
Nick
но выглядит правдоподобно)
https://www.mongodb.com/docs/manual/reference/command/serverStatus/#mongodb-serverstatus-serverstatus.metrics.document.returned
vital
Спасибо
WEB
 WEB
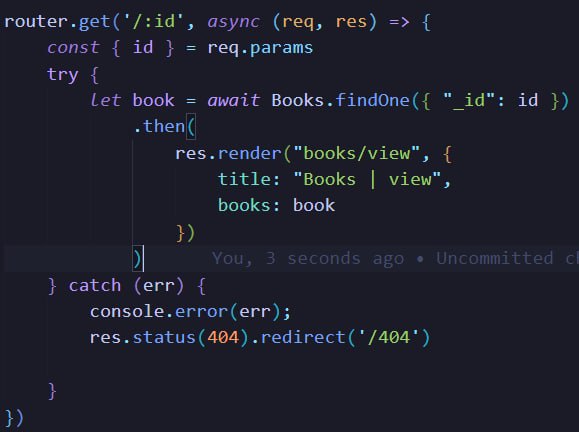
ОЙ, то есть Cannot access 'book' before initialization
WEB
Данная ошибка сейчас, та, чту кинул - старая
Nick
ОЙ, то есть Cannot access 'book' before initialization
вы не можете обратиться к переменной во время ее инициализации. Вы используете переменную book в запросе там же где и создаете ее
WEB
вы не можете обратиться к переменной во время ее инициализации. Вы используете переменную book в запросе там же где и создаете ее
спасибо, пропустил этот момент )
 ㅤ
Всем привет, кто-то из вас когда-нибудь заливал на монго бота для дискорда?
ㅤ
Всем привет, кто-то из вас когда-нибудь заливал на монго бота для дискорда?
Купил бота, нужно на монго и хост залить. Очень много файлов, не понятно что куда заливать. До этого таким не занимался (первый опыт)
 Anton
Привет всем! Нужна помощь с шардированной mongodb. Ситуация такая:
Имеются 4 рабочие шарды c размером одной из баз около 2TB, т.е. по 500 Гигов на шарду.
Потребовалось добавить 5ю шарду и тут возникла проблема с долгой балансировкой. За 1 месяц перенеслось около 15% . Вопрос в след. нормальная ли данная ситуация? либо есть проблема которую я не вижу?
mongos> sh.status()
--- Sharding Status ---
sharding version: {
"_id" : 1,
"minCompatibleVersion" : 5,
"currentVersion" : 6,
"clusterId" : ObjectId("5fb65dda1d6aedfdh23832")
}
shards:
{ "_id" : "1_shard", "host" : "1_shard/m1.shard.ru:28100,m2.shard.ru:28100", "state" : 1 }
{ "_id" : "2_shard", "host" : "2_shard/m2.shard.ru:28200,m3.shard.ru:28200", "state" : 1 }
{ "_id" : "3_shard", "host" : "3_shard/m3.shard.ru:28300,m4.shard.ru:28300", "state" : 1 }
{ "_id" : "4_shard", "host" : "4_shard/m4.shard.ru:28400,m5.shard.ru:28400", "state" : 1 }
{ "_id" : "5_shard", "host" : "5_shard/m1.shard.ru:28500,m5.shard.ru:28500", "state" : 1 }
active mongoses:
"4.4.1" : 5
"4.4.2" : 1
autosplit:
Currently enabled: yes
balancer:
Currently enabled: yes
Currently running: yes
Collections with active migrations:
ebase.Message started at Tue Oct 25 2022 11:08:30 GMT+0300 (MSK)
Failed balancer rounds in last 5 attempts: 0
Migration Results for the last 24 hours:
21 : Success
17 : Failed with error 'aborted', from 2_shard to 5_shard
677 : Failed with error 'aborted', from 1_shard to 5_shard
databases:
{ "_id" : "config", "primary" : "config", "partitioned" : true }
config.system.sessions
shard key: { "_id" : 1 }
unique: false
balancing: true
chunks:
1_shard 205
2_shard 205
3_shard 205
4_shard 205
5_shard 204
too many chunks to print, use verbose if you want to force print
{ "_id" : "ebase", "primary" : "4_shard", "partitioned" : true, "version" : { "uuid" : UUID("den6c870-a8b7-446d-9894-66b80ddd1d07"), "lastMod" : 1 } }
ebase.Message
shard key: { "_id" : "hashed" }
unique: false
balancing: true
chunks:
1_shard 32725
2_shard 32725
3_shard 32723
4_shard 32723
5_shard 4695
too many chunks to print, use verbose if you want to force print
{ "_id" : "test", "primary" : "3_shard", "partitioned" : false, "version" : { "uuid" : UUID("94d782h0-a8c2-4129-ad27-a60e9fsd1fe6"), "lastMod" : 1 } }
Anton
Увы, это нормальная ситуация
хм. спасибо, получается по моим расчетам данные сбалансируются через 6 месяцев. Это очень больно.
 yopp
у вас достаточно старая версия монги, в 5.x и 6.x ситуацию немного улучшили, можете попробовать аккуратно до 5.x апнутся. С 6.x могут быть проблемы с драйверами, нужно будет протестировать совместимость
Anton
у вас достаточно старая версия монги, в 5.x и 6.x ситуацию немного улучшили, можете попробовать аккуратно до 5.x апнутся. С 6.x могут быть проблемы с драйверами, нужно будет протестировать совместимость
хм. спасибо за совет, были планы обновить до 4.4.17 для начала, если ситуация не улучшится, будем смотреть в сторону 5) спасибо!
yopp
хм. спасибо за совет, были планы обновить до 4.4.17 для начала, если ситуация не улучшится, будем смотреть в сторону 5) спасибо!
проверьте за одно что у вас FCV установлен в 4.4
https://www.mongodb.com/docs/manual/release-notes/4.4-upgrade-sharded-cluster/#enable-backwards-incompatible-features
там есть ряд вещей которые могут сломаться, например FCV 4.4 включает structured logging. если у вас есть инструменты которые завязаны на анализ логов, их вероятно придётся обновить.
https://www.mongodb.com/docs/manual/release-notes/4.4-compatibility/
Anton
А можно поинтересоваться железом существующего кластера, и сетью и железом до нового сервера. А то прям совсем грустные показатели.
Intel(R) Xeon(R) W-2145 CPU @ 3.70GHz
8 X 32 GB DDR4 ECC RAM
2 × 960 GB SATA SSD
LAN 1GBit
Andrey
Intel(R) Xeon(R) W-2145 CPU @ 3.70GHz
8 X 32 GB DDR4 ECC RAM
2 × 960 GB SATA SSD
LAN 1GBit
Метрики не смотрели, раз уж все так печально, было бы интересно знать, как читает и пишет по сети при такой операции кластер. Прям очень печальный факт.
Andrey
Так можно и не планировать даже не рассматривать монгу на условный следующий проект где будет чуть больше данных, с перспективой роста.
Alexandrr
Intel(R) Xeon(R) W-2145 CPU @ 3.70GHz
8 X 32 GB DDR4 ECC RAM
2 × 960 GB SATA SSD
LAN 1GBit
и самой важной инфы про диск нет, какой диск, какая скорость записи/чтения ))) хостинги как обычно хитрят
Anton
и самой важной инфы про диск нет, какой диск, какая скорость записи/чтения ))) хостинги как обычно хитрят
два в аппаратном рэйде 0
=== START OF INFORMATION SECTION ===
Model Family: Toshiba HK4R Series SSD
Device Model: TOSHIBA THNSN8960PCSE
Serial Number: 17ES101MTB1V
LU WWN Device Id: 5 00080d 9105934ca
Firmware Version: 8EET6101
User Capacity: 960 197 124 096 bytes [960 GB]
Sector Size: 512 bytes logical/physical
Rotation Rate: Solid State Device
Form Factor: 2.5 inches
TRIM Command: Available, deterministic, zeroed
Device is: In smartctl database [for details use: -P show]
ATA Version is: ACS-3 (minor revision not indicated)
SATA Version is: SATA 3.2, 6.0 Gb/s (current: 6.0 Gb/s)
Local Time is: Tue Oct 25 15:19:46 2022 MSK
SMART support is: Available - device has SMART capability.
SMART support is: Enabled
yopp
Пожалуйста, воздержитесь от высказываний формата «дело в руках». Это неконструктивно
Ребалансировка достаточно сложная операция, с почти десятком стадий.
Одна из сложностей это момент синхронизации между донором и реципиентом, которая требует координации между тремя компонентами. Если переносимыый чанк меняется, монге может потребовать достаточно много времени на его перенос.
Скорость балансировки от «рук» не зависит, так как настроек которыми можно что-то в балансировке изменить — нет.
В протоколе постепенно что-то меняют в лучшую сторону, но для того чтоб ситуация улучшилась нужно обновлятся до последней стабильной версии.
Недели на ребалансировку больших объёмов, к сожалению, ожидаемое поведение.
В некоторой степени скорость может зависеть от того, упирается ли монга в ресурсы (диск/сеть/цпу) и насколько большой лаг репликации. Если мне память не изменяет, то при миграции чанков используется writeConcern > 1 (или majority?).
Где-то была ручка которой можно его понизить, но это не самый безопасный способ
yopp
Я выше отметил, что текущий FCV должен соотвествовать текущей версии монги, так с более низкой версией новые фичи из протокола скорее всего использоваться не будут
Viktar
У меня ребалансировка с 5 до 6 шардов заняло больше месяца. Общий объем был около 4ТБ. ~800млн записей. 5-я монга.
yopp
Null
6.0.2 (Sep 28) ◦ 5.0.13 (Sep 29) • 4.4.17 (Sep 28) • 4.2.23 (Sep 29)
🔥 Вышли версии 6.0.2, 5.0.13, 4.4.17 и 4.2.23
⚠️ Версии 6.0.0 и 5.0.0–5.0.10 содержат критическую ошибку, которая может привести к несогласованному состоянию метаданных в шардированном кластере (SERVER-68511).
Ошибка исправлена в версиях 6.0.1+ и 5.0.11+.
ℹ️ Объявлен срок завершения поддержки ветки 4.2: апрель 2023 года.
ℹ️ Восстановлена работа зеркал
• репозитория repo.mongodb.org: https://mirror.db-ai.co
• документации: https://docs.db-ai.co/ (4.2, 4.4, 5.0, 6.0)
• Зеркало repo.mongodb.org доступное из СНГ
• Документация | Зеркало для СНГ
Stable: 6.0.2 (Sep 28) 5.0.13 (Sep 29)
Bugfix: 4.4.17 (Sep 28), Legacy: 4.2.23 (Sep 29, ☠️ Apr '23)
☠️ 4.0.28 (Apr '22) 3.6.23 (Mar ’21), 3.4.24 (Jan ‘20)
 EMiN
Добрый вечер. Подскажите как лучше работать с времени в монге? Если в монге время пишется только в UTC то делать отдельное поле offset или сохранять время с часовым поясом в формате string?
Dmitry
А чем не нравится UTC+0?
Dmitry
Также ты всегда гарантируешь, что данные в едином стиле и не надо с бубном танцевать либо ещё что-то делать
Alexandrr
Также ты всегда гарантируешь, что данные в едином стиле и не надо с бубном танцевать либо ещё что-то делать
с отрицательными датами тоже не надо заморачиваться тогда
Alexandrr
А чем тебя 0 не устраивает?
нее, это я к тому что он тогда сможет и с отрицательными работать
Nick
с отрицательными датами тоже не надо заморачиваться тогда
а есть примеры где отрицательные даты используютяс7
Dmitry
а есть примеры где отрицательные даты используютяс7
Например сделка произошла в 4 утра по Москве и по тз стоит, что каждый клиент видит своё время и тогда если человек с Бразилии, тогда надо сделать -3 за место -6
Alexandrr
а есть примеры где отрицательные даты используютяс7
архивные записи об истории, антропологические, геологические, археологические исследования, где постоянно идёт работа с отрицательными датами
Nick
Nick
Anton
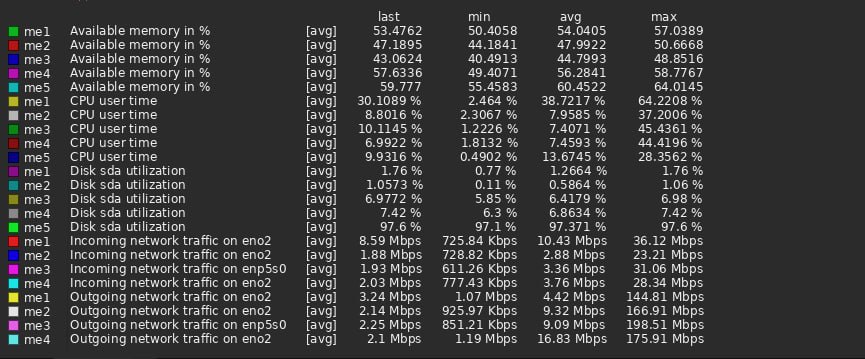
Метрики не смотрели, раз уж все так печально, было бы интересно знать, как читает и пишет по сети при такой операции кластер. Прям очень печальный факт.
 Andrey
Это на сервере?
Anton
То есть минимум свободной памяти 50%?
Да. это плохо? там закэшировано 140 гб
top одного из серверов
MiB Mem : 257672,8 total, 1601,5 free, 115275,3 used, 140796,0 buff/cach
Anton
А она нужна вам, другие сервисы еще есть? Почему так много свободной?
там закэшировано 140 гб на сколько я вижу.
Andrey
По идее можно больше предложить монге
Andrey
Вы конфигурировали настройки по памяти монги?
Andrey
Я к тому, что на моих 3 серверах с монгой, где только монга, остается свободной, ну максимум 15%
Anton
похоже возможно заббикс не включает кэш, вывод atop
MEM | tot 251.6G | free 1.8G | cache 140.0G | dirty 6.2G | buff 953.5M | slab 6.2G | slrec 5.8G | shmem 1.4M | shrss 0.0M | shswp 0.0M | vmbal 0.0M | hptot 0.0M | hpuse 0.0M
Anton
Andrey
я сейчас заметил что me5 (новая шарда) упирается в диск. Либо это нормальная ситуации при балансировки.
ну логически, как она упирается в диск, если у вас по сети загрузка - очень маленькая, от чего и каких данных она может "упираться".
Я про cache wiredtiger справшивал, https://www.mongodb.com/docs/manual/core/wiredtiger/
Anton
в топе
90% [kworker/u72:2+flush-8:0] и
mongodb 90%
Andrey
в топе
90% [kworker/u72:2+flush-8:0] и
mongodb 90%
а сервер свой, в клауде, реальное железо? Я сейчас посмотрел на свои, 1 в яндексе тоже 2 tb sdd, и на свой из реального железа микро сервер, 2 tb nvme - и на тот и на другой клиенты из клауда пишут одни и те же данные(просто дублируется информация). так вот на сервере от яндекса, существенно видно нагрузка по iotop от mongo до 90%, а реальный ее не замечает просто...
Anton
а сервер свой, в клауде, реальное железо? Я сейчас посмотрел на свои, 1 в яндексе тоже 2 tb sdd, и на свой из реального железа микро сервер, 2 tb nvme - и на тот и на другой клиенты из клауда пишут одни и те же данные(просто дублируется информация). так вот на сервере от яндекса, существенно видно нагрузка по iotop от mongo до 90%, а реальный ее не замечает просто...
хм, интересно... Да, у нас дэдики в хетснери.
Andrey
я для себя четко вижу, что условно одна и та же конфигурация - железо и в клауде - прям дают разную производительность, которую, ну, видно короче.
 Andrey K.
а сервер свой, в клауде, реальное железо? Я сейчас посмотрел на свои, 1 в яндексе тоже 2 tb sdd, и на свой из реального железа микро сервер, 2 tb nvme - и на тот и на другой клиенты из клауда пишут одни и те же данные(просто дублируется информация). так вот на сервере от яндекса, существенно видно нагрузка по iotop от mongo до 90%, а реальный ее не замечает просто...
а не может быть такого, что в сетку упирается в случае с бареметалом? Ну то есть сеть узкое место и нагрузка на диск подается очень дозированно
Andrey
а не может быть такого, что в сетку упирается в случае с бареметалом? Ну то есть сеть узкое место и нагрузка на диск подается очень дозированно
я думаю, что такую разницу дает реальный nvme и какой-то “ssd” от яндекса.