Не факт что ES даст лучшие результаты, но я в нём поверхностно разбираюсь.
А какие подстроки вы ищете?
Опираюсь на данную статью
https://blog.quarkslab.com/mongodb-vs-elasticsearch-the-quest-of-the-holy-performances.html
 Morant

 Morant
Не факт что ES даст лучшие результаты, но я в нём поверхностно разбираюсь.
А какие подстроки вы ищете?
Я ищу подстроку в имени товара. Обязательно условие возврата всех товаров, в которых присутствует данная подстрока в имени. Имя товара - строка длиной до 100 символов
 yopp
А сколько у вас товаров?
yopp
200 000
В теории, это достаточно небольшая энтропия: 200,000 × 100. Т.е в худшем случае вам нужно хранить ~200 млн подстрок. В реальности мы скорее говорим о медианном значении длинны слова умноженном на медианное значении числа слов.
Так как поиск все еще по словам, то можно сделать двухуровневые индексы: первый уровень это уникальные слова и их подстроки, плюс подстроки словоформ. Второй уровень это ссылки на слова.
В этом случае поиск будет состоять из двух шагов:
* найти оригинальную подстроку среди всего множества уникальных строк. Тут есть простор для оптимизации, например еще один «уровень» который отрезает слова без нужных букв.
* по идентификатору слов найти документы
yopp
По поводу инструментов с trie затрудняюсь ответить. Кажется, я где-то недавно видел что в Cassandra что-то подобное завезли
yopp
Вероятнее всего самым дешевым вариантом будет использование решений от яндекса/гугла, так как эта проблема — их хлеб
Morant
Вероятнее всего самым дешевым вариантом будет использование решений от яндекса/гугла, так как эта проблема — их хлеб
Вы имеете ввиду облычные сервисы или что-то вроде clickhouse?
yopp
Но не исключено, что у опенсурс решений есть что-то похожее
yopp
Вы имеете ввиду облычные сервисы или что-то вроде clickhouse?
Облачные сервисы, которые могут индексировать ваш контент и имеют api для поиска и ранжирования
yopp
Ох, сложно, надо чуть-чуть осознать
Да, эта проблема сама по себе сложная и ресурсоёмкая. Для быстрого поиска нужны инструменты которые или более-менее дешево умеют строить индексы по всем символам в строке или которые умеют быстро искать по набору ключевых слов (по сути в «ширину», имея очень много сегментов строк и очень много железа, чтоб по сегменту строк можно было дешево делать параллельный поиск)
yopp
Инструменты можно поискать по научным публикациям на тему substring search/match, вероятно вы или облачный сервис найдёте, или готовы инструмент, или ошмётки кода написанного учёными из которого можно собрать свой звездолёт, если разобрать что они там хотели сделать :)
yopp
С последним связываться не рекомендую, можно случайно диссертацию написать
yopp
Не забудьте скинуть в чят работу с которой защищались :))))
Morant
Не забудьте скинуть в чят работу с которой защищались :))))
Укажу ваш Ник в качестве консультанта)
 Yasi
Do you have idea about aggregation slow query logs mongodb? On graylog or any exporter
I need aggregate all mongodb slow query and collscan on Prometheus
Александр
насколько эффективно используются индексы при использовании регулярок? Если у меня поле _id такого вида "some_type#123#2022-08-22_23:27:46.199" и я использую регулярку "some_type#123#.*" то не приведет ли это к полному сканированию индекса и проверке каждого ключа на соответствие?
yopp
насколько эффективно используются индексы при использовании регулярок? Если у меня поле _id такого вида "some_type#123#2022-08-22_23:27:46.199" и я использую регулярку "some_type#123#.*" то не приведет ли это к полному сканированию индекса и проверке каждого ключа на соответствие?
Если регулярные выражения сводятся к поиску по префиксу, то планировщик запросов оптимизирует запрос сузив его до ключей в индексе, которые этот префикс содержат. Т.е полного сканирования не будет
yopp
В некоторых случаях планировщику нужно явно указать что поиск по префиксу используя квантификаторы ^ или \A
yopp
Проверить план и выполнение запроса можно через explain({executionStats: 1})
yopp
Там будут поля keys scanned, по которым будет видно селективность условия
Сергей
добрый день всем.
не получается удалить ноду из репликасет.. висит и ничего не делает..
подскажите, что можно сделать?
 DG
выключить с автозагрузки монгу и будтнуть сервер
Сергей
выключить с автозагрузки монгу и будтнуть сервер
к сожалению так нельзя. есть еще способы?
произошло после того, как я добавил ноду в репликусет. но мастер не может подключиться. пытаюсь удалить, но не дает
yopp
добрый день всем.
не получается удалить ноду из репликасет.. висит и ничего не делает..
подскажите, что можно сделать?
Попробуйте по этому плейбуку: https://docs.db-ai.co/docs/manual/tutorial/reconfigure-replica-set-with-unavailable-members/
 Нурлан
 Aleksey
Нурлан
+
Нурлан
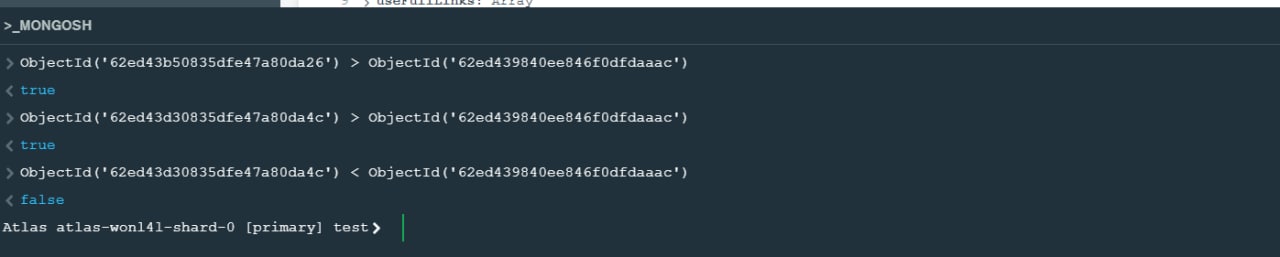
сравнивает референсы
Нурлан
мне прост нужно с кеша найти документ монгоДб по айди
Нурлан
линейно не охото, хочется О(logn)
Нурлан
отпишусь позже
 Харамбус
кто то сталкивался с таким?
MongoError: Plan executor error during findAndModify :: caused by :: WriteConflict error: this operation conflicted with another operation. Please retry your operation or multi-document transaction.
Anonymous
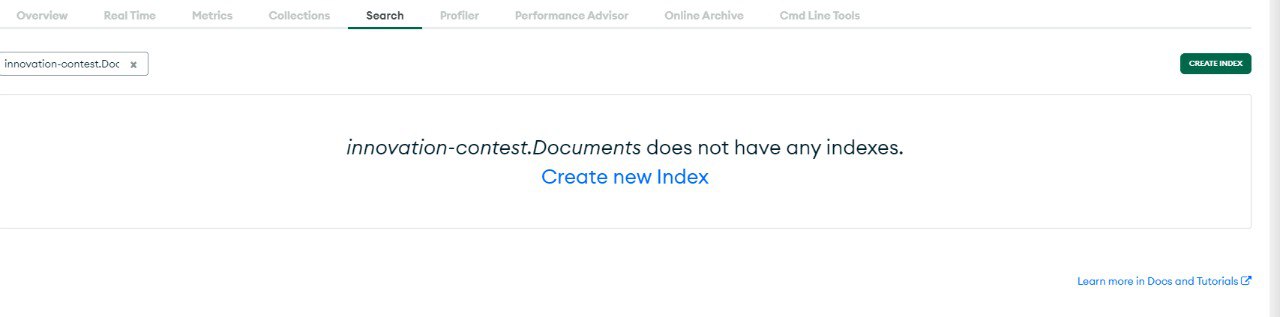
Hello there, guys I have one question about the search index in MongoDB Atlas Search, could we create it by query? I am able to create by mongo db cloud, but I want to create a search index in pymongo?
who knows about it?
Нурлан
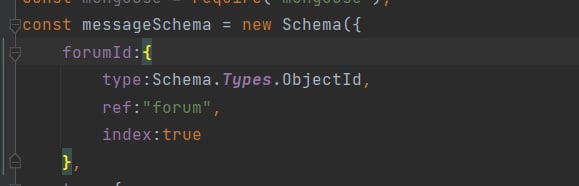
u mean create index for model?
Нурлан
 Anonymous
u mean create index for model?
 Нурлан
i think same
Нурлан
i can check it
Нурлан
 Anonymous
 Anonymous
Нурлан
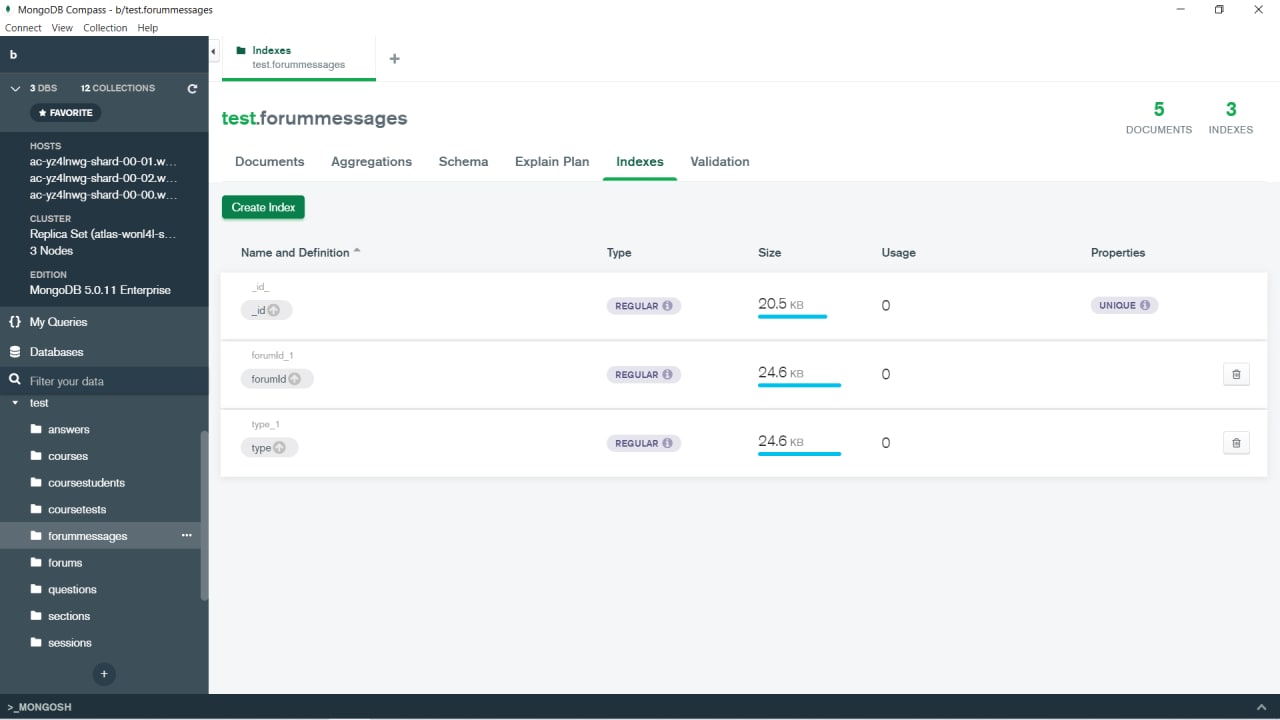
only by id
Anonymous
only by id
i know creating index, but i am looking for creating text search_index in MongoDB atlas search
Нурлан
oh
Нурлан
k
Нурлан
interesting
Нурлан
so you want to search by text yeah?
Нурлан
i dont understand eng clearly
Anonymous
so you want to search by text yeah?
yep there is Mongodb atlas search, and there is $search aggregate function, if we are going to work with this function, we should create search_index. So I am inserting it manually from MongoDB cloud right now and looking for ways to create by query
 Арби
 Ми
Арби
Харамбус
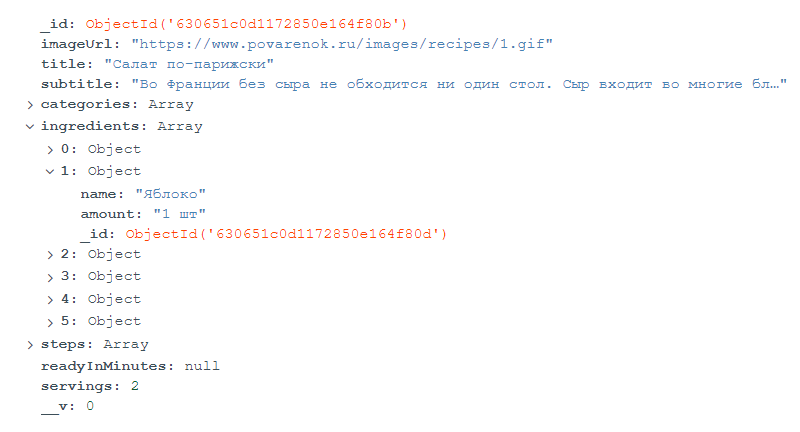
{ "ingredients.name": { $in: ["Яблоко", "ЕщеФрукт"] } }
Арби
смотрите, пользователь прислал список ингредиентов:
['Арбуз', 'Ананас', 'Виноград', 'Яблоко', 'Банан']
как мне в коллекции найти все блюда, которые он может из них приготовить?
чтобы блюдо не содержало больше ингредиентов, чем из этого списка, но меньше может, т.к. условно если будет блюдо из яблока и ананаса, я могу его приготовить из выше перечисленных ингредиентов
Kobo
Подскажите, в MongoDB можно добавить поле в существующий документ, но чтобы оно было не в конце документа, а между существующими полями
Kobo
Я просто с деревни
Харамбус
Kobo
$set может вставлять только в конец документа?
Харамбус
Структура коллекции опирается на принципы джсона
Харамбус
Не советую опираться на порядок ключей..
Харамбус
Хотя скорее всего я не прав, копайте сами)
Kobo
Не советую опираться на порядок ключей..
не, я не опираюсь на порядок. Исключительно чтобы глазу в Compass было приятно
Харамбус
А ты монгус юзаешь?
Харамбус
В любом случае есть плагины которые сортируют ключи при записи
Харамбус
Чекни
 KobylkinAnton
Всем привет, может кто подсказать как отобразить все активные процессы в виде таблицы. Пытаюсь на поде в кубере через currentOp, но отображает в виде огромного нечитаемого полотна в виде запросов, что очень неудобно.
также может кто знает, можно ли задать какой-то триггер, на то, чтобы убивались запросы повисающие больше 5мин
Semeon
У меня такой вопрос, господа.
Мне нужно по конкретному полю найти совпадение в коллекции. И если совпадение найдено, вернуть true. Если не найдено, то false. Какой метод для этого можно использовать?
 Bekzhan
Всем привет, есть таблица с салоном у каждой организации свой салон, внутри салона массив из объектов машин.
Пытаюсь сделать запрос, найти и вытащить 1 объект машины.
синтаксис из языка голенг,
filter := bson.M{"_id": salonId, "cars._id": carId},
res, err = db.salons.findOne(context, filter )
res.Decode(&car);
Ошибку о том что не найдено не пишет, и в сам объект машины не записывает результат.
Подскажите, может я запрос не правильно кидаю
Харамбус
Bekzhan
а примеры есть, как это делать?
Bekzhan
я просто в монге пару дней как
Bekzhan
ссылки на прмиеры