на сколько я понял, сначала нужно указать имя индекса через $, а потом обьект с поиском
.get_collection('all_names').aggregate([{'$match': {'$text': {'$search': f"{string}"}}}, {'$sort': {'score': {'$meta': "textScore"}}}, {'$limit': limit}])
я писал такую конструкцию, где f"{string}" это поисковая фраза пользователя (или слово)
 Alexandrr


 Phil
если точнее, у меня была разница в пределах 25-35% времени выполнения между пунктами, что описал выше, при свободном 100% времени простоя машины без нагрузки, судя из моих тестов.
коллекция была заполнена на 1.7 млн записей (документов)
интересно, как данные хранятся при текстовом индексировании и обычном индексировании, не находил ответа на этот вопрос?
(к wiredtiger кажется это относится?)
тоже тестил регулярки на 1М записей,
обычная пашет нормально по индексу, а вот с флагами делает FULLSCAN коллекции
Alexandrr
Phil
тоже тестил регулярки на 1М записей,
обычная пашет нормально по индексу, а вот с флагами делает FULLSCAN коллекции
так что вы правы наверное лучше делать full-text-search index
либо альтернативный вариант с очень быстрым поиском по префиксу:
класть в поле lowercase строку и поисковый запрос конвертить в lowercase и уже иксать по ней
/^query/ без options
Phil
на сколько я понял, сначала нужно указать имя индекса через $, а потом обьект с поиском
попробуйте так ещё
MyModel.find({$text: {$search: searchString}})
Alexandrr
так что вы правы наверное лучше делать full-text-search index
либо альтернативный вариант с очень быстрым поиском по префиксу:
класть в поле lowercase строку и поисковый запрос конвертить в lowercase и уже иксать по ней
/^query/ без options
приведение данных к lowercase, uppercase один из каконов построения поиска)
есть и другие
 Дима
приведение данных к lowercase, uppercase один из каконов построения поиска)
есть и другие
вы создавали индекс таким образом db.stores.createIndex( { name: "text", description: "text" } )
или на сайте?
Дима
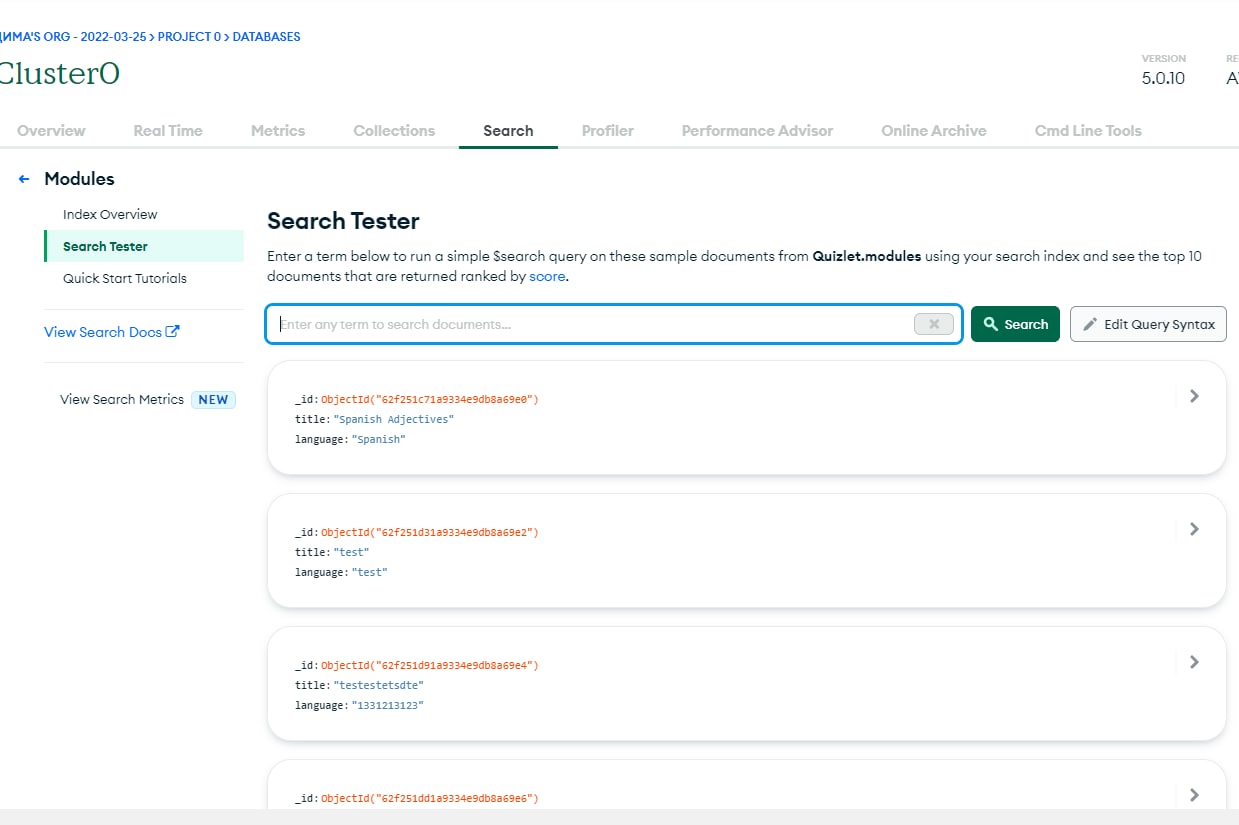
просто я вот в кластере создаю индекс и тут все работает
Дима
 Alexandrr
golang
я на питоне, в го нет таких трудностей как в питоне?
в питоне есть трудности, на уровне языка, с тем, что скорость исполнения кода не одинаковая и зависит от OS-ей.
питон код на айос исполняется быстрее в 2 раза чем в посикс системах и в 4 раза чем на винде
по этому я когда пишу код на тачке своей (шиндоус долбанный), потом выливаю на серв, там код работает в разы быстрее.
так что мои тесты могут быть не очень объективными и
разница в % может быть больше или меньше
Alexandrr
вы создавали индекс таким образом db.stores.createIndex( { name: "text", description: "text" } )
или на сайте?
.get_collection('all_names').create_index([('n', 'text')])
где 'n' - название поля, по которому производится создание индекса
Дима
А в каком месте мне нужно это написать вообще? В контроллерах или там, где я создаю саму модель Modules ? db.modules.createIndex( { title: "text" })
Дима
что ж так запутанно, ужас
Дима
.get_collection('all_names').aggregate([{'$match': {'$text': {'$search': f"{string}"}}}, {'$sort': {'score': {'$meta': "textScore"}}}, {'$limit': limit}]) В случае вашего примера что у вас стоит перед самой первой точкой, где вы производите эту команду
Alexandrr
.get_collection('all_names').aggregate([{'$match': {'$text': {'$search': f"{string}"}}}, {'$sort': {'score': {'$meta': "textScore"}}}, {'$limit': limit}]) В случае вашего примера что у вас стоит перед самой первой точкой, где вы производите эту команду
подключение к connection_pool (к базе данных какой-либо)
Дима
так и не сработало, ну и зараза
 Ilnur
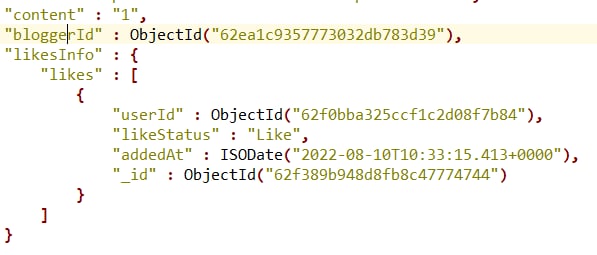
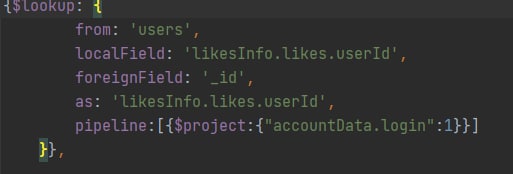
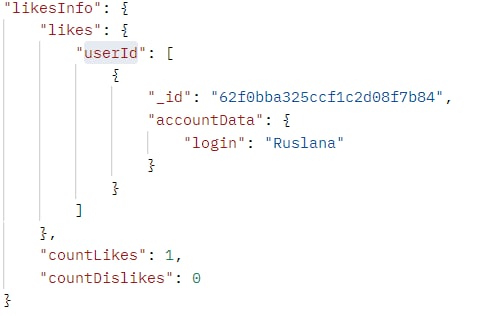
Всем привет, может кто знает почему-то второй lookup не срабатывает на основе данных первого lookup
Ilnur
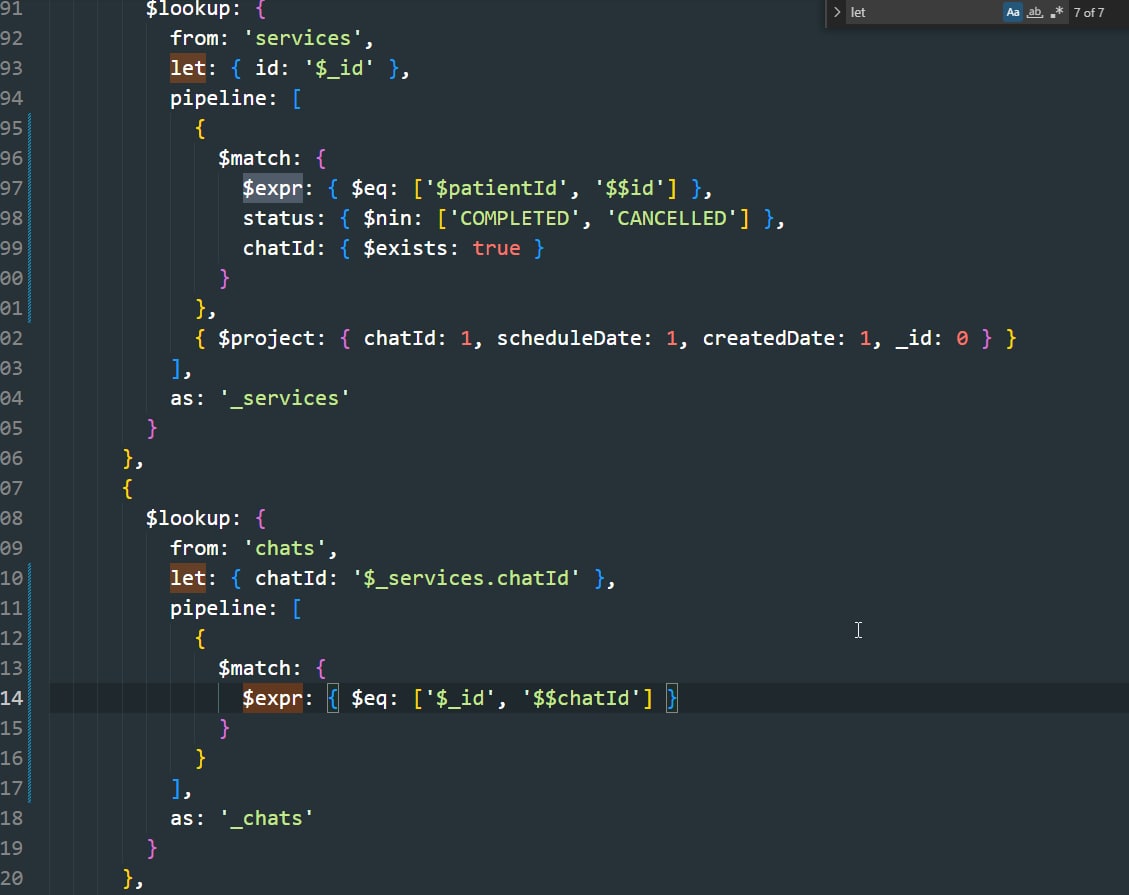 Ilnur
этот же код работает если второй lookup написан без пайплайнов
Ilnur
{
"$lookup": {
"from": "chats",
"foreignField": "_id",
"localField": "_services.chatId",
"as": "_chats"
}
},
вот так все ок
 Nick
Ilnur
я тут оптимизирую громоздкий запрос, анвинд не нагрузит еще больше создав еще больше документов?
Nick
я тут оптимизирую громоздкий запрос, анвинд не нагрузит еще больше создав еще больше документов?
нагрузит, но похоже лукап с пайплайном не работает над массивом как может работать лукап без пайплайна который вы выше приводили в пример
 Anonymous
Я не понял, сайт mongodb.com разблокировали?
Anonymous
С чего бы это? Всех денацифицировали что-ли?
Nick
С чего бы это? Всех денацифицировали что-ли?
почекал, аннонсов не было, так что разлочили и хорошо. А может случайно разлочили, они ж и блочили сначала коекак для видимости и изза того что нормально договора не намутить с оплатой изза санкций.
 Alexander
Привет, кто подскажет как правильно записывать в базу документы, чтобы параметр last_modified менялся, только если были изменения в других полях? сейчас так сделал, что меняется всегда, потому что как минимум last_modified отличается при подготовке документа
 dnacd 🦜
Nick
Привет, кто подскажет как правильно записывать в базу документы, чтобы параметр last_modified менялся, только если были изменения в других полях? сейчас так сделал, что меняется всегда, потому что как минимум last_modified отличается при подготовке документа
обычно на уровне приложения должно определять надо ли обновлять и если был вызов апдейта, то значит обновление всетаки фиксируется.
На уровень монги это вынести можно, но очень запарно получится и медленно по производительности. Для этого надо в фильтр апдейта указать все поля, так чтобы если они совпадают, то ни один док не подходил под выборку. В таком случае обновляться будет только, если поля отличаются. Само собой это выборка по всем полям и индексов не неастроишь если полей много
dnacd 🦜
извини, можешь подробнее? я пробую через replace_one
Создаешь ты методом криейт, обновляешь методом апдейт, вот и в апдейт методе обновляй поле ласт модифайд.
Alexander
обычно на уровне приложения должно определять надо ли обновлять и если был вызов апдейта, то значит обновление всетаки фиксируется.
На уровень монги это вынести можно, но очень запарно получится и медленно по производительности. Для этого надо в фильтр апдейта указать все поля, так чтобы если они совпадают, то ни один док не подходил под выборку. В таком случае обновляться будет только, если поля отличаются. Само собой это выборка по всем полям и индексов не неастроишь если полей много
а replace_one нельзя специфицировать? ПРоблема в том, что я обсчитываю пакетно - и на выходе пачка объектов, по каждому искать есть ли он базе или нет - показалось запарно. С одной стороны прекрасно подошел raplace_one с параметром upsert=True, с другой стороны хотелось бы монги подсказать, что если она делает именно replace, то чтобы обновляли бы и поле last_modified
Alexander
Создаешь ты методом криейт, обновляешь методом апдейт, вот и в апдейт методе обновляй поле ласт модифайд.
мой кейс выше описал. не очень подходит такое решение
Nick
Nick
а replace_one нельзя специфицировать? ПРоблема в том, что я обсчитываю пакетно - и на выходе пачка объектов, по каждому искать есть ли он базе или нет - показалось запарно. С одной стороны прекрасно подошел raplace_one с параметром upsert=True, с другой стороны хотелось бы монги подсказать, что если она делает именно replace, то чтобы обновляли бы и поле last_modified
но если у вас пакетка, то знаит вы можете нормальнго делать запросы на выборку для проверки факта было изменение или нет и быть уверенными что реплейс обновит только нужные доки. А то что не поменялось просто не закидывать в базу
Alexander
upsert=true и ваша хотелка несовместимы
но мне надо записывать документы, которые в пачке появились, а в базе ещё отсустствовали
Nick
но мне надо записывать документы, которые в пачке появились, а в базе ещё отсустствовали
тогда выборка из базы для првоерки наличия и есть ли изменения и потом уже сбор пачки
Alexander
понял, что задача не тривиальна) пойду пилить решение
Alexander
Nick
либо просто забить и обновлять last_modified)
Alexander
либо просто забить и обновлять last_modified)
потом запрос "изменные с послднего момента")) а отдавать обновления, потому что поменялос после "обновление" ? ))
Nick
потом запрос "изменные с послднего момента")) а отдавать обновления, потому что поменялос после "обновление" ? ))
такой большой объем не меняющихся данных что это будет на чтото влиять?
Alexander
такой большой объем не меняющихся данных что это будет на чтото влиять?
да, порядка 1 млн записей
Alexander
не спрашивай, почему я их пакетно пересчитываю - так надо(
Nick
да, порядка 1 млн записей
тогда давайте ваш сценарий, обновления всех данных проходит по факту каждый раз? как часто?
Alexander
в лс написал
Alexander
в общем в результате обсуждения - рекомендовано попробовать хеширование содержание документа, но при этом надо встроить проверку на образование дублей
Nick
потом расскажешь как поулчилось)
Ravshan
Доброго времени суток.
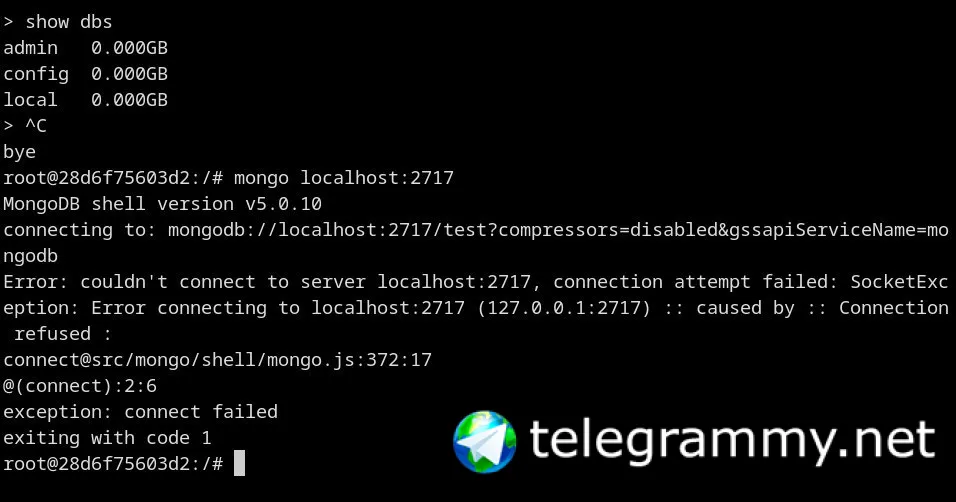
Как подключится через компас к реплике с 3 инстансами?
mongodb://localhost:27017,localhost:27018,localhost:27019/test?readPreference=nearest&replicaSet=rs0
не пашет такой варик
Anonymous
 Anonymous
Не могу понять, за что забанили мой основной аккаунт
 Alexander
Дмитрий
Всем привет
Дмитрий
вопрос такой, как измерить время ответа базы? либа MongoDB юзаю TS.
Nick
вопрос такой, как измерить время ответа базы? либа MongoDB юзаю TS.
тут не все так просто т.к. надо определиться что такое "время ответа". В общем случае оно включает все время обработки в драйвере, передачу по сети запроса, обработку в базе, получение ответа и его разор в коде, когда уже можно дальше работать с ответом. Если вам нужно такое комплексное время - то просто берете какой-нибудь инструмент сбора метрик (в ноде хз что популярно) и собираете время в коде в вызовах там где вам надо. Т.е. условно
t1 = currentTime()
sendMongoQuery()
t2 = currentTime()
metrics.registerTime("mongoreq", t2 - t1)
Делать сбор времени на вообще все запросы - смысла нет без сохранения запросов, а это как правило ничего не дает с точки зрения кода в виду большого количества запросов, которые не всегда имеют большой импакт.
В случае если надо просто находить медленные запросы - то для этого есть отслеживание медленных запросов в самой монге (https://www.mongodb.com/docs/cloud-manager/performance-advisor/slow-query-threshold/) и надо просто вытаскивать эти данные из монги - тут особо не подскажу автоматику на это не настраивал, но в логах все имеется и периодически погрепать было достаточно.
Бобомурод
всех горячо приветствую
скажите пожалуйста, как на самом беле Best Practice в названии коллекшнов и базы данных?
Коллекции называть с заглавной буквы?
вместо пробела использовать _ или - ?
Daniil
всех горячо приветствую
скажите пожалуйста, как на самом беле Best Practice в названии коллекшнов и базы данных?
Коллекции называть с заглавной буквы?
вместо пробела использовать _ или - ?
Это же просто нейминг, вкусовщина или что принято в компании/проекте
Но лично я везде видел только маленькие буквы и нижнее подчеркивание
Бобомурод
Это же просто нейминг, вкусовщина или что принято в компании/проекте
Но лично я везде видел только маленькие буквы и нижнее подчеркивание
спасибо, тоже решил пойти так, спрашиваю чтоб заранее избегать всяких неприятных вопросов во время аудита
 Тим
Ребят подскажите мне надо забрать список категорий, и подкатегорий, одним запросом можно это сделать?)
Бобомурод
скажите пожалуйста, если я использую последнюю версию монги в режиме реплика-сет из двух серверов базы данных то все операции insert и update уже будет работать как транзакции ?
Тим
Ребят подскажите мне надо забрать список категорий, и подкатегорий, одним запросом можно это сделать?)
забыл уточнить что бы в каждой категории был массив подкатегорий, я так понял надо забрать главные категории отдельно подкатегории и массивом пробегаться и вставлять сравнивая по ид но когда вложений 3-4 как это эффективней делать ?
Nick
скажите пожалуйста, если я использую последнюю версию монги в режиме реплика-сет из двух серверов базы данных то все операции insert и update уже будет работать как транзакции ?
нет, надо явно оформлять запросы в транзакцию. Сами по себе любые единичные операции в базе атомарны
Yura
 Yura
 Yura
 Alexandrr
всех горячо приветствую
скажите пожалуйста, как на самом беле Best Practice в названии коллекшнов и базы данных?
Коллекции называть с заглавной буквы?
вместо пробела использовать _ или - ?
нижний регистр, латиница, нижние подчёркивания
Phil
вопрос такой, как измерить время ответа базы? либа MongoDB юзаю TS.
explain() пишет время ответа без учета сети
Бобомурод
насколько целесобразно использовать Prisma в проекте где база монго ?
Алим
 Дмитрий
explain() пишет время ответа без учета сети
client.mongo.db('Misora').collection('Users').findOne({id: id}).explain() не существует 🤷 я пробывал такого метода нема
Phil
client.mongo.db('Misora').collection('Users').findOne({id: id}).explain() не существует 🤷 я пробывал такого метода нема
а это надо делать в mongosh
пример
db.users.find({username: { $regex: "^test", $options: "i" }}).explain("executionStats")
>
внимание на поля в executionStats
например
executionTimeMillis: 533,
totalKeysExamined: 652512,
totalDocsExamined: 172,
самые на мой взгляд полезные
Дмитрий
То есть в коде не выйдет?
Phil
То есть в коде не выйдет?
вы же на nodejs делаете? попробуйте как тут https://www.mongodb.com/community/forums/t/how-to-use-explain-in-node/126572/2
const result = await db.collection("Users").find().explain()
Phil
Да на ноде
я просто использую golang и у меня в драйвере нету explain(), так что приходится тестить в mongosh
возможно на js тоже убрали
Дмитрий
я просто использую golang и у меня в драйвере нету explain(), так что приходится тестить в mongosh
возможно на js тоже убрали
В mongoose я видел этот метод но он назывался exec()
Дмитрий
А вот перейдя на офф либу там такого не обнаружил