Дак я и говорю , локально не работает почему то. Сегодня буду разбираться
telnet localhost 27017
отвечает ?
 Serg


 MaryJ💻
Буду у компа покажу скрины
 Roman ;)
/stat@combot
Vladislav
Всем привет. Я к вам за помощью.
Мне необходимо сделать бэкап базы
Но при любом варианте команды mongodump я получаю ошибку.
один из примеров
mongodump --db test --archive=./backup/test_dump.gz --gzip
Failed: error getting collections for database test: error running listCollections. Database: test Err: command listCollections requires authentication
Образ mongo:5
Пробовал так же
mongodump -d <test > -u <rootuser> -p <rootpass> - -authenticationDatabase admin
Выручайте пожалуйста более опытные коллеги.
 Дмитрий
Всем привет. Я к вам за помощью.
Мне необходимо сделать бэкап базы
Но при любом варианте команды mongodump я получаю ошибку.
один из примеров
mongodump --db test --archive=./backup/test_dump.gz --gzip
Failed: error getting collections for database test: error running listCollections. Database: test Err: command listCollections requires authentication
Образ mongo:5
Пробовал так же
mongodump -d <test > -u <rootuser> -p <rootpass> - -authenticationDatabase admin
Выручайте пожалуйста более опытные коллеги.
Я примерно так делю
mongodump --uri mongodb://username:password@127.0.0.1:27017/&authSource=admin --database MyDatabaseName --out /mongodumps
Дмитрий
Ну и нужно следить за тем чтобы команда вызывалась с хоста, который добавлен в bindIp ( во моем случае это локалхост)
Roman ;)
Добрый день! Скажите пожалуйста, кто ни будь занимался целенаправленными тестами по WriteConcern? Пересмотрел весь канал, но ничего похожего не нашел. Документацию уже перечитали на несколько раз. Суть вопроса такая. Есть replica set из 7 нод: 1 мастер, 1 арбитр, 5 слэйвов. Пишем всегда через мастера, читаем предпочтительнее со слэйвов. На клиенте используем java драйвер. В ходе тестов пробовали с клиента, через драйвер задавай разные значения WriteConcern. И под нагрузкой при выпадении 50% от кластера, вставка замедляется. Потом решели отказаться через настройку в драйвере и указать WriteConcern на серверах. Но даже при установке WriteConcern в 1, при потере 50% от кластера вставка замедляется.
Возможно кто то скталкивался с таким? Возможно упустили еще какие сопуствующие настройки?
 yopp
Добрый день! Скажите пожалуйста, кто ни будь занимался целенаправленными тестами по WriteConcern? Пересмотрел весь канал, но ничего похожего не нашел. Документацию уже перечитали на несколько раз. Суть вопроса такая. Есть replica set из 7 нод: 1 мастер, 1 арбитр, 5 слэйвов. Пишем всегда через мастера, читаем предпочтительнее со слэйвов. На клиенте используем java драйвер. В ходе тестов пробовали с клиента, через драйвер задавай разные значения WriteConcern. И под нагрузкой при выпадении 50% от кластера, вставка замедляется. Потом решели отказаться через настройку в драйвере и указать WriteConcern на серверах. Но даже при установке WriteConcern в 1, при потере 50% от кластера вставка замедляется.
Возможно кто то скталкивался с таким? Возможно упустили еще какие сопуствующие настройки?
Попробуйте снять метрики, например используя pmm (https://www.percona.com/software/database-tools/percona-monitoring-and-management). Без метрик очень сложно сказать в чем может быть причина.
В случае с readConcern secondaryPreferred вполне вероятно что часть чтения уезжает на праймари
yopp
При увеличении чтения, меняется пропорция данных в кеше, плюс увеличивается I/O. Вероятно сокращение кластера на 1/2 создает нагрузку которую праймари с тем-же qos обеспечить не может.
В целом, масштабировать через увеличение нод в репликах создаёт наблюдаемые вами ситуации: нода стала недоступна, нагрузка перераспределилась по нодам, нагрузка на оставшиеся ноды перешла критический пороги кластер сильно деградирует или вообще становится недоступным.
По этому для масштабирования рекомендуется использовать шардирование
Roman ;)
Попробуйте снять метрики, например используя pmm (https://www.percona.com/software/database-tools/percona-monitoring-and-management). Без метрик очень сложно сказать в чем может быть причина.
В случае с readConcern secondaryPreferred вполне вероятно что часть чтения уезжает на праймари
Вопрос не в чтений. С readConcern все понятно
Roman ;)
проблема именно со вставкой
yopp
Чтение точно так-же как запись использует I/O ресурсы
Roman ;)
Вот тут как раз и наблюдаем странность
Roman ;)
вставка работает с замедлением
Roman ;)
а чтение ни разу не страдает
Roman ;)
по этому и задал вопрос
yopp
Увы, без метрик и подробностей того как собран тестовый стол, какие сценарию проверяются, я могу только гипотетически рассуждать.
Первое на что я бы обратил внимание, это на изменение io на праймари. После этого посмотреть не увеличивается ли лаг репликации
yopp
По io это используемая ширина, задержки на w/r, глубина очереди
Roman ;)
условно чтение держится на уровне 2,5К запросов (так приклада выдавала). А запись просела в 2 раза, с 1К до 0,5 и JMeter больше не хотел выдавать. При восстановлении больше 50% процентов (ввели обратно еще одну ноду), вставка вернулась в норму.
yopp
Плюс провести тесты с включеным профайлером на праймари
Roman ;)
В ходе тестов нагрузка как на оставшиеся в строю слэйвы, так и на мастере подскакивает незначительно, CPU с 10% до 30% при 8 ядрах. ОЗУ без изменений.
yopp
В профилях будет информация о локах, по ним составить графики. Вероятно там тоже картина изменится
yopp
В ходе тестов нагрузка как на оставшиеся в строю слэйвы, так и на мастере подскакивает незначительно, CPU с 10% до 30% при 8 ядрах. ОЗУ без изменений.
Задержки обычно вызваны дисковой подсистемой. Это второе узкое место после сети
Roman ;)
Хорошо, попробуем с профаулером. Спасибо за подсказку.
yopp
И io обязательно померяйте
yopp
И сеть :) может быть что пока кластер в штатном состоянии, ноды используют репликацию со вторичных нод , а при симуляции отказа праймари не хватает сети
Roman ;)
Еще один вопрос. Он уже касательно conenction Pool.
 Alexandrr
железо уже тюнили, все лимиты подняли
ну как писали выше, нужно брать метрики тачки и смотреть что проседает, потом копать по стороне ограничений оси
недавно сталкивался с лимитами скорости записи файлов в шиндовс долбанной (точнее скорости открытия буффера на операции r/w)
можно поглядеть как вариант
Roman ;)
Еще один вопрос. Он уже касательно conenction Pool.
Редко возникают проблемы с получением подключения из connection Pool. Драйвер не может получить подключение и отваливается по таймауту.
Пробовали ставить таймаут 5 секунд. Отваливается. Т.е. как будто моргает сеть. Но сетевики помочь ни чем не могут. Говорят у них все ровно.
Roman Khonichev
Редко возникают проблемы с получением подключения из connection Pool. Драйвер не может получить подключение и отваливается по таймауту.
Пробовали ставить таймаут 5 секунд. Отваливается. Т.е. как будто моргает сеть. Но сетевики помочь ни чем не могут. Говорят у них все ровно.
От драйвера зависит, но нам при морганиях помогло вот это - serverSelectionTryOnce=false
Roman ;)
От драйвера зависит, но нам при морганиях помогло вот это - serverSelectionTryOnce=false
Используем Java драйвер
Roman Khonichev
если однопоточный, то поможет
Roman Khonichev
если получали No suitable server found
Roman ;)
если получали No suitable server found
Получали именно тайм-аут, при попытке получить соединение из пула
 Murad
Я вот никак не пойму, что лучше:
a) В цикле запрашивать find_one
b) Один раз выгрузить по условию в список и в цикле доставать уже из списка
При условии что количество документов скажем 50
Roman Khonichev
Получали именно тайм-аут, при попытке получить соединение из пула
если в ошибке именно timeout - то это просто исчерпанный пул, либо загрузка в потолок
Roman ;)
По факту используем KMongo драйвер. Он в свою очередь обертка над Java.
Roman Khonichev
По факту используем KMongo драйвер. Он в свою очередь обертка над Java.
дословно как звучала ошибка?
Roman ;)
если в ошибке именно timeout - то это просто исчерпанный пул, либо загрузка в потолок
В лимит точно не упираемся. Стоит 1000 допустимых соединений до каждого хоста. И минимально в пуле всегда держится 10 соединений
Roman Khonichev
В лимит точно не упираемся. Стоит 1000 допустимых соединений до каждого хоста. И минимально в пуле всегда держится 10 соединений
никаких балансирующих прокси не стоит перед базой?
Roman Khonichev
в логах базы что-нибудь есть?
yopp
помоему там ограничение на 7, но в вашем случае должно хватить
Roman ;)
в логах базы что-нибудь есть?
В логах на серверах монги находили ошибки, что произошла потеря соединения до клиента и нет возможности отдать ответ.
Была мысль что это может быть связанно с idleTimeout настройкой. Так как при истечении этого тайм-аута соединения грохаются и потом пул заново наполняется до минимума.
Roman ;)
Но это предположение не подтвердилось, так как такого рода проблема выстреливает очень редко (за пол года поймали 3 раза). А idleTimeout стоит 20 минут.
Roman Khonichev
похоже на сеть, надо настраивать мониторинг админам и смотреть... есть какая-то регулярность когда это происходит?
Roman ;)
похоже на сеть, надо настраивать мониторинг админам и смотреть... есть какая-то регулярность когда это происходит?
Нет, проблема плавающая. Никакой закономерности нет.
Roman ;)
Ранее похожие проблемы ловили из за нехватки ОЗУ. Виртуалка давала показатели ниже чем по факту кушали. Из за этого при нагрузке, возникали похожие проблемы. Докинули ОЗУ до 32 ГБ. Из них сейчас отъедаем 24 ГБ. И в пике, при снятии полного дампа, средствами монги, получаем 28 ГБ.
Alexandrr
Странно что в некоторых ситуациях почти не бывает разнциы
ну попробуй найти 2к записей в коллекции где будет 10-15млн записей, увидишь разницу
 dnacd 🦜
 Jasur Sharofiddinov
hello guys, i m using MongoDB Atlas Search, can we avoid lowercase/uppercase in our full text search?
Alexandrr
hello guys, i m using MongoDB Atlas Search, can we avoid lowercase/uppercase in our full text search?
use operator's, find docs by this theme
https://www.bmc.com/blogs/mongodb-operators/
 Vladyslav
hello guys, i m using MongoDB Atlas Search, can we avoid lowercase/uppercase in our full text search?
one of the way to solve it:
create duplicate of your search property and put there Uppercase value. let`s call it propUpper
Then when perfroming search - do the upper transformation to your query property and search via propUpper
Vladyslav
another way is to use Regex, with case ignore, but in this case it will take time when your db is not small
Jasur Sharofiddinov
another way is to use Regex, with case ignore, but in this case it will take time when your db is not small
I m using this one, but i think i am skipping something and workin little bit slowly with regex😑
Jasur Sharofiddinov
another way is to use Regex, with case ignore, but in this case it will take time when your db is not small
Now i have small database which contains 2-3 k documents, but it wil be 500-1000 k in the future
Vladyslav
I m using this one, but i think i am skipping something and workin little bit slowly with regex😑
it will always work slowly.
my first option - is the fastest way
Jasur Sharofiddinov
it will always work slowly.
my first option - is the fastest way
Ok thanks i will try, if i have question i will ask.
Vladyslav
Ok thanks i will try, if i have question i will ask.
also you can try smth from there
https://www.mongodb.com/docs/manual/core/index-text/
And then you can combine performance 😊
Jasur Sharofiddinov
Shi
 Shi
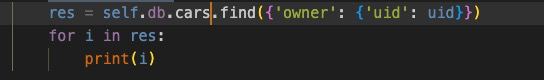
Большое спасибо, попробую
MaryJ💻
Дак я и говорю , локально не работает почему то. Сегодня буду разбираться
Короче проблема какая то с портами. Ошибка connect ECONNREFUSED 127.0.0.1:27027
MaryJ💻
Хрен знает че делать
MaryJ💻
При connect нажатии в moncoDB compas
 Nick
Короче проблема какая то с портами. Ошибка connect ECONNREFUSED 127.0.0.1:27027
проверьте что порт правильный указываете и что он поднят и слушается через netstat
Vladyslav
Короче проблема какая то с портами. Ошибка connect ECONNREFUSED 127.0.0.1:27027
а монго вообще установлен?