В ютубе можно посмотреть много видосов, думаю там быстр это можно усвоить)
ну сертификат лишним не будет
 Shane


 yopp
echo "deb [ arch=amd64,arm64 ] https://mirror.db-ai.co/apt/ubuntu focal/mongodb-org/4.4 multiverse" | sudo tee /etc/apt/sources.list.d/mongodb-org-4.4.list
все норм, но не хочет добавляться ключ, я что то делаю не так?
gpg --keyserver mirror.db-ai.co --recv 656408E390CFB1F5
Понял: зеркала сервера ключей пока нет, вы можете по официальной инструкции с pgp.mongodb.org их импортировать.
Добавлю сервер ключей на этой неделе
 ..
Anonymous
Кстати. deb-пакет с монгой самое то. И не надо никаких команд прописывать
 Konstantin
подскажите как в монге можно сделать сессионный лок (типа как pg_advisory_lock() в Postgres или get_lock() в Mysql).
Нужно чтобы в один момент времени из коллекции читал только один инстанс приложения, при этом писателей м.б. > 1
Nikita
Добрый день. Для отслеживания изменений документов добавил в Java два поля createdDate и lastModifiedDate с аннотациями Spring-а @CreatedDate и @LastModifiedDate,
Проблема в том, что при обновлении документа (через upsert) createdDate всегда сбрасывается и устанавливается текущее время изменения. Как можно сделать чтобы это поле не изменялось после создания, а изменялось только lastModifiedDate?
yopp
подскажите как в монге можно сделать сессионный лок (типа как pg_advisory_lock() в Postgres или get_lock() в Mysql).
Нужно чтобы в один момент времени из коллекции читал только один инстанс приложения, при этом писателей м.б. > 1
Здравствуйте! ручного управления локами в монге нет. Какую задачу вы решаете? Возможно есть другие варианты :)
 Nick
Добрый день. Для отслеживания изменений документов добавил в Java два поля createdDate и lastModifiedDate с аннотациями Spring-а @CreatedDate и @LastModifiedDate,
Проблема в том, что при обновлении документа (через upsert) createdDate всегда сбрасывается и устанавливается текущее время изменения. Как можно сделать чтобы это поле не изменялось после создания, а изменялось только lastModifiedDate?
настроить правильно аннотации, на креате дате не достаточно просто так его повесить, надо запретить его менять и еще чего сделать, но что именно уже не помню, думаю гугл с легкостью расскажет
Nikita
Konstantin
Здравствуйте! ручного управления локами в монге нет. Какую задачу вы решаете? Возможно есть другие варианты :)
Нужно что бы у коллекции был только один именнованный писатель. Т.е м.б. только один писатель Foo, один писатель Bar и тп. Если еще один писатель Foo придёт он заблокируют пока первый не отпустит лок.
 Ігор
Привет, а как можно с Аталаса експортировать бд на сервер?
Ігор
Не могу никак найти такой функции в атласе
 Al
 Al
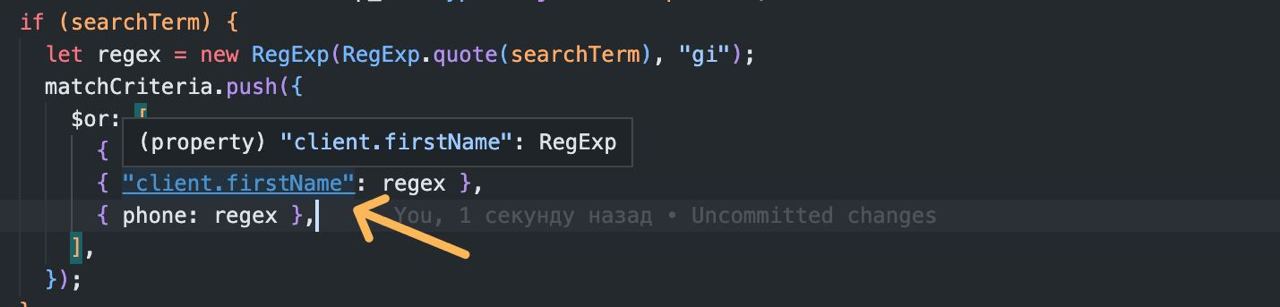
order.client.firstName - не работает
в кавычка тоже нет, знак доллара нельзя ставить, сам по себе firstName тоже не работает
Andrey
Нужно что бы у коллекции был только один именнованный писатель. Т.е м.б. только один писатель Foo, один писатель Bar и тп. Если еще один писатель Foo придёт он заблокируют пока первый не отпустит лок.
вы так и не ответили какую задачу решаете, вы описали процесс взаимодействия, который вам из неизвестной задачи нужен.
 Eva🇺🇦
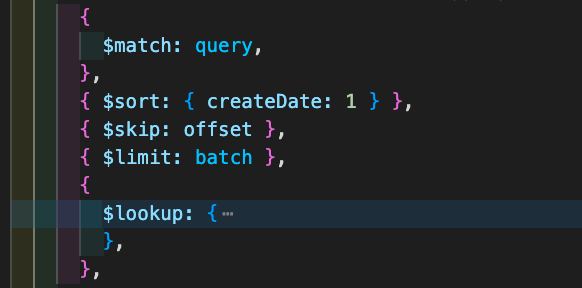
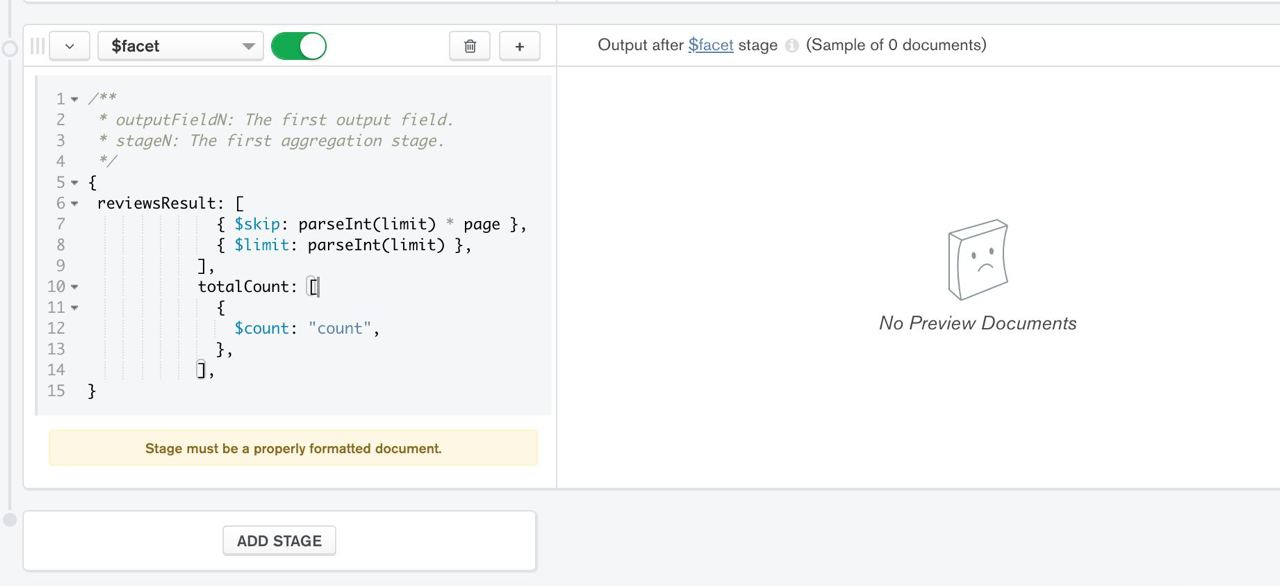
тяну пачками по 100 штук объекты через Model.aggregate. Сначала приходят массивы длиною по 100, в какой-то момент начинают приходить пустые, хотя skip/offset ещё не достиг своего максимума/конца. То есть из 1000 доков, например, приходит где-то 700, остальные 300 — пустые массивы
возможно, это связано с длиной соединения. Что подскажете?
 Flake
тяну пачками по 100 штук объекты через Model.aggregate. Сначала приходят массивы длиною по 100, в какой-то момент начинают приходить пустые, хотя skip/offset ещё не достиг своего максимума/конца. То есть из 1000 доков, например, приходит где-то 700, остальные 300 — пустые массивы
возможно, это связано с длиной соединения. Что подскажете?
Пальцем в небо: фильтрация до или после skip/offset?
Eva🇺🇦
 Eva🇺🇦
тяну пачками по 100 штук объекты через Model.aggregate. Сначала приходят массивы длиною по 100, в какой-то момент начинают приходить пустые, хотя skip/offset ещё не достиг своего максимума/конца. То есть из 1000 доков, например, приходит где-то 700, остальные 300 — пустые массивы
возможно, это связано с длиной соединения. Что подскажете?
Тут еще прикол, что это начинается на середине данных. Если всего документов 2к, то на 1к+ документах начнет приходить пустой массви. Если всего 400, то на 200+ и т.д.
Anonymous
Всем здравствуйте, где я могу найти примеры и туториалы как начать использовать mongo db и как записывать, узнавать данные
 Vladyslav
Всем здравствуйте, где я могу найти примеры и туториалы как начать использовать mongo db и как записывать, узнавать данные
https://www.mongodb.com/basics/crud
Anonymous
https://www.mongodb.com/basics/crud
Спасибо большое, а есть заготовка а которой происходит Коннект к кластеру чтоб потом с бд работать?
Vladyslav
Спасибо большое, а есть заготовка а которой происходит Коннект к кластеру чтоб потом с бд работать?
не хочу весь google сюда перекидывать))
уверен как законектить DB ты сможешь найти
Anonymous
ConfigurationError(str(exc))
pymongo.errors.ConfigurationError: cannot open /etc/resolv.conf
Anonymous
2 строчки с импортом и коннектом написал уже ошибка
import pymongo
client = pymongo.MongoClient('mongodb+srv://несмотрисюда:айайай@cluster0-ysglw.mongodb.net/')
Anonymous
Что делать я уже устанавливал pymongo[srv]
Anonymous
Помогите
 DG
Motor
 Daniel
у меня сайт монги не работает через vpn
это как-то лечится?
Daniel
https://docs.db-ai.co/docs/manual/ это зеркало использовать?
Ігор
Привет, а как можно изменить название базы данных в монго 5?
 Jasur Sharofiddinov
Hello, anyone used graphlookup in mongoDb for hierarchy data?
I m gettin a result, but not in order, any way to take hierarchy path ? sort method didnt help me
Al
 MaryJ💻
 MaryJ💻
 MaryJ💻
 MaryJ💻
 MaryJ💻
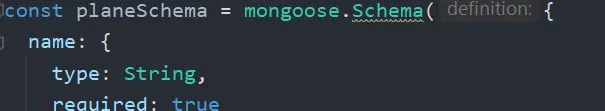 MaryJ💻
у меня сайт монги не работает через vpn
это как-то лечится?
У меня работает ) Поставь другой vpn
 Sardor
MaryJ💻
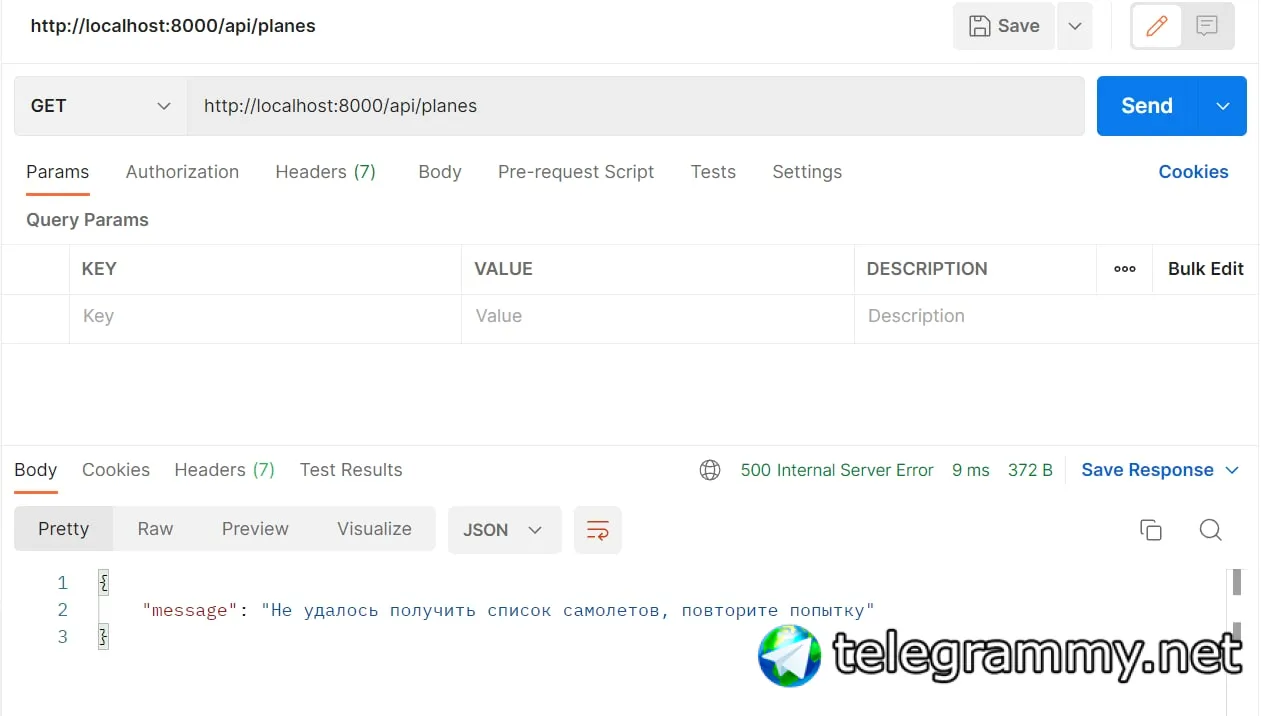
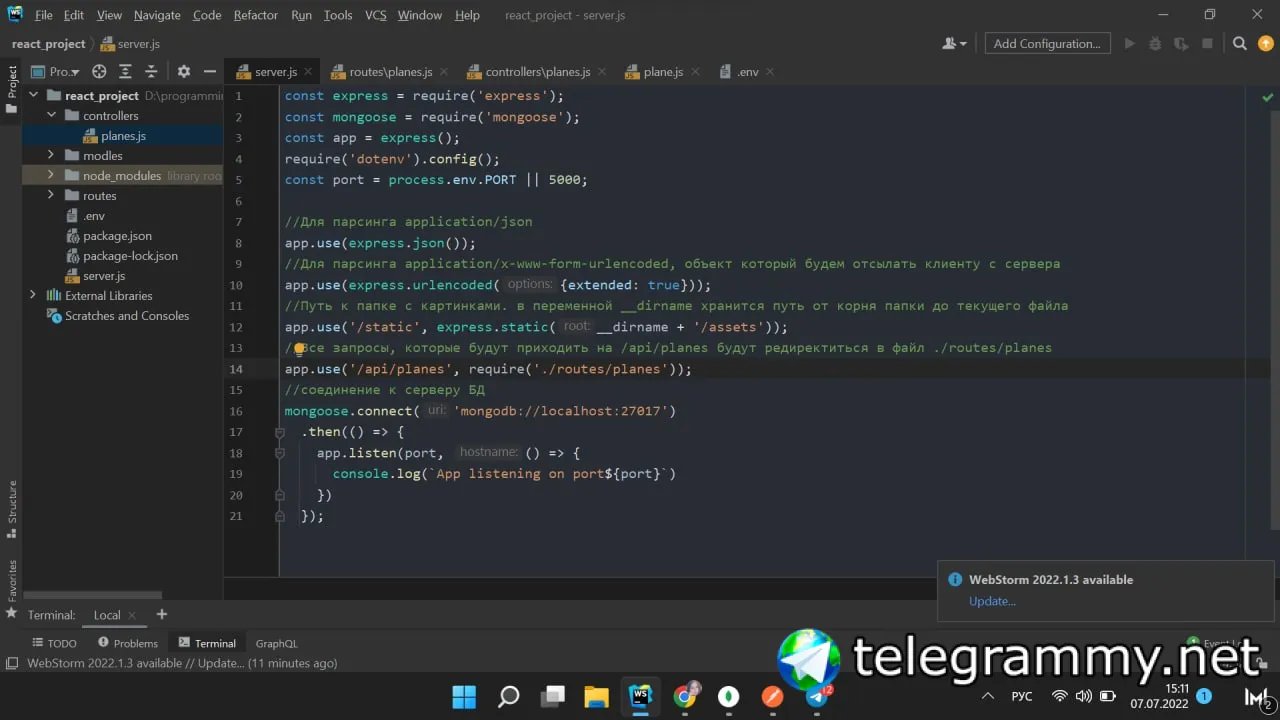
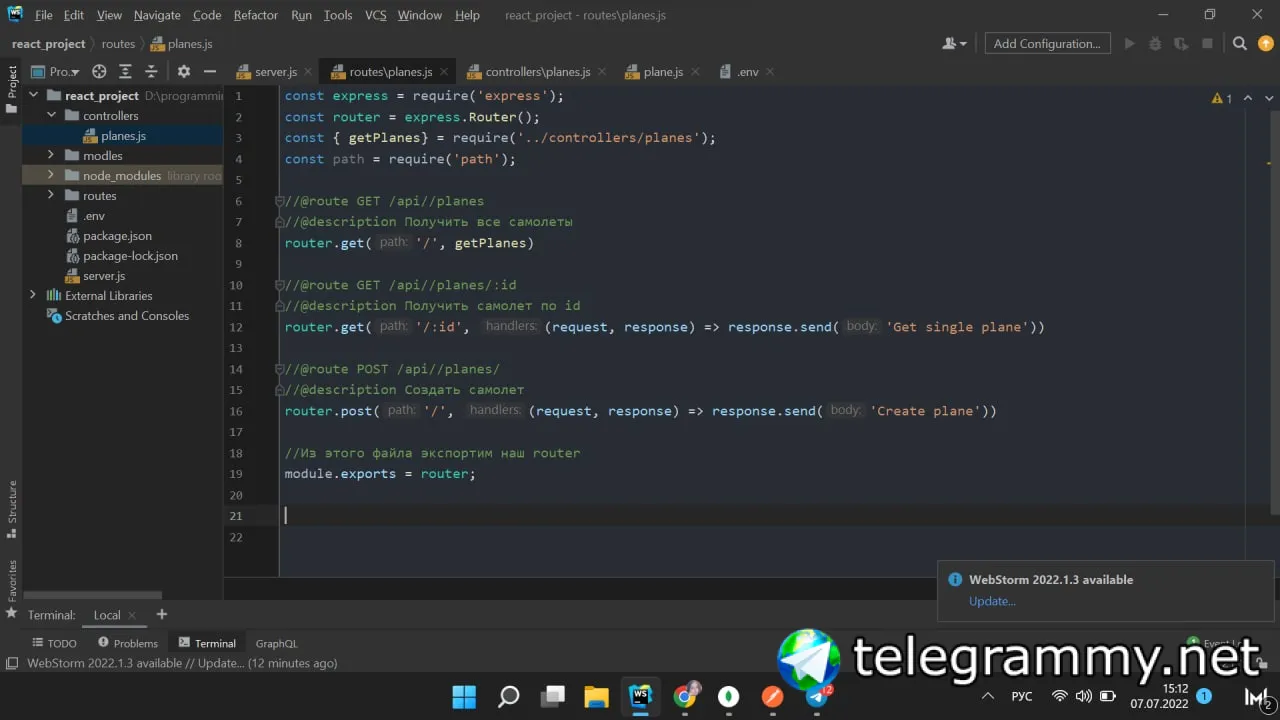
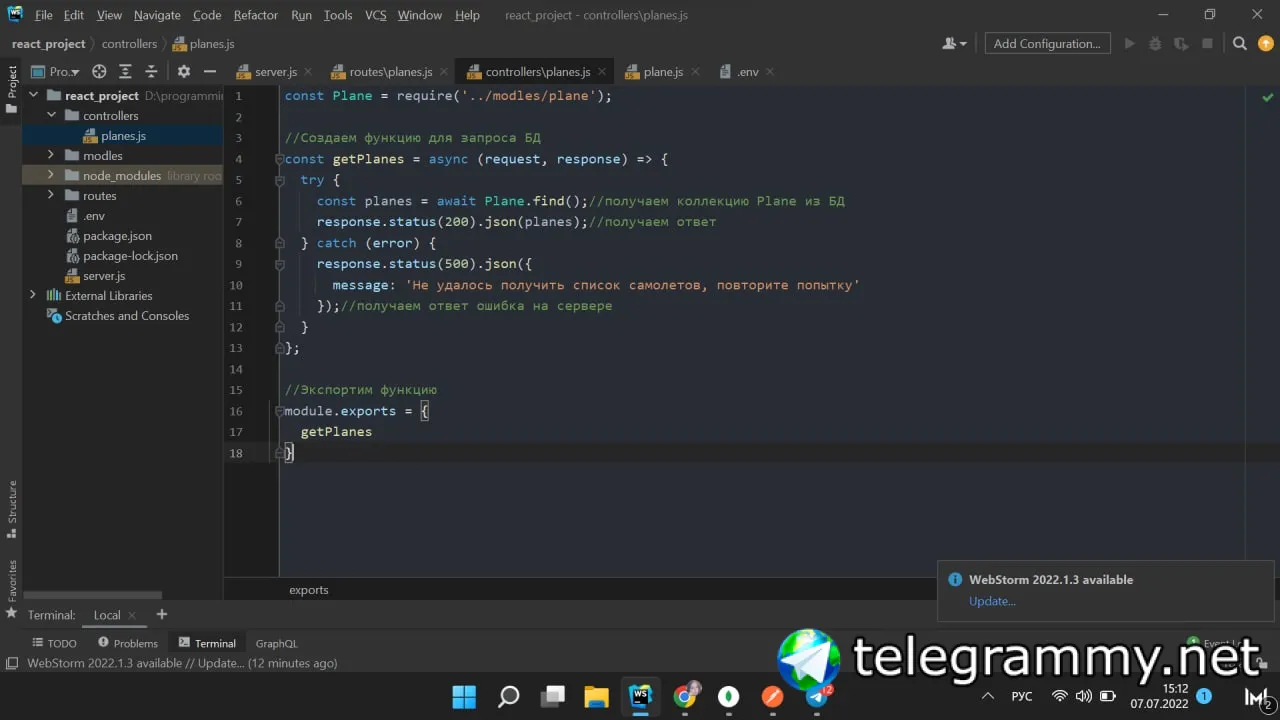
No, for the sale of planes)
Кылыч
здрасьте! господа, подскажите плиз, а возможно ли обновить документы, которые были найдены через findQuery? т.е. я сперва вытаскиваю query через find, делаю кое-какие операции через используя query, затем обновляю его
 Артем
здрасьте! господа, подскажите плиз, а возможно ли обновить документы, которые были найдены через findQuery? т.е. я сперва вытаскиваю query через find, делаю кое-какие операции через используя query, затем обновляю его
Посмотрите в сторону upsert https://www.mongodb.com/docs/manual/reference/method/Bulk.find.upsert/
Кылыч
Посмотрите в сторону upsert https://www.mongodb.com/docs/manual/reference/method/Bulk.find.upsert/
немного не подходит под мои нужды, просто я процессю стрим, который получаю от findQuery и вот после процессинга нужно обновить все доки в findQuery
Артем
А, обязательно скачивать документы
Кылыч
ну через стрим да, чтобы я мог из него слепить csv и выгрузить его в облачное хранилище
Артем
А чем просто update по _id не подходит?
Артем
Сделал find, потом обновил. Можно даже в транзакции если атомарно несколько нужно обновлять
Кылыч
а если доков будет тысяча, не захлебнется монга?
Артем
А вы их за раз апдейтите или по очереди?
Артем
Я в одной транзакции апдейтил несколько тысяч доков и было ок
Артем
Тут наверное вопрос в модели, для меня звучит не совсем очевидно почему надо именно апдейтить док, а не условно инсертить новый в другую коллекцию
Кылыч
хмм, хороший вопрос
Кылыч
мой кейс таков: обновление документа, чтобы актуализировать инфу о том что данные синхронизированы, т.е. выгружены в облако. для этого я просто поставил флаг, который будет как раз таки показывать статус синхронизации
Артем
А объект только один раз синхронизируется за всю историю?
Артем
Или он поменялся, флаг сбросился, а потом синхронизировался и флаг установился
Артем
А нагрузка может быть условно любой?
Кылыч
пока что нагрузки небольшие, но вполне вероятно что она может увеличиться, поэтому хочется это сразу учесть
Артем
У меня была похожая задача синхронизации большого количества записей. Я это в итоге делал так: мне прилетал огромный список, я его резал на чанки по 10к записей, обрабатывал эти 10к (делал синхронизацию с хранилищем и уведомлял систему об обновлении), брал следующие и тд. Потому что если этого не делать, то в случае если прилетит 1М записей, то в оперативную память ничего не поместится. А если по одной записи апдейтить, то из за сетевых задержек это все будет происходить очень долго
Артем
В итоге я прикинул выгодный фиксированный размер чанка, который отрабатывается нормально монгой в одной транзакции (там были инсерты правда) и с ним работал. В итоге и нет риска что большая пиковая нагрузка убьет все, и не слишком долго работает. В каком то смысле здесь моделируется очередь
Артем
Может поможет, хз. А насчет того где флаг хранить, если это один раз за все время, то наверное не особо важно
Кылыч
спасибо за шейринг! пойду обмозговать
Кылыч
https://www.mongodb.com/docs/v4.4/reference/method/js-cursor/ - методы курсора подойдут для работы чанками, не так ли?
Артем
Ну я это через метод limit делал
 Alexandrr
всем привет.
столкнулся с проблемой структуры данных:
1. из-за уникальности каждой записи, невозможно создать группирующие индексы
2. увеличив количество записей в 1 коллекции с 800к до 5 млн получил серьёзное замедление .find()
3. если при количестве 800к записей в коллекции поиск длился 560 ms, то с 5 млн длительность поиска возросла кратно
4. так например при 2.3 млн записей = 1.6 сек, при 5.2 млн = 3.3 сек
каким образом можно обойти это или решить?
п.с.
экспериментировал с ключами
с их длиной для каждой записи
с их типом полей текстовые или структурные
= результат поиска по длительности одинаковый.
Nick
всем привет.
столкнулся с проблемой структуры данных:
1. из-за уникальности каждой записи, невозможно создать группирующие индексы
2. увеличив количество записей в 1 коллекции с 800к до 5 млн получил серьёзное замедление .find()
3. если при количестве 800к записей в коллекции поиск длился 560 ms, то с 5 млн длительность поиска возросла кратно
4. так например при 2.3 млн записей = 1.6 сек, при 5.2 млн = 3.3 сек
каким образом можно обойти это или решить?
п.с.
экспериментировал с ключами
с их длиной для каждой записи
с их типом полей текстовые или структурные
= результат поиска по длительности одинаковый.
из-за уникальности каждой записи, невозможно создать группирующие индексы
Что мешает? Уникальность не помеха в чоздании индексов
Alexandrr
из-за уникальности каждой записи, невозможно создать группирующие индексы
Что мешает? Уникальность не помеха в чоздании индексов
каждая запись имеет такой вид:
{"p": "provider", "w": warehouse, "a": article, "i": info}
где:
р - поставщик (текстовая запись не более 25 символов)
w - название склада (не более 65 символов)
a - артикул (не более 16 символов)
i - [структура, с, объектами, данных]
пробовал:
так .create_index([('p', 'text')], name='p') (от каждого поставщика примерно 500-800к записей)
и так .create_index([('w', 'text')], name='w') (в каждом складе от 1к до 230к записей)
и так .create_index([('a', 'text')], name='a') (каждый артикул уникален)
результат по скорости поиска не изменялся.
скорость замерял с помощью:
.explain()['executionStats']['executionTimeMillis']
может я чего не пойму в создании индексов?
- доку вроде курил часа полтора, вычитал всё на офф сайте про индексы
- окольные статьи перечитал
- оверфлоу перегуглил
- форумы перешарил
Eva🇺🇦
при большом лимите в 5к доков (всего 12к, тяну пачками) возвращает пустой массив
в чем может быть проблема?
Alexandrr
А сам планировщик что пишет? Он пользуется индексами в итоге?
хороший вопрос, надо глянуть на досуге
Артем
Плюс вы делаете по индексу на каждое поле, возможно стоит посмотреть на вот эту вещь https://www.mongodb.com/docs/manual/core/index-text/#wildcard-text-indexes
Артем
Если вы хотите что условно "все текстовые поля были индексированы"
Артем
Но это конечно не имеет отношения к тому, что у вас .find() по индексированному полю с коллекцией 5.2 млн записей ищет 3 секунды, это как то совсем долго
Eva🇺🇦
а в монго лимит на один документ 16 мб, или на пачку данных?
Alexandrr
а в монго лимит на один документ 16 мб, или на пачку данных?
на запись в коллекции, согласно спецификации BSON
Eva🇺🇦
на запись в коллекции, согласно спецификации BSON
то есть в ответе с бд может прийти и 100мб данных, и 200..?
просто помню как-то запрос делала, где $in юзала. у меня была ошибка тогда, кажется, что мой запрос весит больше 16 мб
Alexandrr
то есть в ответе с бд может прийти и 100мб данных, и 200..?
просто помню как-то запрос делала, где $in юзала. у меня была ошибка тогда, кажется, что мой запрос весит больше 16 мб
в запросе у меня например, где 5 млн записей щас тестирую, приходит 1.7 гб ответ (если все записи извлекаю), так что да, может, но не более 16 мб в 1 записи