touchVPN, psiphon и warp чет не робят, посоветуешь что нибудь другое?
https://windscribe.com
 Null


 Max
Работают
с телефона или десктопа? у меня с телефона, вроде, ок, а вот расширение в хроме не конектится
 Alexander
с телефона или десктопа? у меня с телефона, вроде, ок, а вот расширение в хроме не конектится
Расширение работало вчера. Сегодня не проверял. На десктоп есть и приложение
Andrey
бред какой-то, мотор асинхронный, его использовать там где вы используется asyncio.
у меня в базе записей 9.7 миллиардов, ответ прилетается в 200мс, все это на 1 "офисной машине"
Andrey
1 сервер, без кластера
 akbarov
Всем привет!
Как удалить документы в определенном временном промежутке? В каждом документы есть поле updated в котором и записан время записи этого документа
akbarov
То есть я хочу удалить документы которые записались в опреленный промежуток времени но пока не знаю куда даже копать
 dnacd 🦜
Всем привет!
Как удалить документы в определенном временном промежутке? В каждом документы есть поле updated в котором и записан время записи этого документа
в чем проблема сделать выборку где created at < 28.05 AND created at > 25.05
вот тебе и промежуток 3 дня
 Ilya
Привет!
Вопрос гуру монго: надо хранить контент файла и мета информацию к нему. Стоит ли разносить это на две сущности или можно всё в одну коллекцию?
 Влад
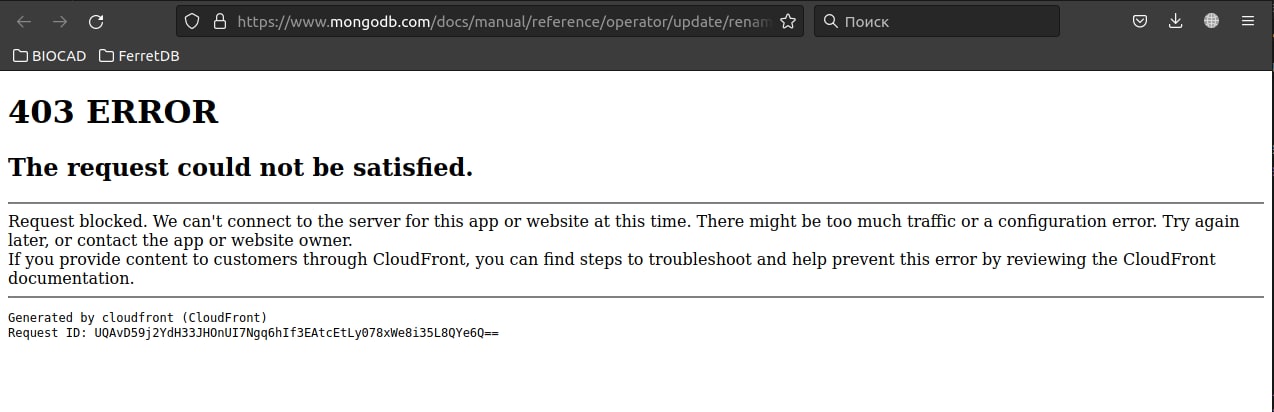
Монго локнули юзерам из рф доступ к сайту?
 Nick
Привет!
Вопрос гуру монго: надо хранить контент файла и мета информацию к нему. Стоит ли разносить это на две сущности или можно всё в одну коллекцию?
что дальше с файлами будет происхоидить? будет ли их обработка вестись внутри или это для отдачи юзерам? как часто к ним доступ будет происходить?
Татьяна
Привет!
Необходим результат из одной и той же таблицы, где колонки не равны друг другу
select * from [table]
where field1 != field2
unknown top level operator $expr
На функцию find ругается mismatch exception
db.report.find()
Подскажите, пожалуйста, что не так? Куда можно покопать?
Nick
если он работает и делает что надо, то неважно
Nick
Привет!
Необходим результат из одной и той же таблицы, где колонки не равны друг другу
select * from [table]
where field1 != field2
unknown top level operator $expr
На функцию find ругается mismatch exception
db.report.find()
Подскажите, пожалуйста, что не так? Куда можно покопать?
используйте агрегацию, https://stackoverflow.com/a/41378906
Татьяна
используйте агрегацию, https://stackoverflow.com/a/41378906
спасибо большое за совет!
оказывается версия монго кастированная, поэтому и возникали ошибки
Вячеслав
Всем привет. Как вручную в репликасете поменять свапнуть релику на мастер
Вячеслав
rs.reconfig()
 Евгений
Привет всем!
Сейчас ковыряю одного исходники одного бота. В нём используется mongodb. Я с ней не знаком. Только читал, что это документированная СУБД, у которой не надо предварительно объявлять структуру таблиц.
Если БД уже поднята в docker, то какой командой получить структуру БД и данные из таблиц?
docker exec -it mongodb_container ...
Nick
удаление с фильтром, которые исключает доки которые надо оставить
Ilya
что дальше с файлами будет происхоидить? будет ли их обработка вестись внутри или это для отдачи юзерам? как часто к ним доступ будет происходить?
Мета информация будет использоваться для поиска того или иного контента, но сам контент будет не всегда использоваться. Т.е. он еще будет "транслироваться" на S3 и т.п. - и браться браузерами в основном оттуда.
 Сергей
Ребят, подскажите как грамотно хранить историю статусов
У меня есть несколько связанных моделей, для них нужно вести историю изменений статусов. Например (на проверку, есть ошибки + комментарий, принято). Статус состоит из id действия, автора, даты и комментарий если есть
Так же мне нужна возможность получить историю статусов по всем моделям
Вижу два варианта
1. Делать для каждой модели массив со статусами. Для получения истории проходить по всем моделям, вытягивать массив и сортировать по дате
2. Сделать отдельную модель с типом модели к которой этот статус относится, id модели и остальными свойствами. Но с этим вариантом не понятно где хранить enumы для действий. В сервисах к которым относятся статусы или в сервисе статусов
 Дмитрий
Ребят, подскажите как грамотно хранить историю статусов
У меня есть несколько связанных моделей, для них нужно вести историю изменений статусов. Например (на проверку, есть ошибки + комментарий, принято). Статус состоит из id действия, автора, даты и комментарий если есть
Так же мне нужна возможность получить историю статусов по всем моделям
Вижу два варианта
1. Делать для каждой модели массив со статусами. Для получения истории проходить по всем моделям, вытягивать массив и сортировать по дате
2. Сделать отдельную модель с типом модели к которой этот статус относится, id модели и остальными свойствами. Но с этим вариантом не понятно где хранить enumы для действий. В сервисах к которым относятся статусы или в сервисе статусов
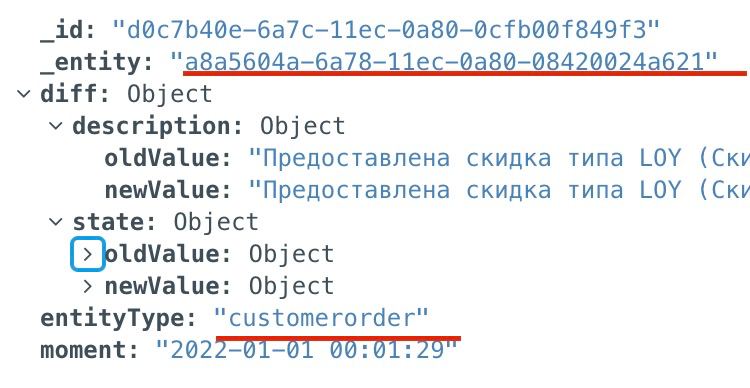
Я бы делал отдельную коллекцию, которая содержит список изменений:
item
date
who
diff
state
oldvalue
newvalue
Дмитрий
Такая таблица будет не привязана к типу изменяемой сущности и не бужет ограничиваться только статусом
Сергей
Я бы делал отдельную коллекцию, которая содержит список изменений:
item
date
who
diff
state
oldvalue
newvalue
Изменений данных при переключении статусов не предполагается
Они нужны для общения пользователей
Сергей
Изменений данных при переключении статусов не предполагается
Они нужны для общения пользователей
Например проверка документа
Клиент отправил
Админ проверил и ответил, что есть ошибки
Если документ неправильный
Клиент отправляет новый
Дмитрий
Я не оч. въехал. Но мой подход вроде как должен всё это покрывать. В самом документе храним последний актуальный статус, а при необходимости выводим список в них изменений для документа
Дмитрий
В любом случае при изменении статуса у вас документ изменяется, а вы пишите что изменений данных нет
 Mr Koala
Салют, кто нибудь сталкивался с тем что documentCount за минуту не может обсчитать 300к документов, фильтр вида ‘users.link’: /google.com/i
Вячеслав
Всем привет. Такой вопрос. Увеличил кэш, после наполнения кэша io диска увеличилось, нагрузка на сервер не увеличивалась. С чем может быть связано?
 yopp
Салют, кто нибудь сталкивался с тем что documentCount за минуту не может обсчитать 300к документов, фильтр вида ‘users.link’: /google.com/i
Если у вас нет индекса по users.link, то это нормально.
Но даже с индексом, такое регулярное выражение будет требовать полного сканирования индексов. Но для 200к документов это должно быть не больше пары секунд
yopp
Всем привет. Такой вопрос. Увеличил кэш, после наполнения кэша io диска увеличилось, нагрузка на сервер не увеличивалась. С чем может быть связано?
Установка размера кэш WT в основном имеет смысл когда монга не видит реальный объём памяти, например в контейнере
Когда вы увеличиваете размер кэш WT, уменьшается объём памяти который ОС может использовать как дисковый кэш.
Так как WT кэш хранит разжатые документы, а дисковый кэш уже сжатые, то увеличение размера WT кэша может уменьшить объём данных хранимых в памяти, что потребует больше io
Вячеслав
Установка размера кэш WT в основном имеет смысл когда монга не видит реальный объём памяти, например в контейнере
Когда вы увеличиваете размер кэш WT, уменьшается объём памяти который ОС может использовать как дисковый кэш.
Так как WT кэш хранит разжатые документы, а дисковый кэш уже сжатые, то увеличение размера WT кэша может уменьшить объём данных хранимых в памяти, что потребует больше io
спасибо за пояснение, я так и думал. Потому что дисковый кэш уменьшился.
Вячеслав
Единственное что монга не съела всю память, которую я ей выделил
 fenogentov
 Nick
LiteDB по-прежнему доступен
 ᅠ
При попытке сохранить экземпляр класа с вложеным типом в бд появляеться такая ошибка
ᅠ
 Nick
 Maksim
там же русским языком даже написано
Забавно выходит. Люди уже даже ошибки на русском не понимают, не то что на английском
Сергей
Я не оч. въехал. Но мой подход вроде как должен всё это покрывать. В самом документе храним последний актуальный статус, а при необходимости выводим список в них изменений для документа
Понял
Получается для каждой модели нужна такая дополнительная для истории изменений?
Дмитрий
Понял
Получается для каждой модели нужна такая дополнительная для истории изменений?
Я обхожусь одной коллекцией в этом случае
Дмитрий
 Дмитрий
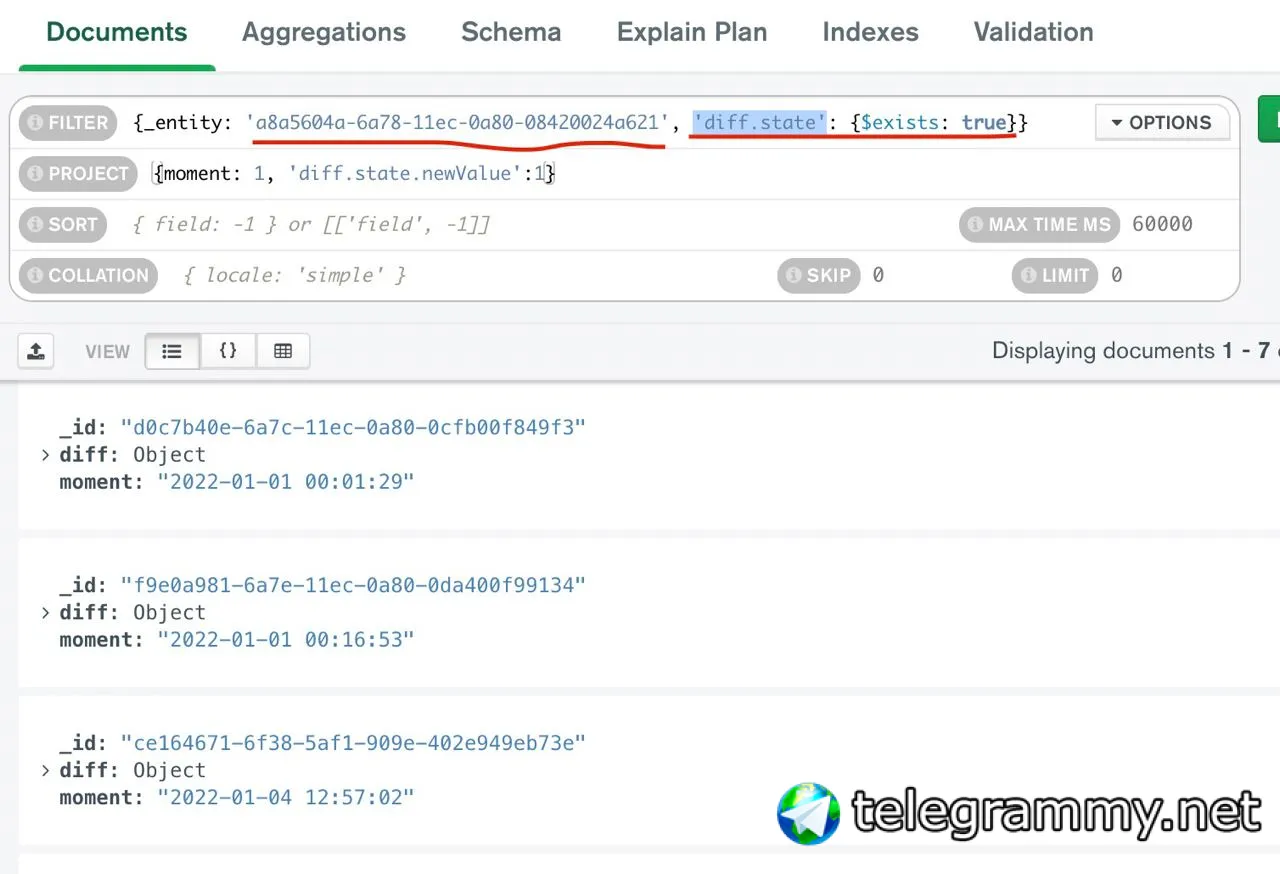
Там особенности наименования ключей, поэтому не обращайте внимания на них. Но суть понятна.
Ссылка на таблицу, ссылка на объект и сами изменения
Дмитрий
 Cloud
я правильно понимаю, что монга не сразу данные вставляет/обновляет
а типо буфферизует их, и делает это потом?
akbarov
Привет всем!
Что можно почитать чтобы понять почему Mongo тормозить при aggregate запросах? Запрос занимает порядка 3 минут
 🅰️nimeCoder
Сам попросил чо почитать
Nick
Привет всем!
Что можно почитать чтобы понять почему Mongo тормозить при aggregate запросах? Запрос занимает порядка 3 минут
начните с профилирования через explain и добавьте индексов где надо, а если индексы не решают проблему, то меняйте порядок стейджей, чтобы максимально сузить объемы обрабатываемых данных, ну и на крайняк меняйте структуру данных
akbarov
начните с профилирования через explain и добавьте индексов где надо, а если индексы не решают проблему, то меняйте порядок стейджей, чтобы максимально сузить объемы обрабатываемых данных, ну и на крайняк меняйте структуру данных
Насколько я понимаю это происходит из-за того что я ищу в вложенных списках, можно ли как это решить?
Nick
Насколько я понимаю это происходит из-за того что я ищу в вложенных списках, можно ли как это решить?
зависит от как именно ищите, какие объемы, какая структура данных, чтото можно по другому сделать, а чтоот нет изза структуры
akbarov
Alexander
Привет всем. Подскажите, как мне найти последовательности в данных? у меня есть данные по дням:
username-date-condition. Хотелось бы сделать выборку username-condition-date_from-date_to
Alexander
по поиску MongoDB find unbreakable sequence ничего не нахожу ,(
Nick
по поиску MongoDB find unbreakable sequence ничего не нахожу ,(
не совсем ясно что нужно, пока выглядит как просто $and:[$gte,$lt]
Alexander
не совсем ясно что нужно, пока выглядит как просто $and:[$gte,$lt]
есть данные типа:
"Коля" "01.05" "работал"
"Коля" "02.05" "не работал"
"Коля" "03.05" "не работал"
"Коля" "05.05" "не работал"
"Коля" "06.05" "работал"
Хочу получить:
"Коля" "не работал" "02.05" - "05.05"
Nick
а по сути тут напрашивается группировка, над прикинуть как бы сделать такое
Alexander
а по сути тут напрашивается группировка, над прикинуть как бы сделать такое
да, напрашивается. только я не очень дружен с aggregate, поэтому решил спросить - мало ли у кого рецепт есть
Alexander
кейс казался частым
dnacd 🦜
dnacd 🦜
или тебе нужен промежуток неработающего коли
dnacd 🦜
просто по твоей логике КОля может работать 03.05, но всё равно тебе выдаст "Коля" "не работал" "02.05" - "05.05"
Alexander
или тебе нужен промежуток неработающего коли
1. У Коли могут быть дальше в мае ещё "не работал"
2. На выходе хотелось бы получить группировку по промежуткам с какого, по какое число он не работал
Alexander
просто по твоей логике КОля может работать 03.05, но всё равно тебе выдаст "Коля" "не работал" "02.05" - "05.05"
нет, тогда надо чтобы было две строки
Alexander
типа как сжатие по признаку
dnacd 🦜
типа как сжатие по признаку
а что если просто взять выборку по дням, и посчитать где коля не работал?
или нужны прям даты?
Alexander
"Коля" "01.05" "работал"
"Коля" "02.05" "не работал"
"Коля" "03.05" "не работал"
"Коля" "05.05" "не работал"
"Коля" "06.05" "работал"
"Коля" "07.05" "работал"
"Коля" "08.05" "не работал"
"Коля" "09.05" "работал"
"Коля" "10.05" "не работал"
"Коля" "11.05" "не работал"
"Коля" "12.05" "не работал"
На выходе:
"Коля" "не работал" "02.05" - "05.05"
"Коля" "не работал" "08.05" - "08.05"
"Коля" "не работал" "10.05" - "12.05"
ну или около того
Alexander
Nick
примерно update($set: {time.sent_to_moderators: new Date })
дальше смотрите как у вас это делается
Nick
"Коля" "01.05" "работал"
"Коля" "02.05" "не работал"
"Коля" "03.05" "не работал"
"Коля" "05.05" "не работал"
"Коля" "06.05" "работал"
"Коля" "07.05" "работал"
"Коля" "08.05" "не работал"
"Коля" "09.05" "работал"
"Коля" "10.05" "не работал"
"Коля" "11.05" "не работал"
"Коля" "12.05" "не работал"
На выходе:
"Коля" "не работал" "02.05" - "05.05"
"Коля" "не работал" "08.05" - "08.05"
"Коля" "не работал" "10.05" - "12.05"
ну или около того
не работал определяется по последней отметке когда он именно не работал, а не по следующему рабочему дню?
Alexander
не работал определяется по последней отметке когда он именно не работал, а не по следующему рабочему дню?
по прерыванию последовательности, наверное по следующему рабочему
Alexander
не работал определяется по последней отметке когда он именно не работал, а не по следующему рабочему дню?
Хотя сейчас сделал group, получается можно и по разрыву в последовательности лат