 Andrey


 Rauan
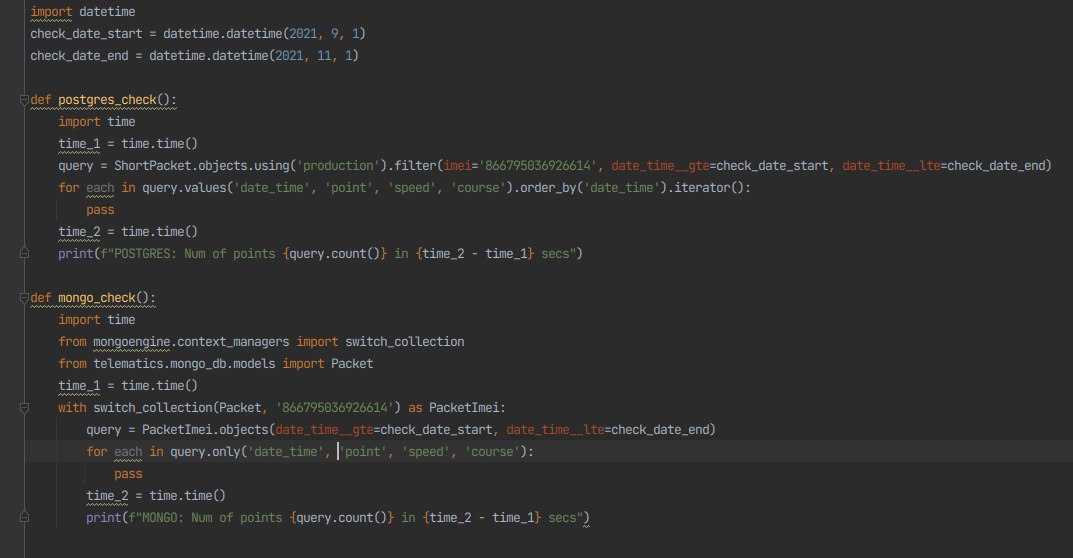
По этому коду(он абстрактный) можно ли что-то сказать, не знаю.
да понимаю. он написан на mongoengine (django). но суть в том что запросы по одному трактору в постгрес работает быстрее среди множество точек где есть данные с многих тракторов чем монго которые сохраняет каждый трактор в отдельном коллекшне. Постгрес 180млн точек 213 тракторов и монго где каждый трактор сохранен отдельно
Andrey
да понимаю. он написан на mongoengine (django). но суть в том что запросы по одному трактору в постгрес работает быстрее среди множество точек где есть данные с многих тракторов чем монго которые сохраняет каждый трактор в отдельном коллекшне. Постгрес 180млн точек 213 тракторов и монго где каждый трактор сохранен отдельно
вообще не факт, какие индексы, какие запросы, как документы извлекаете, какой структуры документы, может вы выгружаете из монги документы целиком, а они большие
Rauan
вообще не факт, какие индексы, какие запросы, как документы извлекаете, какой структуры документы, может вы выгружаете из монги документы целиком, а они большие
индексация одинаковая для обоих бд (date_time), а извлекаю я только 4 параметра как вы видите в коде 'date_time', 'point', 'speed', 'course' они все стринг и int
Andrey
индексация одинаковая для обоих бд (date_time), а извлекаю я только 4 параметра как вы видите в коде 'date_time', 'point', 'speed', 'course' они все стринг и int
да увидел, а индекс по imei в монге. я не работаю в питоне с mongoengine
Rauan
да увидел, а индекс по imei в монге. я не работаю в питоне с mongoengine
там смысла не было потому что каждый имей это уникальный айди трактора, значит в одном коллекшне только будет один и тот же имей
Andrey
там смысла не было потому что каждый имей это уникальный айди трактора, значит в одном коллекшне только будет один и тот же имей
не понял, у вас _id - imei, или в коллекции все записи и везде один imei - и вы просто "сканируете" всю коллекцию с фильтром по времени?
Rauan
_id != imei, по архитектуре imei уникальный для трактора. Вы правы, я просто сканирую по времени в коллекшне потому что каждый коллекшн для одного imei
Rauan
там смысла не было потому что каждый имей это уникальный айди трактора, значит в одном коллекшне только будет один и тот же имей
простите если не правильно объяснил
Andrey
а как "выглядит" в глубинах глубин запрос к монге, в условно в "raw", и как приходят документы. Опять же, "железо" - прям одинаковое?
Andrey
опять же, 79 тысяч документов, должны прийти за сколько...за 1 секунду...какой-это размер
Andrey
и глупый может вопрос, а попробуйте "сохранить" тупо документы в файл, и в том цикле и в другом...
Rauan
а как "выглядит" в глубинах глубин запрос к монге, в условно в "raw", и как приходят документы. Опять же, "железо" - прям одинаковое?
{'date_time': {'$gte': datetime.datetime(2021, 9, 1, 0, 0), '$lte': datetime.datetime(2021, 11, 1, 0, 0)}}
железо одинаковое, я поднял оба сервисе на одном серваке
Rauan
Dmitry
{'date_time': {'$gte': datetime.datetime(2021, 9, 1, 0, 0), '$lte': datetime.datetime(2021, 11, 1, 0, 0)}}
железо одинаковое, я поднял оба сервисе на одном серваке
🙂 А если запросы поменять местами. Сначала монгу, потом постгрес.
Так не сравнить. Почему один запрос базу постгрес и много запросов в монгу? Нужно исходить из проблемы. Что нужно сделать в итоге?
Rauan
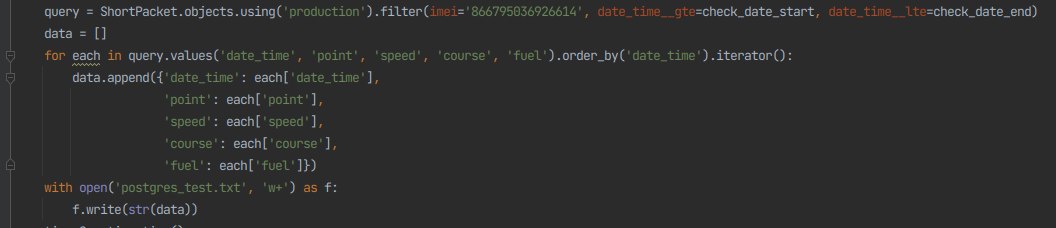
Сохранил все данные в файл через сериалайзр
POSTGRES: Num of points 79122 in 128.63806796073914 secs
MONGO: Num of points 79122 in 52.12108039855957 secs
Принтанул дату с каждого пакета
POSTGRES: Num of points 79122 in 7.45806796073782 secs
MONGO: Num of points 79122 in 12.69292402267456 secs
Andrey
POSTGRES: Num of points 79122 in 128.63806796073914 secs
MONGO: Num of points 79122 in 52.12108039855957 secs
Andrey
вот это что
Rauan
и глупый может вопрос, а попробуйте "сохранить" тупо документы в файл, и в том цикле и в другом...
думаю запись в файл был быстрым из за сериализации данных в питоне
потому что когда я беру каждые данные отдельно постгрес быстрее все равно
Andrey
монга за 1 минуту, а пострег за 2?
Andrey
думаю запись в файл был быстрым из за сериализации данных в питоне - это про что
Andrey
а, из постгреса - нет сериализации
Andrey
?
Andrey
вам по факту, монга отдала быстрее получается, так?
Rauan
проверяю теорию. когда я беру каждый аттрибут отдельно и принтую (print(obj.attr_1)) то с постргес это быстрее
Rauan
проверяю теорию. когда я беру каждый аттрибут отдельно и принтую (print(obj.attr_1)) то с постргес это быстрее
я напишу итог этого эксперимента) когда закончу
Andrey
Да не надо «принтовать». Сохраните свои 79 тысяч документов с нужными полями в память себе, в нужной вам структуре. И время на это измерьте.
Andrey
И там и там
Rauan
 Rauan
вам по факту, монга отдала быстрее получается, так?
тут монго была быстрой не из за того что быстро запросила, просто я создовал классы сериализации чтоб структурировать данные и кажется для постгрес этот класс сериализации был тяжелым
Rauan
Andrey
так как вы "выбираете из 1 коллекции", для окончательного "теста" - запустите-проверьте на "тупо" выгрузку из коллекцию с запросом, например через mongo-tools - mongoexport в csv c запросом, и посмотрите
Andrey
еще у меня подозрения на индексы, но тут нужен автор канала, он более компетентен
 Rauan
спасибо вам за комменты и подсказки😊
 Mansur
Всем привет, пытаюсь понять как указать несколько $eq в setPartialFilterExpression при создании индекса? Есть интовое поле и несколько значений, для которых я хочу индексировать, операторов gt/gte, lt/lte не достаточно
 yopp
yopp
Вы сравниваете на «холодную», после перезапуска и монги и pg? Совпадают ли условия в выборках? Сколько тестовых прогонов вы делаете? Одинаковые ли объёмы памяти выделены монге и пг, относительно размера данных?
yopp
На каких хостах и платформе вы делателе тесты? С какой версией? Отличается ли аппаратная и программная конфигурации тестовых машин?
yopp
Смотрели ли вы какие ещё планы предлагает планировщик?
Rauan
Вы сравниваете на «холодную», после перезапуска и монги и pg? Совпадают ли условия в выборках? Сколько тестовых прогонов вы делаете? Одинаковые ли объёмы памяти выделены монге и пг, относительно размера данных?
1) Вы сравниваете на «холодную», после перезапуска и монги и pg? если вы про то что бд может закэшировать запрос и из за этого дать не правильное время то не волнуйтесь, я учел этот фактор, он запрашивает без кэша напрямую с бд
2) Совпадают ли условия в выборках? Сколько тестовых прогонов вы делаете? на одинаковых условиях проверял на разные даты и вам показал один кейс, можете заметить что число документов и строк одинаковые. как итог монго всегда уступает
3) Одинаковые ли объёмы памяти выделены монге и пг, относительно размера данных? я два сервисе поднял с докером и с external volume, думаю с этим нет проблем
4) На каких хостах и платформе вы делателе тесты? С какой версией? Отличается ли аппаратная и программная конфигурации тестовых машин? все что тестилось было на одном серваке при равных условиях, на одной машине в одном контейнере докера
Надеюсь я правильно понял и ответил)
 Ivan
Никто на 4.4.10 не встречал зависание, что даже через mongo локально не подключиться к базе?
Rauan
1) Вы сравниваете на «холодную», после перезапуска и монги и pg? если вы про то что бд может закэшировать запрос и из за этого дать не правильное время то не волнуйтесь, я учел этот фактор, он запрашивает без кэша напрямую с бд
2) Совпадают ли условия в выборках? Сколько тестовых прогонов вы делаете? на одинаковых условиях проверял на разные даты и вам показал один кейс, можете заметить что число документов и строк одинаковые. как итог монго всегда уступает
3) Одинаковые ли объёмы памяти выделены монге и пг, относительно размера данных? я два сервисе поднял с докером и с external volume, думаю с этим нет проблем
4) На каких хостах и платформе вы делателе тесты? С какой версией? Отличается ли аппаратная и программная конфигурации тестовых машин? все что тестилось было на одном серваке при равных условиях, на одной машине в одном контейнере докера
Надеюсь я правильно понял и ответил)
По моей теории что индексация в PostgreSQL идентично с разделением на коллекции в монго (возможно даже быстрее)
 Anton
 Anton
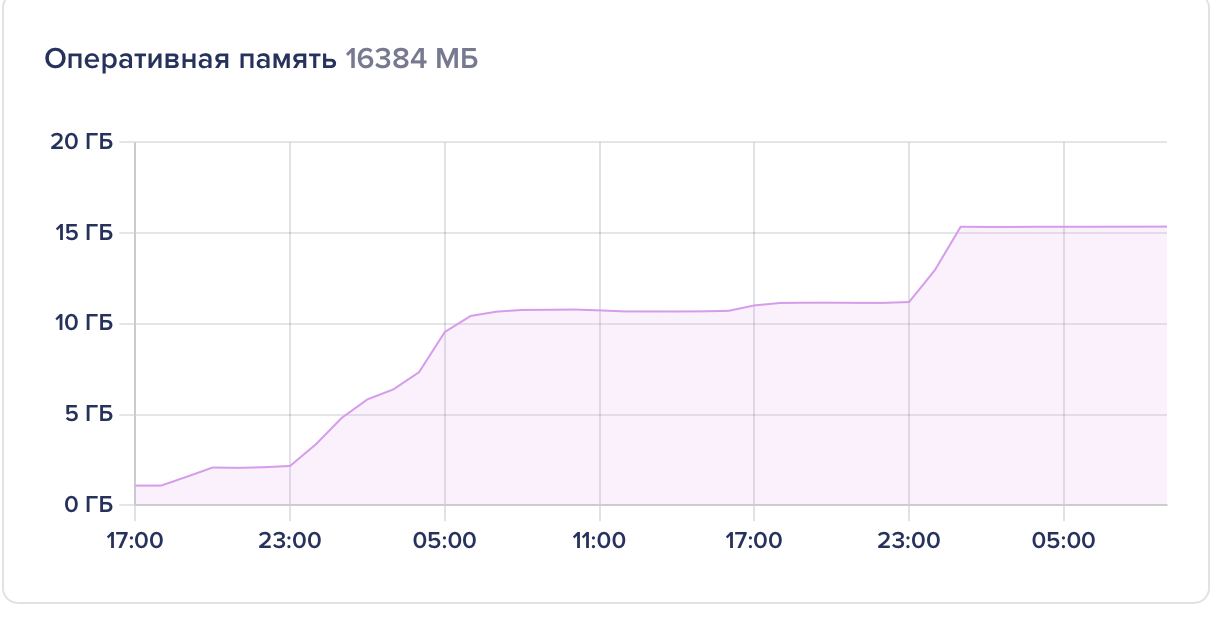
Не упадёт ли? Значит это что надо ещё оперативки добавлять?
У нас индексы не помещались в ОЗУ и тогда монга падала
yopp
1) Вы сравниваете на «холодную», после перезапуска и монги и pg? если вы про то что бд может закэшировать запрос и из за этого дать не правильное время то не волнуйтесь, я учел этот фактор, он запрашивает без кэша напрямую с бд
2) Совпадают ли условия в выборках? Сколько тестовых прогонов вы делаете? на одинаковых условиях проверял на разные даты и вам показал один кейс, можете заметить что число документов и строк одинаковые. как итог монго всегда уступает
3) Одинаковые ли объёмы памяти выделены монге и пг, относительно размера данных? я два сервисе поднял с докером и с external volume, думаю с этим нет проблем
4) На каких хостах и платформе вы делателе тесты? С какой версией? Отличается ли аппаратная и программная конфигурации тестовых машин? все что тестилось было на одном серваке при равных условиях, на одной машине в одном контейнере докера
Надеюсь я правильно понял и ответил)
1) у бд есть свой кеш, который в зависимости от базы данных может вести себя очень по разному. корректный способ сравнения: перезапустить базы и сделать существенное количество запросов, например 100 и через паузу ещё 100, записывая время ответа. В дальнейшем необходимо посчитать медианное время выполнение и исключить «внешний шум» расчитав stdev
2) требуется убедится что ваш драйвер/odm не добавляет никаких дополнительных условий в запрос.
3) если обе базы данных были запущены в момент тестирования, это неккоректный метод сравнения. базы данных по разному используют память и вы можете наблюдать конкуренцию за выделение памяти и задержки при сбросе файлового кеша на диск
4) внешие облачные хранилища, особенно если у них нет жестких гарантий iops генерируют шума больше чем реальных данных
yopp
и вы не ответили по поводу explain({executionStats: 1})
yopp
кстати, сравнивали ли вы время выполнения запросов не в python, а в стандартных терминалах субд?
Rauan
и вы не ответили по поводу explain({executionStats: 1})
{'executionSuccess': True, 'nReturned': 79122, 'executionTimeMillis': 86, 'totalKeysExamined': 79122, 'totalDocsExamined': 79122, 'executionStages': {'stage': 'FETCH', 'nReturned': 79122, 'executionTimeMillisEstimate': 10, 'works': 79123, 'advanced': 79122, 'needTime': 0, 'needYield': 0, 'saveState': 79, 'restoreState': 79, 'isEOF': 1, 'docsExamined': 79122, 'alreadyHasObj': 0, 'inputStage': {'stage': 'IXSCAN', 'nReturned': 79122, 'executionTimeMillisEstimate': 1, 'works': 79123, 'advanced': 79122, 'needTime': 0, 'needYield': 0, 'saveState': 79, 'restoreState': 79, 'isEOF': 1, 'keyPattern': {'date_time': 1}, 'indexName': 'date_time_1', 'isMultiKey': False, 'multiKeyPaths': {'date_time': []}, 'isUnique': False, 'isSparse': False, 'isPartial': False, 'indexVersion': 2, 'direction': 'forward', 'indexBounds': {'date_time': ['[new Date(1630454400000), new Date(1635811200000)]']}, 'keysExamined': 79122, 'seeks': 1, 'dupsTested': 0, 'dupsDropped': 0}}, 'allPlansExecution': []}
Rauan
yopp
'executionTimeMillis': 86
yopp
запрос занял 86мс
Rauan
он реально сделал этот запрос и взял все результаты? я думаю что он просто сохранил референс к запросу потому что lazy loading. нет?
yopp
он реально сделал этот запрос и взял все результаты? я думаю что он просто сохранил референс к запросу потому что lazy loading. нет?
К сожалению, я не понимаю что вы имеете ввиду.
executionStats показывает трудозатраты со стороны конкретно монги, а не драйвера. Т.е фактическое время выполнение вашего запроса самой базой данных — 86 мс.
Пологаю, что остальное время это затраты на десериализацию данных со стороны вашего драйвера/odm/приложения.
yopp
"nReturned": 79122, говорит о том, что курсор прочитал и вернул 79122 документов
Rauan
"nReturned": 79122, говорит о том, что курсор прочитал и вернул 79122 документов
хорошо спасибо большое) буду копать в эту сторону
 Igor
Всем привет. Кто то пользовался этой штукой? https://www.mongodb.com/developer/article/mongodb-5-0-schema-validation/
Как включить?
Mongo: 5.0.5
Driver: Node 4.2.2
Igor
Ответ: Включается с помощью команды на сервере db.adminCommand( { setFeatureCompatibilityVersion: "5.0" } )
 Google
Всем привет можете помочь
Вот рабочий фрагмент кода, в котором мы немного обрабатываем дату, чтобы обеспечить Mongo (здесь я использую модуль mongoose и хочу получить результаты для строк, атрибут даты которых меньше (до) даты, указанной как параметр myDate ) может корректно справиться с этим:
В базе есть даты я хочу вывести только который самый последний 30 дней
как сделать ?
MyModel.find({
'date': { $lte: inputDate }
})
 Nick
Всем привет можете помочь
Вот рабочий фрагмент кода, в котором мы немного обрабатываем дату, чтобы обеспечить Mongo (здесь я использую модуль mongoose и хочу получить результаты для строк, атрибут даты которых меньше (до) даты, указанной как параметр myDate ) может корректно справиться с этим:
В базе есть даты я хочу вывести только который самый последний 30 дней
как сделать ?
MyModel.find({
'date': { $lte: inputDate }
})
самый ранний док за последние 30 дней
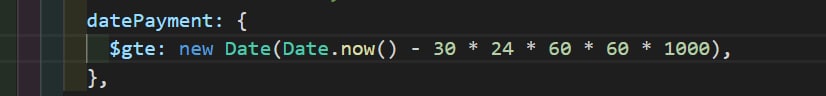
monthAgo = new Date() - 30 days (не знаю как как это делается в js)
и в запросе:
find("date":{ $gte: monthAgo})
после чего сортировку под дате и лимитом последний док
.sort(date: -1).limit(1)
Google
Google
Так не помогает
Nick
$gte
Google
 Google
Так правильно ?
Nick
еще раз, надо получить самый старый документ, который был не раньше (не старше) месяца назад?
Google
Nick
тогда да через $gte
Nick
и дальше сортировка + лимит
Google
Nick
да
Nick
как у вас там поле называется
Nick
datePayment
Google
22.11.2021
16:05:00
Google
datePayment
 Tony