Неверно осуществлялось заполнение полей в документе значениями, необходимо изменить как содержание документов, так и их структуру.
На что это влияет?
Новые документы добавляем "правильные" с полем версия. Со старыми без версии составляем список все полей - читаем документ, создаем массив всех полей. Меняем к правильной версии.
 Dmitry

 Andrey
На что это влияет?
Новые документы добавляем "правильные" с полем версия. Со старыми без версии составляем список все полей - читаем документ, создаем массив всех полей. Меняем к правильной версии.
1. версии составляем список все полей - неизвестно сколько полей, от этого избавиться и хочется
2. индекс построен по одному из полей, в который неверно писались данные, возникнет ситуация, что поиск по базе просто будет выводить или только старые записи или только новые
Andrey
например, ошибочно было принято решение - что у хоста mid.gov.ru - tld - ru, a домен mid.gov, тогда когда несколько правильней будет что tld gov.ru, а домен mid. В поле tld - старых записях ru, в новых gov.ru.
Andrey
можно писать по новому в "новую" коллекцию конечно. Но при определенных запросах, данных вычитываем в код, от "старой" коллекци - много будет, по новому записей - быстрее.
Dmitry
Andrey
Сначала обновить такие поля. И экспорт не нужет
таких полей(документов) около 9 billions, они проидексированы, сколько это будет "обновляться" с учетом индекса
Dmitry
Andrey
бысрее чем ручнйо экспорт.
Экспорт будет дней 5. Нагрузки на базу - просто чтение, сбой в чтении - так как чанками по 10млн - не критичен, можно с конкретно позиции продолжить. База остается рабочей и доступной для api. А налету update - опасно, мне кажется.
Andrey
вопрос в том, на сколько производительно и корректно работает skip записей из монги
Dmitry
Экспорт будет дней 5. Нагрузки на базу - просто чтение, сбой в чтении - так как чанками по 10млн - не критичен, можно с конкретно позиции продолжить. База остается рабочей и доступной для api. А налету update - опасно, мне кажется.
Не поинимаю в чем опасность. Разбить на этапы привдедение в норм вид. Так же на пять дней.
Andrey
Не поинимаю в чем опасность. Разбить на этапы привдедение в норм вид. Так же на пять дней.
я не понимаю, и не знаю, как контролировать процесс апдейта полей на таких объемах. Для каждой записи надо ее вычитать, изменить, проапдейтить, плюс будет скорее всего "перерасчет" индекса, значение поля ведь изменится
Dmitry
 yopp
я не понимаю, и не знаю, как контролировать процесс апдейта полей на таких объемах. Для каждой записи надо ее вычитать, изменить, проапдейтить, плюс будет скорее всего "перерасчет" индекса, значение поля ведь изменится
Контролировать невозможно, всё верно.
Как не крутите, у вас всё равно выйдет 1x чтения и 1x записи.
С точки зрения нагрузки абсолютно без разницы как вы будете это делать, работы плюс-минус эквивалентное количество.
Дешевле всего: lazy update. Но если у вас ошибки в данных, наверное вас это не подойдёт.
Второй вариант это: batched update. Проще всего это сделать по _id, если он остался как ObjectId. В этом случае вам не нужен дорогой skip. Вы выбираете первые N документов, записываете сам младший _id. Обновляете батч. Следующую выборку делаете по условию lt: <last_id>, limit: N. Повторяете пока не закончатся данные.
N подбирается экспериментально, так чтоб найти размер который не создаёт избыточной нагрузки и не разбивает кэш.
Ну и как предложили, тоже самое но в новую коллекцию. Без batched read это чревато тем-же разбиванием кэша, так как страницы с диска всё равно будут читателя сначала в кэш. А значит есть шанс что «горячий» набор данных будет вытеснен и производительность упадёт
yopp
спасибо, но _id - для экономии места, выбран составной и специфический.
Ох. Почти в 100% случаев использование документа в качестве _id крайне неэффективное решение
yopp
Во-первых, вы это уже не исправите без перезаписи данных в другую коллекцию
yopp
Во-вторых, это минное поле для запросов отличающихся от $eq. Причём даже с $eq можно получить множество проблем, так как неверный порядок ключей и запрос будет мимо индекса
yopp
А неверный порядок получить _очень_ легко. Ну и экономия практически нулевая
yopp
Основная причина: это не составной индекс. Вы индексируете значение в BSON
Andrey
Ох. Почти в 100% случаев использование документа в качестве _id крайне неэффективное решение
шел на это намеренно, с мыслями что, 12 байт от objectid - помноженный на условные 10 млрд, + всё равно по этому полю считается индекс...пусть будет составной - так решил, сейчас хочу "переложить" данные лучше...вот и размышляю, советуюсь
yopp
шел на это намеренно, с мыслями что, 12 байт от objectid - помноженный на условные 10 млрд, + всё равно по этому полю считается индекс...пусть будет составной - так решил, сейчас хочу "переложить" данные лучше...вот и размышляю, советуюсь
Как видите это решение вам уже создаёт проблемы. Если у вас документы не по 100 байт, то эти 12 байт капля в море
yopp
А если по 100, то вы скорее всего выбрали неэффективную схему
Viktar
шел на это намеренно, с мыслями что, 12 байт от objectid - помноженный на условные 10 млрд, + всё равно по этому полю считается индекс...пусть будет составной - так решил, сейчас хочу "переложить" данные лучше...вот и размышляю, советуюсь
Я вас понимаю. У меня была примерно такая же проблема. Но я оставил ид как есть. А использовал сокращение названия полей для сокращения использования места. Получилась нечитаемый документ без маппинга, но места сократили около 6%. На ид Макс что получалось сократить это около 1%, поэтому признали не эффективным.
Andrey
эта вся история с merge документов, то есть уникальные пары, значения из 2 полей, то такие записи - должны не меняться, а только добавляться значение в одно из полей...но в монго-тулс - вставка таких документов идет через go код:
updateDoc := bson.D{{"$set", document}}
result, err = inserter.Update(selector, updateDoc)
И поэтому например, поле 'days' - через mongoimport - Затиралось
а надо через код(Python)
update_doc = {'$addToSet': {'days': {'$each': events}},
'$set': record}
operation = UpdateOne({'_id': _id}, update_dict, upsert=True)
На том этапе - надо было грузить много данных, поленился поменяться код в mongo-tools....в итоге структура документов - по факту не известна
yopp
эта вся история с merge документов, то есть уникальные пары, значения из 2 полей, то такие записи - должны не меняться, а только добавляться значение в одно из полей...но в монго-тулс - вставка таких документов идет через go код:
updateDoc := bson.D{{"$set", document}}
result, err = inserter.Update(selector, updateDoc)
И поэтому например, поле 'days' - через mongoimport - Затиралось
а надо через код(Python)
update_doc = {'$addToSet': {'days': {'$each': events}},
'$set': record}
operation = UpdateOne({'_id': _id}, update_dict, upsert=True)
На том этапе - надо было грузить много данных, поленился поменяться код в mongo-tools....в итоге структура документов - по факту не известна
Да, динамически ключ это антипаттерн. Перейти на массивы хорошая идея, индексы будет строить проще и вероятно дешевле
yopp
Вот тут составные будут хорошо работает
Andrey
Да, динамически ключ это антипаттерн. Перейти на массивы хорошая идея, индексы будет строить проще и вероятно дешевле
да...вот по скорости вставки такой, не замерял еще, если с монгоимпорт - уже понятны объему и скорости...то с обновлением(вставкой) элементов в array - пока не ясно...надеюсь будет не медленее
Andrey
вне темы - конечно поражает, как монга хорошо сжимает данные...просто супер
yopp
Если вы хотите сделать обновление через mongoimport, то это не имеет смысла.
Самый просто вариант: читать из старой коллекции в новую. В принципе, так как _id уникальный индекс, то вероятно трюк с $gt прокатит и на вашем значении.
Andrey
yopp
самый быстрый вариант это или mongorestore, особенно если у вас шард или db.a.find/aggregate -> db.b.bulkInsert
yopp
Плюс агрегации с $merge: экономите на сети
yopp
Правда с вычислением смещения будет сложнее, но это решается разделением на два треда: один вычисляет смещения, второй делает миграции по смещениям
Maksym
Ребята привет. Простой вопрос, я думаю. Реально ли это как-то отформатировать, чтобы оно просто вернуло массив с объектами?
Maksym
const data = await Appointments.aggregate([
{
$match: {
patient: "WR1V5oe9dsWVExq5f0KvGP4eRhe2",
},
},
{
$facet: {
upcoming: [
{
$match: {
"event.start": { $gt: currentDate },
},
},
{
$sort: {
"event.start": 1,
},
},
],
passed: [
{
$match: {
$or: [
{ "event.end": { $lt: currentDate } },
{
"event.start": { $lt: currentDate },
"event.end": { $gt: currentDate },
},
],
},
},
{
$sort: {
"event.start": -1,
},
},
],
},
},
{
$project: {
result: {
$concatArrays: ["$upcoming", "$passed"],
},
},
},
]);
Maksym
А то оно сейчас возвращает массив с объектом, в котором ключ с массивом с объектами. Извините, если код не правильно кинул
 Артем
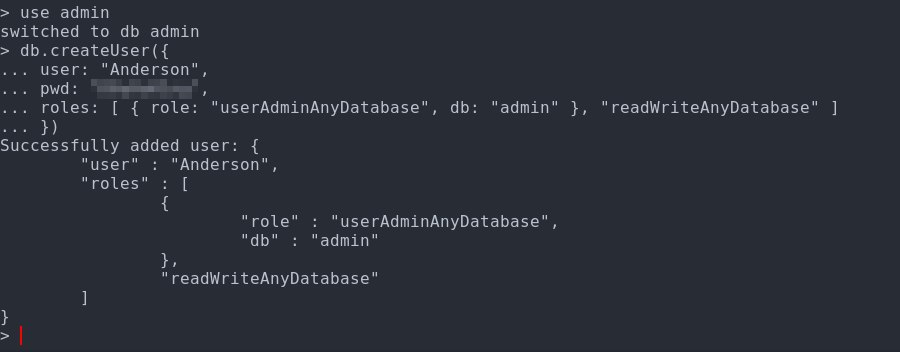
Сегодня зашел в монгу и увидел там базу READ__ME_TO_RECOVER_YOUR_DATA, в которой есть единственный документ, просящий выкуп за удаленные данные. Я в курсе, что это такое, но у меня есть два отличия от типичной ситуации, в которой такая штука появляется. Во первых, мои данные не были удалены, все полностью осталось на месте. Во вторых, база защищена аутентификацией через логин/пароль и войти в нее у меня лично без логина и пароля не получилось. Меня беспокоит, что кто то смог записать в базу документ, хоть и не удалил все данные. У кого то была похожая ситуация? Может есть какой то дефолтный пользователь, через которого можно зайти в базу и увидеть ее не всю, но иметь возможность записи? Есть идеи куда смотреть?
 Ilya
 Кракозябр
Доброго. Подскажите, используете ли какие балансировщики для монги? По типу ProxySQL
 Ilya
Сегодня зашел в монгу и увидел там базу READ__ME_TO_RECOVER_YOUR_DATA, в которой есть единственный документ, просящий выкуп за удаленные данные. Я в курсе, что это такое, но у меня есть два отличия от типичной ситуации, в которой такая штука появляется. Во первых, мои данные не были удалены, все полностью осталось на месте. Во вторых, база защищена аутентификацией через логин/пароль и войти в нее у меня лично без логина и пароля не получилось. Меня беспокоит, что кто то смог записать в базу документ, хоть и не удалил все данные. У кого то была похожая ситуация? Может есть какой то дефолтный пользователь, через которого можно зайти в базу и увидеть ее не всю, но иметь возможность записи? Есть идеи куда смотреть?
Если серьёзнее -- полные списки пользователей, аудит логинов и действий, нормальные ограничения на вход (в первую очередь -- разрёшэнные IP), анализ протоколов аутэнтификацыи на безопасность (под документацыи) вам придётся делать самому.
Ну и, самое время подумать о верификацыи данных. Регулярной. Например, хотя бы с бэкапами сравнивать исторические данные, вот это всё.
 ✨ Uni
я об этом узнал, когда тоже увидел READ_ME…
 BsLk
Привет, Я пишу на python. мне нужно ловить исключение при неверном подключении
BsLk
Библиотека mongoengine
Andrey
Привет, Я пишу на python. мне нужно ловить исключение при неверном подключении
Что значит неверное подключение?
Артем
Всем спасибо за советы, я пошел искать роль админа и у меня еe не оказалось, что удивительно). В общем в чем была проблема. Я для целей быстрой развертки запустил монгу в докере с официального образа со следующей конфигурацией
version: '3.1'
services:
mongo:
image: mongo
restart: always
environment:
MONGO_INITDB_ROOT_USERNAME: root
MONGO_INITDB_ROOT_PASSWORD: example
То есть изначально был создан standalone инстанс монги с включенной аутентификацией. Затем, когда мне понадобились changeStream, оказалось что они не работают в режиме standalone и нужно включать репликацию. Я сделал rs.initiate() и changeStream заработали и я благополучно забыл про все это (я оставил репликацию из одного инстанса). Оказалось, что при переходе в режим репликации моя аутентификация как будто бы перестала работать, поскольку для того чтобы она работала мне нужны keyFile, которых у меня конечно же не было после такого беспечного перехода из standalone режима. Поэтому в итоге база оказалась полностью открыта. Почему не дропнули данные для меня остается загадкой, видимо повезло
В общем, переход из standalone в репликацию с использованием образов докера нужно делать аккуратнее
 ꧁Anton
Всем привет)
Делаю запрос с аггрегацией. На одном из шагов в пайплайне "фильтрую" документы с помощью match <число> $in в большом [числа] (может быть как 1000 элементов, так и 10к).
Будет ли такой фильтр эффективно отрабатывать?
 Александр
 Александр
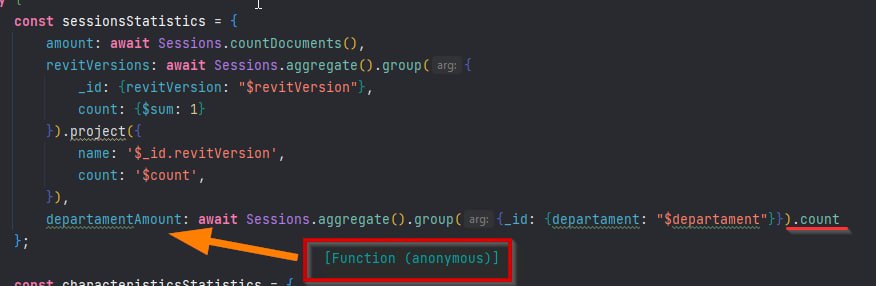
cityAmount: await (await CharacteristicsUsers.aggregate().group({_id: {city: "$city"},})).length
Это работает, но два await меня смущают. Хотел бы понять как правильно
Александр
 Александр
Вместо await exec и в нем проверяйте length
departamentAmount: Sessions.aggregate().group({_id: {departament: "$departament"}}).exec().length
undefined
Александр
Вместо await exec и в нем проверяйте length
Спасибо. Сделал так)
departamentAmount: (await Sessions.aggregate().group({_id: {departament: "$departament"}})).length
Kirill
departamentAmount: Sessions.aggregate().group({_id: {departament: "$departament"}}).exec(
function (err, result){
console.log(result.length)
})
Александр
Вместо await exec и в нем проверяйте length
Как правильно: через await и скобки или через exec?
Kirill
Как правильно: через await и скобки или через exec?
Я сам недавно в js, поэтому подсказал решение, которое в голову пришло, поэтому не знаю)
 $heriF
Всем привет, пытаюсь сделать кластер на монго дб атлас. Пишет, что нужно подождать 1-3 минуты, уже прошло больше 20 минут. Это нормально?
 Mr.
Привет всем!
Mr.
 Mr.
 Mr.
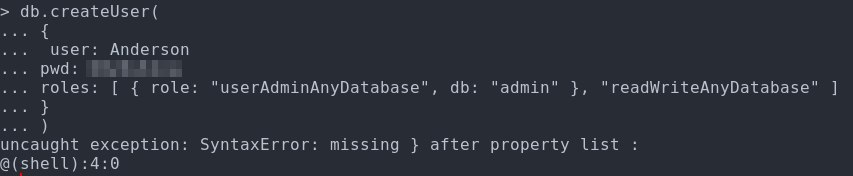
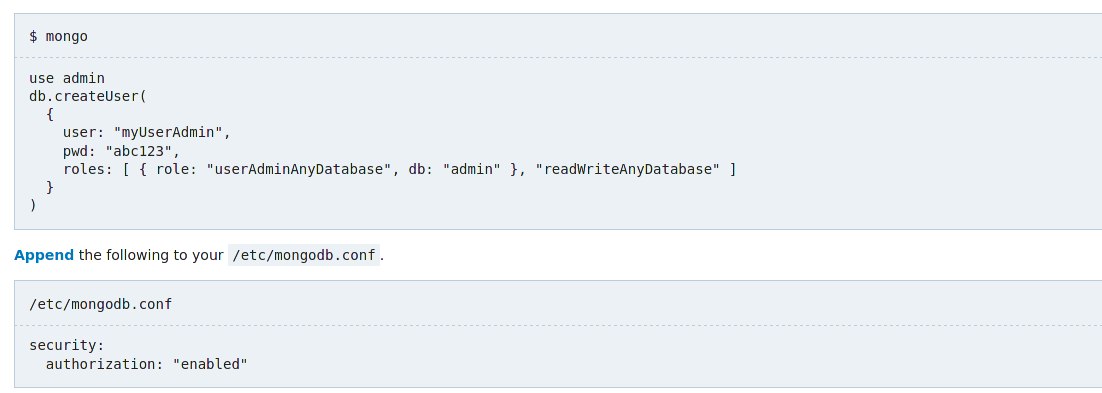
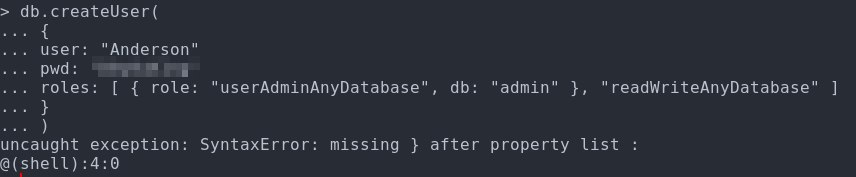
А всё... Я нашел ошибку
Mr.
А... Не, показалось
Mr.
 Pan
у меня есть документ юзера и каждый юзер содержит какойто адресс свой
может даже несколько
стоит ли мне адресса выносить в отдельную коллекцию? или держать их в документе юзера?
Pan
тут обычно думают так: если адресс часто используется в связке с данными юзера: то хранить вместе все
я правильно понимаю?
Вячеслав
Добрый день. У меня есть конфигурация устройств. Эта конфигурация сейчас в реаляционном виде. Сейчас я хочу ее перенести в документ. Т.е одна конфигурация = один документ. Но у меня получается что документ может превышать 16 мб. Вопрос, может есть какая-то статья (в интернете не нашел так сразу), где рассказывается как дробить документ? Может мне надо, чтобы у меня одна конфигурация должна быть равна одной коллекции? Можно ли работать с GridFs, на сколько это быстро? И может уже можно увеличить просто размер документа больше чем 16 мб?
Viktar
Добрый день. У меня есть конфигурация устройств. Эта конфигурация сейчас в реаляционном виде. Сейчас я хочу ее перенести в документ. Т.е одна конфигурация = один документ. Но у меня получается что документ может превышать 16 мб. Вопрос, может есть какая-то статья (в интернете не нашел так сразу), где рассказывается как дробить документ? Может мне надо, чтобы у меня одна конфигурация должна быть равна одной коллекции? Можно ли работать с GridFs, на сколько это быстро? И может уже можно увеличить просто размер документа больше чем 16 мб?
Документ больше 16 мб нельзя, все остальное зависит от вашей конфигурации. Было бы здорово если бы вы написали схему
Вячеслав
Документ больше 16 мб нельзя, все остальное зависит от вашей конфигурации. Было бы здорово если бы вы написали схему
У меня сейчас нет схемы. Я могу просто описать из чего она состоит вкратце. Т.е есть главное устройство, потом, канал опроса, задачи, методы опроса и счетчики. Можно ли разбить эти сущности на разные коллекции и связать по id. Я понимаю что думаю пока что в реляционном виде, по этому задаю такие вопросы
Viktar
Связать можно. Но это не так быстро как в реляционке, если большие объемы. Посмотрите aggregate lookup
https://docs.mongodb.com/manual/reference/operator/aggregation/lookup/
Вячеслав
Связать можно. Но это не так быстро как в реляционке, если большие объемы. Посмотрите aggregate lookup
https://docs.mongodb.com/manual/reference/operator/aggregation/lookup/
Ну т.е подход связывания физически можно реализовать, но как бы не желательно, потому что это аффектит производительность, т.е не лучший подход, верно ?
Viktar
Ну т.е подход связывания физически можно реализовать, но как бы не желательно, потому что это аффектит производительность, т.е не лучший подход, верно ?
Не совсем. Если вам надо достать один документ то это быстро, если 2млн то не очень. Плюс опять же все зависит от вашего документа. Мне сложно вам что то ответить конкретное, без изучения вашего домена
Вячеслав
Не совсем. Если вам надо достать один документ то это быстро, если 2млн то не очень. Плюс опять же все зависит от вашего документа. Мне сложно вам что то ответить конкретное, без изучения вашего домена
я прикрепил пример документа в сообщение выше. Получается сейчас описано для одного метода и для одной точки. А будет 4 метода * количество точек. Прекрасно понимаю, что мои терминологии для вас не дружелюбны. Если вы смотрите документ, то спрашивайте, я постораюсь объяснить понятнее
Viktar
Док не сильно мне понятен.
Dmitry
я прикрепил пример документа в сообщение выше. Получается сейчас описано для одного метода и для одной точки. А будет 4 метода * количество точек. Прекрасно понимаю, что мои терминологии для вас не дружелюбны. Если вы смотрите документ, то спрашивайте, я постораюсь объяснить понятнее
https://docs.mongodb.com/manual/core/data-modeling-introduction/
Начните отсюда.