 Viktar


примерно так будет выглядеть файд на питоне через паймонгу
 Danil
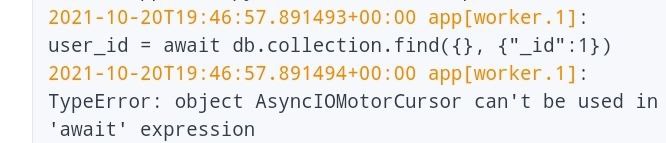 Danil
client[<db>][<collection>].find({},{'_id':1}
Это наверное тоже не сработает
Viktar
а конекшен к базе делаете?
Viktar
https://docs.mongodb.com/drivers/motor/
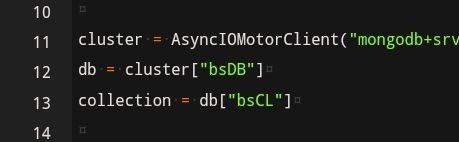 Viktar
collection.find({},{"_id":1})
Viktar
https://motor.readthedocs.io/en/stable/tutorial-asyncio.html
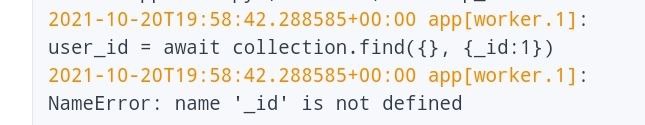 Viktar
_id в кавычках
Danil
Viktar
https://motor.readthedocs.io/en/stable/tutorial-asyncio.html#querying-for-more-than-one-document
 Google
Всем привет можете помочь \ MongoDB : Как удалить старые документы из коллекции, старше 1 месяц
 Kirill
Sergey
Всем привет! Подскажите, пожалуйста, как грамотно через пайплайн агрегации добраться до объекта, если он в другом объекте, который в свою очередь в массиве массивов ?
Пример:
"arrays": [
[{
"field1": "some info1",
"object1": {
"field2": "some info2",
"field2": "some info3"
}
}
...
]
...
]
Из object1 хочу вытащить поля на уровень выше, т.е. чтобы получилось
[[{
"field1": "some info1",
"field2": "some info2",
"field2": "some info3"
},...], ...]
Может кто знает с чем поработать нужно?
Пробую комбинации $addFields + $map + $mergeObjects, но пока у меня выходит массив из одного объекта(
Anonymous
Привет, столкнулся с ограничениями монги на размер сохраняемой строки(пытаюсь конвертнуть урл в base64),
RangeError [ERR_OUT_OF_RANGE]: The value of "offset" is out of range. It must be >= 0 && <= 17825792. Received 17825794
Anonymous
как это фиксится?
 Nick
как это фиксится?
разбиванием на чанки, либо выносом хранения в GridFS. В монге ограничение на один док в 16мб
Anonymous
 Eva🇺🇦
Привет! У меня есть алгоритм для сортировки постов:
k = constant
t = timestampposted - timestampcurrent
x = #votes
y = { 1 if x>0; 0 if x=0; }
z ={ x if x>0; 1 if x=0; }
f(t, y, z) = log10(z) + y*t/k
И я хочу получить 20 из 100 постов, отсортированные следуя его логике.
Подскажите, пожалуйста, как правильно это сделать.
Как я думаю:
1. db.posts.aggregate() //используя $function оператор, передаем нашу функцию сортировки и нужные филды документа для сортировки (вопрос: как передать филды) -> возвращаем [_id поста и его score для сортировки]
2. дальше сортируем все полученные значения по score и получаем упорядоченный массив _id
3. делаем запрос к бд, чтобы получить полные документы со всеми полями
Eva🇺🇦
ещё думается о $sort и sort(), но пока не пойму, как правильно score постов посчитать. алсо использую монгус))
Nick
Привет! У меня есть алгоритм для сортировки постов:
k = constant
t = timestampposted - timestampcurrent
x = #votes
y = { 1 if x>0; 0 if x=0; }
z ={ x if x>0; 1 if x=0; }
f(t, y, z) = log10(z) + y*t/k
И я хочу получить 20 из 100 постов, отсортированные следуя его логике.
Подскажите, пожалуйста, как правильно это сделать.
Как я думаю:
1. db.posts.aggregate() //используя $function оператор, передаем нашу функцию сортировки и нужные филды документа для сортировки (вопрос: как передать филды) -> возвращаем [_id поста и его score для сортировки]
2. дальше сортируем все полученные значения по score и получаем упорядоченный массив _id
3. делаем запрос к бд, чтобы получить полные документы со всеми полями
пока выглядит что можно все внутри агрегации сделать и получить для каждог опоста score, потом стедж сортировки по нему и потом скип-лимит для возврата 20 постов
Eva🇺🇦
а как внутри агрегации правильно сделать? aggregate принимает функцию и аргументы. я так понимаю, это своего рода цикл, в который передается текущий документ, потому функция будет каждый раз принимать новые параметры (t,x) и мы не можем сохранять их в агрегации.
Nick
а как внутри агрегации правильно сделать? aggregate принимает функцию и аргументы. я так понимаю, это своего рода цикл, в который передается текущий документ, потому функция будет каждый раз принимать новые параметры (t,x) и мы не можем сохранять их в агрегации.
все описанное надо переложить на агргеацию, внешние функцию в агргеации особо не передать
 yopp
а как внутри агрегации правильно сделать? aggregate принимает функцию и аргументы. я так понимаю, это своего рода цикл, в который передается текущий документ, потому функция будет каждый раз принимать новые параметры (t,x) и мы не можем сохранять их в агрегации.
y и z вы можете преагрегировать в сам пост
Eva🇺🇦
а как внутри агрегации правильно сделать? aggregate принимает функцию и аргументы. я так понимаю, это своего рода цикл, в который передается текущий документ, потому функция будет каждый раз принимать новые параметры (t,x) и мы не можем сохранять их в агрегации.
в этом и проблема - придется после агрегации find(отсортированный массив). то есть два обращения к бд.. а если там миллион постов..
yopp
как и x
yopp
как следствие вы можете заранее просчитать log10(z)
Eva🇺🇦
просто на создании поста считать филду?) и агрегация тогда не нужна) спасибо!
yopp
да
yopp
потом сортировать по этому полю
 Michail
Посдкажите можно ли удалить коммит через сам GIT HUB без консоли?
yopp
Посдкажите можно ли удалить коммит через сам GIT HUB без консоли?
нет, но помоему это можно сделать через десктопный клиент
Eva🇺🇦
потом сортировать по этому полю
блин, но есть проблема: у меня свежесть постов должна на лету считаться. получается, филд не заготовить
yopp
попробуйте найти способ как использовать сортировку по дате поста в этом случае
yopp
проблема с такими сложными запросами в том что они потребуют сканирования всех документов
yopp
по этому все веса лучше расчитывать в момент обновления документа и «ранжирование» делать путём сортировок
Eva🇺🇦
я думаю, в монгусе можно поле динамическое сделать. спасибо ещё раз
 Oleg
Всем привет, существует ли бесплатная GUI где есть role manager?
Anonymous
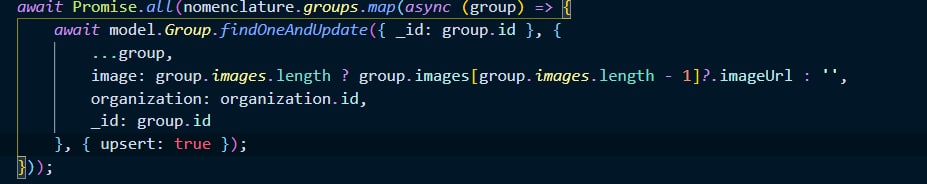
Как правильнее будет очищать бд от данных, которые не пришли в запросе?
Anonymous
 Anonymous
@yatoba
Anonymous
есть ли какой-то метод !findOneAndDelete
Anonymous
нет, удалить категорию которой ннет в массиве
Anonymous
массив nomenclature.groups
Anonymous
да
Anonymous
их не много
Anonymous
я пока удаляю все, и перезаписываю
madspectator
Я тут простеньку агрегацию вывода currentOp сделал и заметил одну штуку
$ run debug_ops
[27 / 0.43632] op=update, ns=tgscan.member, wait-lock=no, wait-flow=yes
[7 / 0.11367] op=update, ns=tgscan.user, wait-lock=no, wait-flow=yes
[4 / 0.06556] op=update, ns=tgscan.username, wait-lock=no, wait-flow=yes
[1 / 0.00036] op=command, ns=admin.$cmd.aggregate, wait-lock=no, wait-flow=no
Во время затупа, когда производительность updates/sec падает в десятки раз в currentOp висят операции со статусом waitingForFlowControl: true
madspectator
Это может быть причиной или индикацией причины? Я пока не прочитал ещё, что это такое.
madspectator
Суть проблемы, у меня в коллекции 1.3млрд. записей, делаю много update в секунду, несколько десятков тысяч, периодически оно начинает тупить и скорость update падает до сотен в секунду. Primary сервер мощный, а вот secondary (их несколько) слабее.
madspectator
$currentOp.waitingForFlowControl
A boolean that indicates if the operation had to wait becauseof flow control.
🤔
madspectator
https://docs.mongodb.com/manual/tutorial/troubleshoot-replica-sets/#flow-control
madspectator
Если я правильно понял, когда flow control включен, primary видит, что secondary не справляются и перестаёт принимать write запросы 😱
 Mykola 🤷🏼♀️
Привет! Кто работал с оператором $sample, подскажите почему он супер медленный и как с этим возможно бороться
madspectator
Если я правильно понял, когда flow control включен, primary видит, что secondary не справляются и перестаёт принимать write запросы 😱
В принципе, легко проверяется, я просто удалил все secondary из реплика сета. Сейчас смотрю, будут ли затупы у primary, работающего в соло-режиме.
Mikhail
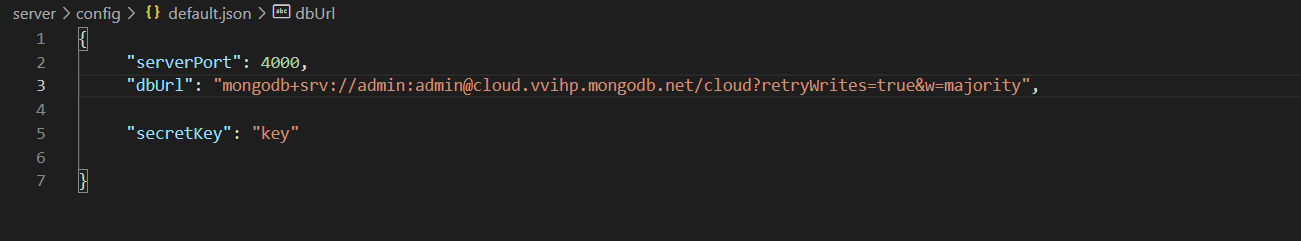
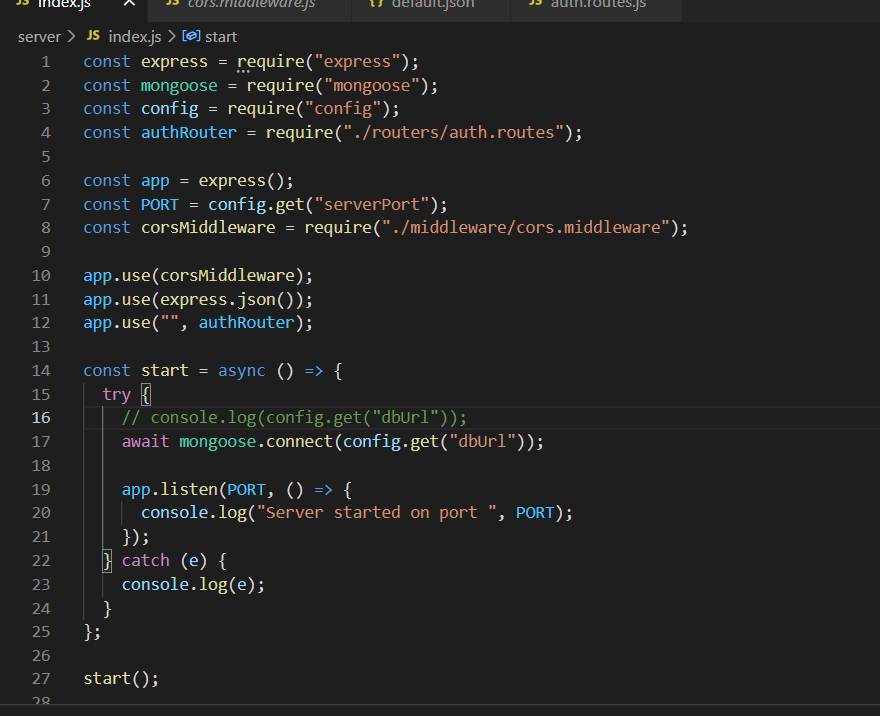
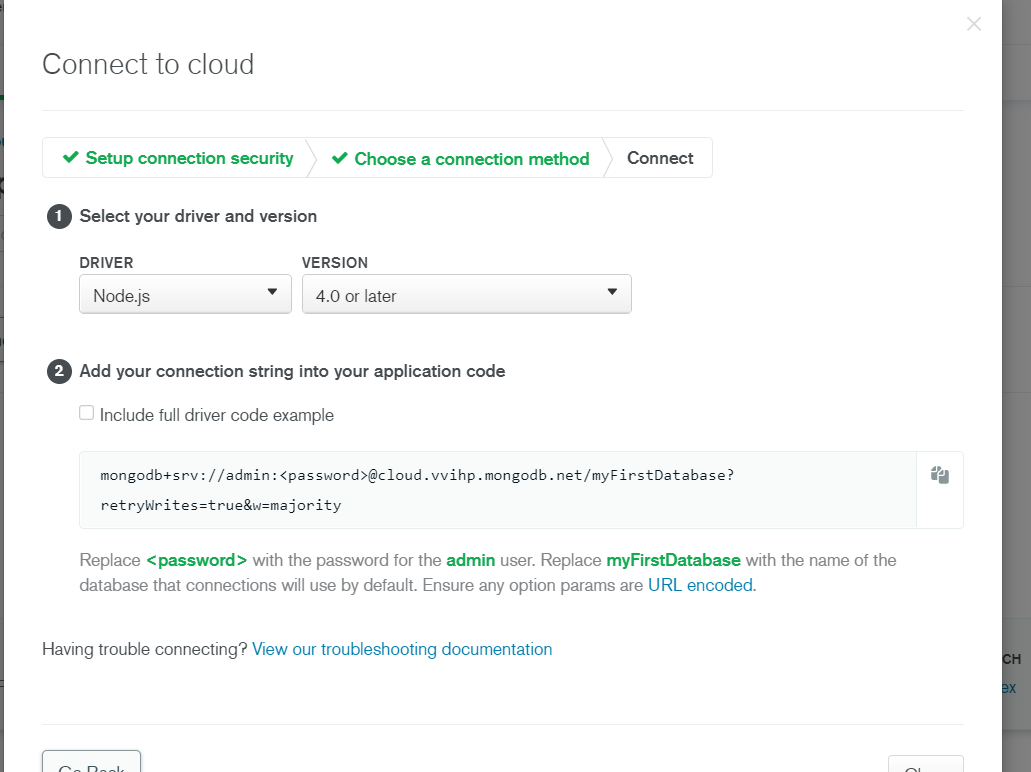
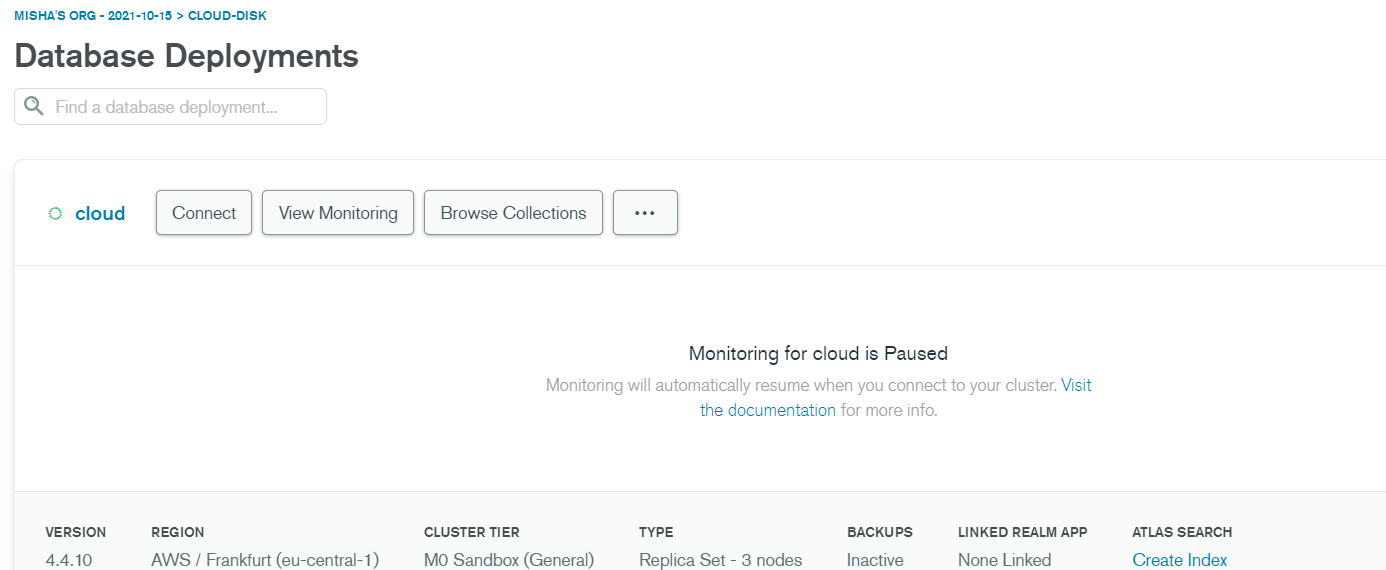
Всем привет можете подсказать почему при запуске сервера выдает ошибку ?
Mikhail
 Mikhail
 Mikhail
 Mikhail
 Mikhail
 yopp
Суть проблемы, у меня в коллекции 1.3млрд. записей, делаю много update в секунду, несколько десятков тысяч, периодически оно начинает тупить и скорость update падает до сотен в секунду. Primary сервер мощный, а вот secondary (их несколько) слабее.
Да, это flowControl. Вы можете или увеличить допустимый лаг или выключить его через настройки
https://docs.mongodb.com/manual/reference/parameters/#mongodb-parameter-param.enableFlowControl
Но корень проблемы в вашей топологии: вам необходимо уровнять ресурсы для всех нод.
Разное количество ресурсов для выбираемых нод очень опасная практика, так как отказ primary скорее всего приведёт к отказу всего кластера, так как выборный новый primary будет из числа нод с недостаточными ресурсами. Скорее всего эта нода так-же перестанет отвечать на heartbeats и в итоге кластер будет полностью недоступен
Anonymous
Всем привет можете подсказать почему при запуске сервера выдает ошибку ?
whitelist в настройках
Anonymous
сделай allow от всюду(ну или от своего айпи)
madspectator
Да, это flowControl. Вы можете или увеличить допустимый лаг или выключить его через настройки
https://docs.mongodb.com/manual/reference/parameters/#mongodb-parameter-param.enableFlowControl
Но корень проблемы в вашей топологии: вам необходимо уровнять ресурсы для всех нод.
Разное количество ресурсов для выбираемых нод очень опасная практика, так как отказ primary скорее всего приведёт к отказу всего кластера, так как выборный новый primary будет из числа нод с недостаточными ресурсами. Скорее всего эта нода так-же перестанет отвечать на heartbeats и в итоге кластер будет полностью недоступен
Если честно я реплику пока больше для этакого бэкапа использую, чтобы спокойнее было :) Но да, буду работать в направлении менее разношёрстного кластера.
Mikhail
Это где ?
Mikhail
whitelist в настройках
Mikhail
сделай allow от всюду(ну или от своего айпи)
yopp
Вы можете увеличить flowControlTargetLagSeconds например до 120 секунд
madspectator
Flow control не буду отключать, только хуже сделаю. Буду обновлять железо для secondary ноды.
madspectator
Вы можете увеличить flowControlTargetLagSeconds например до 120 секунд
Не поможет, я хочу постоянно писать эту нагрузку, secondary просто будет всё дальше и дальше в прошлое уходить.
yopp
Если вы не используете :majority то проблем быть не должно
yopp
Не поможет, я хочу постоянно писать эту нагрузку, secondary просто будет всё дальше и дальше в прошлое уходить.
В случае если это постоянно происходит, то да. Если у вас бывают всплески, которые приводят к таким последствиям, то увеличения допустимого лага поможет сгладить последствия
madspectator
Не, у меня парсер, он эту нагрузку создаёт постоянно, так что только upgrade secondary получается. Я ещё replWriterThreadCount увеличивал на secondary с 16 до 32 — не помогло. Хотя сейчас думаю, может быть, попробовать 64 или 128
yopp
Скорее всего у secondary нод не хватает пропускной способности хранилища