 Eugen


бо у меня основы SQL и не до конца еще понимаю связи в Mongo как реализуются. Бо в гугле я нашел то что я показал выше
 Josh
Не надо связей
 iwahid
Не надо связей
А как быть без связей? Ну т.е. тут же сразу проблема возникает - избыточность данных. Без связей же - вместо ссылок пихать полноценный объект с данными?
Josh
А как быть без связей? Ну т.е. тут же сразу проблема возникает - избыточность данных. Без связей же - вместо ссылок пихать полноценный объект с данными?
Да, избыточность в силу удобства и скорости
 Looch
зато бесконечный скейл
Looch
А как быть без связей? Ну т.е. тут же сразу проблема возникает - избыточность данных. Без связей же - вместо ссылок пихать полноценный объект с данными?
+ можно делать связи но это влечет за собой ограничений
Josh
Реф поля на соседние коллекции
Josh
Да, но не нужны они
Josh
7.8 лярда человеков на земле, небольшая избыточность, пара баксов в месяц за хард
Looch
ты по сути меняешь компактность на скорость
Looch
+ скейл
Eugen
можно ли привести пример для понимания
 Nick
Можно ли как-то задавать время жизни объекта динамически?
Ддя одного, допустим, 12 часов, для другого день, для третьего 30 минут?
Ттл индекс над полем со временем и обновлять это время в зависимости от того когда надо удалить
iwahid
 iwahid
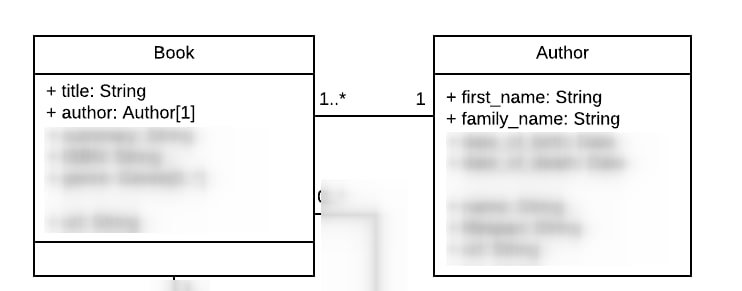
Не очень удачный пример, но какой был. Например, автор пишет тысячи книг в день (гиперболизирую, что показать проблему)
Josh
Josh
Введёшь ид на коллекцию с доп инфой по автору если очень надо будет кому доп подзапрос расширенный редкий
iwahid
А, типа имя оставить встроеным документом в книгу, и можно добавить дополнительный реф на актульную инфу по автору, ага?
Nick
iwahid
Ок, т.е. я правильно понимаю: в подавляющем количестве случаев (на реальной практике), нужно игнорить связи, пихать данные внутрь объекта, и пренебрегать возникающей избыточностью данных?
 Михаил
Nick
Ок, т.е. я правильно понимаю: в подавляющем количестве случаев (на реальной практике), нужно игнорить связи, пихать данные внутрь объекта, и пренебрегать возникающей избыточностью данных?
Вся тема с нормальными формами из скл далеко не всегда состоятельна в самом скл, так что вск зависит от задач. Если вам нужна супер консистентность и ее очень сложно добиться на ваших даннвх, то да придется все делать на связях и работать с транзакциями и в монге. Но если вы можете показать юзеру немного устаревшую информацию, то это открывает очень большой простор для решения задачи, достигая и удобство и производительность
iwahid
@yatoba @mreedread @letitcode Ок, пасиба большое :)
iwahid
можно ли привести пример для понимания
Может быть поможет тебе с твоим вопросом: https://developer.mozilla.org/ru/docs/Learn/Server-side/Express_Nodejs/mongoose
Там хороший пример со взаимными ссылками друг на друга
Найди на странице блок с текстом:
"Примечание: Внимательные читатели заметили, что автор добавлен к рассказу, но ничего не сделано, чтобы добавить рассказ к массиву рассказов stories автора. Как же тогда получить список всех рассказов конкретного автора? Один из возможных вариантов - добавить автора в массив рассказов, но при этом пришлось бы хранить данные об авторах и рассказах в двух местах и поддерживать их актуальность."
 Artem
Привет👋, начинаю учить nest + mongoDB, но не получается подключится к бд, всегда такая ошибка Nest can't resolve dependencies of the MongooseCoreModule (MongooseConnectionName, ?). Please make sure that the argument ModuleRef at index [1] is available in the MongooseCoreModule
context.
Не могу найти в гугле, и понять что не так тоже, буду бдагодарен за ответ.
 Joe
Привет👋, начинаю учить nest + mongoDB, но не получается подключится к бд, всегда такая ошибка Nest can't resolve dependencies of the MongooseCoreModule (MongooseConnectionName, ?). Please make sure that the argument ModuleRef at index [1] is available in the MongooseCoreModule
context.
Не могу найти в гугле, и понять что не так тоже, буду бдагодарен за ответ.
1. есть чат неста, это проблема не с конкретно монгой
2. это самая популярная ошибка по несту у новичков, так что врешь, что не нашел ничего, а из-за этого, ответа, увы не будет готового)
 Bob
(делаю на C#) Кстати, забыл отписаться, вдруг кому будет полезно, заполняя базу данных, парсю большие документы, теперь делаю вставку в MongoDB через InsertMany, при заполнении коллекции в 1млн записей беру их и вставляю в Mongo, ошибку по дубликатам игнорирую через IsOrdered=false, дубликаты также парсю из
catch(MongoBulkWriteException e)
{var exc= e.WriteErrors;}
Bob
Вставка ускорилась до 1 часа, ранее вставлял более суток 100 млн записей.
 Nikolay
Вставка ускорилась до 1 часа, ранее вставлял более суток 100 млн записей.
а сколько размер в мегабайтах или гигибайтах?
Bob
база после вставки весит 20гб, файл из которого парсил данные весит 17гб
Bob
сейчас решил опробовать еще и асинхронный метод на insertMany 50млн вставилось за 12 минут....
Bob
дождусь пока вставит 10млн чтоб сравнить
Bob
но правда проц почти под 100% загружен.
Bob
так как ограничения на потоки не ставил, потоки запускаются в цикле..
Joe
но правда проц почти под 100% загружен.
classic))
монга прям даже не по памяти а по процу бьет, я тоже недавно сравнивал асинхронку на ноде и следил за нагрузкой
Bob
ну в данный момент монго жрет 14гб оперативы и 74% проца
Bob
С Mongo начал работать всего 4 дня назад, так что новичок в этом деле, но меня поражает как ускорился процесс вставки с 2дней до часу..
Bob
посмотрим за сколько вставится асинхронным методом. почти вставило уже.
Bob
также тестировал поиск по базе на C#, результат поиска поразил, но когда ищешь один элемент и он является уникальным в базе, из 100млн возвращает за 3 секунды, если искомого элемента нету в базе, то конечно секунд 20-30 может пытаться найти.
Nikolay
можно попробовать поставить syncdelay в 0 на время загрузки, а потом вернуть
Bob
пока не знаю что это такое)
Bob
почитаю)
Bob
Итак, результат вставки 100млн документов в базу асинхронным методом(каждый в своем потоке) занял 27 минут... Это превосходно вообще))))
Nikolay
круто. это примерно 600 мегабайт в секунду.если смотреть, что вся база 20 гигабайт и время вставки 30 минут.
Bob
ну да, я приятно удивлен)))
Nikolay
а сколько нод ?
Joe
также тестировал поиск по базе на C#, результат поиска поразил, но когда ищешь один элемент и он является уникальным в базе, из 100млн возвращает за 3 секунды, если искомого элемента нету в базе, то конечно секунд 20-30 может пытаться найти.
индексацию построишь если, то будет быстрее намного.
совет: если будешь искать по нескольким поля через $or то лучше отдельно на каждое поле заводить, compund индекс медленнее будет (протестировано на базах в 200М и 1лярд)
Bob
а сколько нод ?
я скажу даже что с нодами еще не разбирался, индекс построен по полю name, в этом поле текстовое имя.
Joe
я скажу даже что с нодами еще не разбирался, индекс построен по полю name, в этом поле текстовое имя.
индекс какой? текстовый? тогда держи 2й совет: текстовый индекс в монге - слабенький, используй дефолтный по сортировке 1 или -1
в разы быстрее будет
Bob
индекс какой? текстовый? тогда держи 2й совет: текстовый индекс в монге - слабенький, используй дефолтный по сортировке 1 или -1
в разы быстрее будет
да да, я дефолтный и использовал, по сортировке 1, не стал текстовый делать
 Kamil
Насколько хорошо монга переживает параллельное удаление объектов?
Kamil
Если она в кластере, все удаления через праймари идут?
 Ilya
День добрый. Допустим, у меня есть коллекция документов, каждый из который содержит поля start (время начала действия), и end (время окончания действия). Фишка в том, что эти временные отрезки у разных документов пересекаться НЕ должны. То есть в коллекции не должно быть 2 документа, чье время действия "пересекается", "накладывается" друг на друга. Следовательно, этого нельзя допустить как при вставке нового документа, так и при обновлении временного промежутка у уже существующего.
Можно ли как то это сделать с помощью индексов? Я уже нашел одно решение, с помощью updateOne + upsert, но оно все-таки дает маленькую возможность коллизии (если операции попадут в тайминг выполнения идеально одновременно). Может быть, есть какие-нибудь составные индексы, или индексы по временным отрезкам, специально для этого случая?
Joe
День добрый. Допустим, у меня есть коллекция документов, каждый из который содержит поля start (время начала действия), и end (время окончания действия). Фишка в том, что эти временные отрезки у разных документов пересекаться НЕ должны. То есть в коллекции не должно быть 2 документа, чье время действия "пересекается", "накладывается" друг на друга. Следовательно, этого нельзя допустить как при вставке нового документа, так и при обновлении временного промежутка у уже существующего.
Можно ли как то это сделать с помощью индексов? Я уже нашел одно решение, с помощью updateOne + upsert, но оно все-таки дает маленькую возможность коллизии (если операции попадут в тайминг выполнения идеально одновременно). Может быть, есть какие-нибудь составные индексы, или индексы по временным отрезкам, специально для этого случая?
посмотри в 5 версию ноды, там что-то с таким типом коллекций (обособлены для работы с хронологическими данными) завезли, мб там и есть что-то для тебя
Joe
День добрый. Допустим, у меня есть коллекция документов, каждый из который содержит поля start (время начала действия), и end (время окончания действия). Фишка в том, что эти временные отрезки у разных документов пересекаться НЕ должны. То есть в коллекции не должно быть 2 документа, чье время действия "пересекается", "накладывается" друг на друга. Следовательно, этого нельзя допустить как при вставке нового документа, так и при обновлении временного промежутка у уже существующего.
Можно ли как то это сделать с помощью индексов? Я уже нашел одно решение, с помощью updateOne + upsert, но оно все-таки дает маленькую возможность коллизии (если операции попадут в тайминг выполнения идеально одновременно). Может быть, есть какие-нибудь составные индексы, или индексы по временным отрезкам, специально для этого случая?
а в 3-4 не встречал, только на уровне кода. касательно коллизий - тоже проблема с тем, что ты не можешь в 1ночку владеть доступом к базе(
 yopp
День добрый. Допустим, у меня есть коллекция документов, каждый из который содержит поля start (время начала действия), и end (время окончания действия). Фишка в том, что эти временные отрезки у разных документов пересекаться НЕ должны. То есть в коллекции не должно быть 2 документа, чье время действия "пересекается", "накладывается" друг на друга. Следовательно, этого нельзя допустить как при вставке нового документа, так и при обновлении временного промежутка у уже существующего.
Можно ли как то это сделать с помощью индексов? Я уже нашел одно решение, с помощью updateOne + upsert, но оно все-таки дает маленькую возможность коллизии (если операции попадут в тайминг выполнения идеально одновременно). Может быть, есть какие-нибудь составные индексы, или индексы по временным отрезкам, специально для этого случая?
Если у вас не очень большие интервалы и у них небольшая фиксированная гранулярность (несколько часов по 5 минут), то можно сделать массив состоящий из времени начала каждого сегмента интервала (01.01.20 13:40, 01.01.20 13:45 … 01.01.20 14:10) и по этому массиву сделать уникальный индекс
Если нет, то через транзакцию: кнутри транзакции проверяете что в необходимый интервал не покрыт другими документами и вставляете новый документ
Andrey
Итак, результат вставки 100млн документов в базу асинхронным методом(каждый в своем потоке) занял 27 минут... Это превосходно вообще))))
1. Это вставка в коллекцию без посчитанных индексов?
2. mongoimport из mongo-tools может и 100000 в секунду писать, это на не индексированной коллекции. В переводе на ваши 100млн, где минут 18, понятно, что вставляемые данные разные.
Andrey
@dd_bb Посоветуйте пожалуйста, почему merge коллекций, очень медленный, и судя по загрузки cpu идет в 1 процесс.
Равно как и импорт через mongoimport через merge в коллекцию тоже очень медленный, по cpu не загружен
 Eva🇺🇦
Если с бд соединиться вот так:
mongoose.connect('mongodb://localhost:27017/myapp');
то закрыть его можно так:
mongoose.disconnect();
А как в этом случае? Спасибо
const connection = mongoose.createConnection('mongodb://localhost:27017/myapp');
yopp
Если с бд соединиться вот так:
mongoose.connect('mongodb://localhost:27017/myapp');
то закрыть его можно так:
mongoose.disconnect();
А как в этом случае? Спасибо
const connection = mongoose.createConnection('mongodb://localhost:27017/myapp');
Вам скорее всего не нужно закрывать слежение
yopp
*соединение
yopp
Andrey
$merge в агрегациях?
да и в агрегации, и в импорте там в монгоимпорте есть вставка с опцией merge по полю
Andrey
и так и так пробывал
Eva🇺🇦
Вам скорее всего не нужно закрывать слежение
Действительно, не думал об этом) Но все равно интересно
Andrey
поле _id составное (), и по нему как по уникальному идет мерже
Andrey
удивляет, что сервер с базой не загружен сосвсем от этой операции....
Andrey
mongo 4.2.2
Ilya
Если у вас не очень большие интервалы и у них небольшая фиксированная гранулярность (несколько часов по 5 минут), то можно сделать массив состоящий из времени начала каждого сегмента интервала (01.01.20 13:40, 01.01.20 13:45 … 01.01.20 14:10) и по этому массиву сделать уникальный индекс
Если нет, то через транзакцию: кнутри транзакции проверяете что в необходимый интервал не покрыт другими документами и вставляете новый документ
А разве транзакция убережет меня от того, что может быть создано 2 документа с пересекающимися интервалами, в том случае, если создание этих документов выполнялось ИДЕАЛЬНО одновременно?
Ведь тут негде появиться write conflit-у. Точно также в параллельных транзациях я пройдусь по промежуткам уже существующих документов, проверю их, не обнаружу пересечений и сделаю запрос на создания дока с новым промежутком.
Ilya
Монга ведь оптимистические блокировки использует
yopp
А разве транзакция убережет меня от того, что может быть создано 2 документа с пересекающимися интервалами, в том случае, если создание этих документов выполнялось ИДЕАЛЬНО одновременно?
Ведь тут негде появиться write conflit-у. Точно также в параллельных транзациях я пройдусь по промежуткам уже существующих документов, проверю их, не обнаружу пересечений и сделаю запрос на создания дока с новым промежутком.
Snapshot isolation не даст создать два документа
yopp
*пересекающихся
Bob
1. Это вставка в коллекцию без посчитанных индексов?
2. mongoimport из mongo-tools может и 100000 в секунду писать, это на не индексированной коллекции. В переводе на ваши 100млн, где минут 18, понятно, что вставляемые данные разные.
Индекс создан уникальный до вставки в коллекцию, при вставке он автоподсчитывается. Ну импорт да, может тоже быстро все вставить, но для импорта придется парсить документ и записывать в другой документ в формате для импорта и займет лишнее пространство на жестком .. а потом уже из этого файла делать импорт, попробовал так 1 раз, неплохо конечно, но дубликаты я так не выловлю чтоб потом их обработать отдельно.
yopp
поле _id составное (), и по нему как по уникальному идет мерже
Т.е вы часть документов вставляете, а часть обновляете?
yopp
Да иначе дубликатов много
Уточню: если с таким _id уже существует документ, то вы его обновляете?