 ŠÅÏNƮ


 Anonymous
 Anonymous
И отправляешь данные
Anonymous
Только не сейви
 Andrew
Господа. такой вопрос
Могу ли я в агрегации сделать sort, limit, sort, чтобы в итоге это выполнялось именно в таком порядке? Sort в обоих случаях по одному и тому же полю, но в противоположных порядкх (сначала -1 потом 1). У меня в итоге первый сорт игнорится и видимо как то оптимизацией выкидывается
Andrew
Забыл уточнить. это .NET SDK (MongoDb.Driver), не голые MongoDB запросы
 victor
Товарищи, доброго дня. Подскажите, пожалуйста: как восстановить коллекцию, обычный bson из нешардированной БД в шардированную? Версия 4.0.22
 yopp
Товарищи, доброго дня. Подскажите, пожалуйста: как восстановить коллекцию, обычный bson из нешардированной БД в шардированную? Версия 4.0.22
mongorestore но только через mongos
victor
mongorestore но только через mongos
Да, спасибо. Вроде бы нашёл в офф доке. Осталось понять, как shard index выбрать, но это уже, наверное, к разрабам
 Egor
@dd_bb подскажите такую вещь. Восстанавливал бэкапы с версии 2.4 на 4.х . Вначале не смог, там ругался на всякое, порекомендовали удалить все JSON и запустить заново - помогло.
А удаление этих json не приведет ли к странным последствиям?
yopp
Вы про metadata.json?
yopp
Оттуда единственное важное — индексы
yopp
Я не помню какой формат в 2.4, в последних версиях там есть поле indexes. Можете их руками создать
Egor
Оттуда единственное важное — индексы
пока их не удалил - восстанвление не срабатывало. что-то типа неправильно что-то
yopp
Ну возможно, да
Egor
а. реплика в единственном экземпляре же не работает да?
yopp
Проверьте индексы, в остальном ничего страшного
yopp
Работает, если в репликасете настроена 1 нода
Egor
Работает, если в репликасете настроена 1 нода
хотя да.. туплю ... можно же пустые ноды в реплике поднять и в праймари восстановиться.
yopp
Без индексов в продакшене может быть очень больно
Egor
Без индексов в продакшене может быть очень больно
restoring indexes for collection comments.comments_likes from metadata
что-то про индексы пишет
Egor
это прям сейчас восстанавливаю
yopp
В тех файлах которые удалили
victor
Товарищи-господа, подскажите, будь ласка, ranged index для shard, не понимаю от чего зависит значение _id:1 , почему 1? А если мои разработчики, пользуются только теми элементами, у которых _id:>50000 и < 100000, можно ли как-то учесть это факт?
Viktar
Товарищи-господа, подскажите, будь ласка, ranged index для shard, не понимаю от чего зависит значение _id:1 , почему 1? А если мои разработчики, пользуются только теми элементами, у которых _id:>50000 и < 100000, можно ли как-то учесть это факт?
Не совсем понятен вопрос. Но подозреваю _id:1 в вашем кейсе обозначает, что индекс строится по полю _id
Dars
Как в базе данных организовать поиск слов по Levenshtein distance от введённого?
Viktar
Как в базе данных организовать поиск слов по Levenshtein distance от введённого?
Подозреваю никак. Пока мне не приходят идеи
Dars
Как в базе данных организовать поиск слов по Levenshtein distance от введённого?
То есть некая функция которая даёт числовую оценку дистанции между двумя словами. Есть введённое слово. Нужно вывести список слов из бд отсортированных по оценкам этой функции
victor
Не совсем понятен вопрос. Но подозреваю _id:1 в вашем кейсе обозначает, что индекс строится по полю _id
Верно, вопрос в том как именно выбирается число, почему 1, а не 5000, скажем, или 50000
Viktar
Верно, вопрос в том как именно выбирается число, почему 1, а не 5000, скажем, или 50000
Тогда читайте 1 как true)) 1 тут не число, а маркер
Viktar
Dars
Приведите пример вывода этой функции
f("клоп", "клип") = 1.02; f("клоп", "клён") = 2.07
yopp
Товарищи-господа, подскажите, будь ласка, ranged index для shard, не понимаю от чего зависит значение _id:1 , почему 1? А если мои разработчики, пользуются только теми элементами, у которых _id:>50000 и < 100000, можно ли как-то учесть это факт?
Это направление сортировки: +1 по возрастанию, -1 по убыванию
 jrm
@Module({
imports: [
forwardRef(() => AuthModule),
MongooseModule.forRoot(''
,{
useNewUrlParser: true,
useUnifiedTopology: true,
useCreateIndex: true,
}),
CategoriesModule,
ProductModule,
],
controllers: [],
providers: [],
})
export class AppModule {}
app.module
@Module({
imports: [
forwardRef(() => AppModule),
PassportModule,
JwtModule.register({
secret: jwtConstants.secret,
signOptions: { expiresIn: '60s' },
}),
MongooseModule.forFeature([{ name: 'Managers', schema: ManagersSchema }, { name: 'User', schema: UserSchema }])
],
providers: [
AuthManagersService,
AuthService,
LocalStrategy,
JwtStrategy],
controllers: [
AuthManagersController,
AuthController,
],
exports: [
AuthManagersService,
AuthService,
]
})
export class AuthModule {}
auth.module
помогите разобраться в импортах не как не могу разобрать эту ошибку
Nest can't resolve dependencies of the AuthService (UserModel, ?, JwtService). Please make sure that the argument Model at index [1] is available in the AuthModule context.
 Ilya
а откуда импортируется
Ilya
а вообще https://t.me/nest_ru
victor
Тогда читайте 1 как true)) 1 тут не число, а маркер
Может подскажете по chunk size, как выбрать, исходя из размера коллекции? Вот у меня 130гб и чанки по 64мега, кажется, как-то мало. И в документации как-то расплывчато - Large chunks lead to fewer migrations, а сколько по их мнению large, неясно, может это 100 мегов, а может 1024 🤷♂
yopp
Может подскажете по chunk size, как выбрать, исходя из размера коллекции? Вот у меня 130гб и чанки по 64мега, кажется, как-то мало. И в документации как-то расплывчато - Large chunks lead to fewer migrations, а сколько по их мнению large, неясно, может это 100 мегов, а может 1024 🤷♂
если у вас нет проблем, то размер чанка менять смысла нет
Sergey
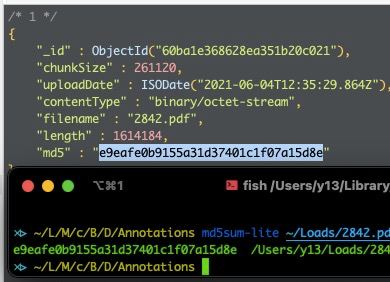
Всем привет. Прошу помощи - заливаю в gridfs файл. Не пойму как mongo считает md5 у себя, потому что он не совпадает с md5 снятым с файла на машине перед заливкой. Вопрос чисто валидации - хочу сверять md5 в mongo и снятый перед заливкой.
yopp
 Sergey
На файлах до 100 мб примерно совпадает. На больших файлах отличается чаще всего
Scorpi
На файлах до 100 мб примерно совпадает. На больших файлах отличается чаще всего
Чем сами считаете MD5? Проверьте сторонней утилитой
Sergey
Пробовал md5sum в консольке и hashlib в питоне. У них совпадает
Scorpi
Пробовал md5sum в консольке и hashlib в питоне. У них совпадает
Если файл обратно скачать из GridFS, MD5 будет такой же как в GridFS, или какой был до заливки?
Sergey
Как до заливки
Sergey
Какой драйвер используете для работы с монгой?
где можно глянуть? Это ж не про либу в python через которую я заливаю и скачиваю? (PyMongo и GridFs)
Scorpi
где можно глянуть? Это ж не про либу в python через которую я заливаю и скачиваю? (PyMongo и GridFs)
Больше был интересен используемый язык
Хм, не знаю тогда что ещё подсказать
Почитайте тут
https://stackoverflow.com/questions/29101248/what-causes-a-mongodb-gridfs-md5-hash-mismatch
Вроде похожая проблема
Sergey
Да, видел. Спасибо за помощь. Буду думать, в доках монги вообще про md5 написано депрекейтед и что он будет выпилен в следующих релизах, так что может лучше уже сейчас придумать другой способ валидации файлов. Вопрос встал остро после того, как я залил 215 файлов и один из них потом оказался битым и не читался после чтения из базы.
yopp
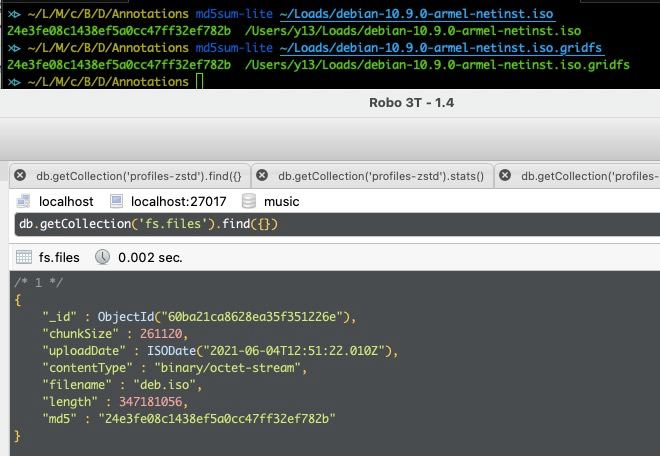 yopp
возможно действительно с writeconcern что-то
yopp
вы можете для битого файла выбрать все чанки с проекцией по полю n и посмотреть нет ли там пропущенных
Sergey
Да это понятно. У меня airflow льет туда и вот хотелось бы чтоб после заливки был алерт какой то, а то без ошибок отработало, а потом всплывает
yopp
если у вашего драйвера по-умолчанию установлен w: 0, то ошибок не будет
yopp
потому что w:0 это fire and forget
yopp
по этому чтоб исключить что у вас проблема на стороне монги, проверьте что у вас все чанки на месте
yopp
так как причин почему у вас файл потом не собрался может быть много
yopp
включая неверный порядок выборки
yopp
gridfs это не фича монги
yopp
это соглашение о хранении
yopp
как это соглашение реализовано — вопрос к драйверу
yopp
или к приложению, которое мимо драйвера реализует gridfs
yopp
например драйвер может не указывать явно что необходимо сортировать по n, а клиент который заливал файл, делал это в несколько потоков
yopp
как следствие natural order будет отличатся от порядка по n
yopp
если чанков не хватает, то вопрос к вашему драйверу, какой write concern он использует и как он обрабатывает ошибки
Sergey
Понял, буду ковырять. Спасибо за направление.
 fλüggåɘnk∂€čhiœßøλ∫ên
Всем привет)
у меня есть case class A(id: String, extra: Option[Map[String, Any]])
когда я пытаюсь прочитать из монги мне бросается эксепшн, что монга не может найти кодек для java.lang.Object
гугление особо ничего не дало)
куда можно копнуть, чтобы может кастомный кодек написать)
в extra есть еще вложенность типо той же map[String, Any]
 Tishka17
Подскажите плиз, а какой аналог будет в синтаксисе монги для такого sql-запроса? Мне нужно найти в коллекции записи по pref_name и затем выгрести все с совпадающими id_chembl
select * from chembl c1
join chmebl c2
on c2.id_chembl = c1.id_chembl
where c2.pref_name = ?
Sergey
Может кто скинуть ссылку на актуальный и 100% рабочий и проверенный ман по созданию двух репликасетов с арбитром? Помимо офф доки. Сдаётся мне что проблема с несовпадаюшим md5 и битыми файлами может быть связана с неверным конфигом.
yopp
Может кто скинуть ссылку на актуальный и 100% рабочий и проверенный ман по созданию двух репликасетов с арбитром? Помимо офф доки. Сдаётся мне что проблема с несовпадаюшим md5 и битыми файлами может быть связана с неверным конфигом.
https://docs.mongodb.com/manual/tutorial/deploy-replica-set/
https://docs.mongodb.com/manual/tutorial/add-replica-set-arbiter/
Sergey
https://docs.mongodb.com/manual/tutorial/deploy-replica-set/
https://docs.mongodb.com/manual/tutorial/add-replica-set-arbiter/
Да по этой вроде и делал + парень какой то на Ютубе )) Сейчас закачал файл csv в БД, все закачалось, скачиваю, хеш именно бинарника совпадает. Пытаюсь сохранить в csv обратно - неверный первый бит. И вот такое раз на 200 файлов)
yopp
а что в первом чанке?
Sergey
Не начало файла, а какой то кусок из середины