Привет всем. Кто-нибудь практиковал подключение к нескольким базам данных в mongoose? Можете ли вы поделиться своими лучшими практиками?
?
 Qahramon

 test
если в вашем дистрибутиве есть systemd, то надёжнее использовать таймеры
таймеры? это пакет внешний или внутрений, Debian 4.19.118-2 (2020-04-29) x86_64
 yopp
https://www.freedesktop.org/software/systemd/man/systemd.timer.html
 Ваня
У меня есть массив пользователей и есть отдельный объект пользователя, и мне нужно определить есть ли в этом массиве данный объект. Возможно ли такое сделать в mongoose?
 Rustam
Привет Как можно жоинит двух коллекции без условий?
Надо X позиции из коллеции A соеденить c Y позиции из B коллекции и получить X * Y позиции
Rustam
Rustam
Sergey
Братушки, хочу сделать бэкап и восстановление базы монгодб в докере. Вариант с бэкапом у меня работает прекрасно. docker exec mongodb2 sh -c 'mongodump --uri="mongodb://<username>:<password>@localhost:27017/<dbname>?authSource=admin&readPreference=primary" --archive' > db.dump ТО ВАРИАНТ С ВОССТАНОВЛЕНИЕМ - docker exec mongodb3 sh -c 'mongorestore -d <dbname> -u <user> -p <password>' < db.dump Возвращает мне error connecting to host: could not connect to server: connection() : auth error: sasl conversation error: unable to authenticate using mechanism "SCRAM-SHA-1": (AuthenticationFailed) Authentication failed Есть внятный вариант восстановления базы под логином и паролем?
 Oleg
короче когда цепляешься к базе, надо указывать в какой базе проходишь аутентификацию,
при бекапе ты проходишь в admin, а при восстановлении, там есть опция - надо её добавить и укзаать базу админ, иначе пытаешься аутентифицироваться в целевой базе
Oleg
Братушки, хочу сделать бэкап и восстановление базы монгодб в докере. Вариант с бэкапом у меня работает прекрасно. docker exec mongodb2 sh -c 'mongodump --uri="mongodb://<username>:<password>@localhost:27017/<dbname>?authSource=admin&readPreference=primary" --archive' > db.dump ТО ВАРИАНТ С ВОССТАНОВЛЕНИЕМ - docker exec mongodb3 sh -c 'mongorestore -d <dbname> -u <user> -p <password>' < db.dump Возвращает мне error connecting to host: could not connect to server: connection() : auth error: sasl conversation error: unable to authenticate using mechanism "SCRAM-SHA-1": (AuthenticationFailed) Authentication failed Есть внятный вариант восстановления базы под логином и паролем?
--authenticationDatabase=<database-name> database that holds the user's credentials
Oleg
и вот это: "SCRAM-SHA-1": (AuthenticationFailed) Authentication failed
если делал бекап и восстановление на разных серверах, тогда указывай нужный метот аутентификации
--authenticationMechanism=<mechanism> authentication mechanism to use
 jrm
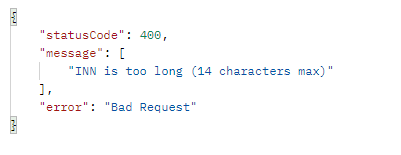
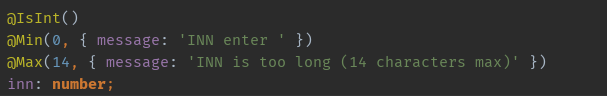
народ подскажите почему он выдает одну и тужи ошибку ?
jrm
 jrm
 jrm
вроде все верно сделал
Scorpi
jrm
Судя по типу number, Max тут ограничивает диапазон значений от 0 до 14, а не кол-во символов
а как иначе поступить ? в доку так и написано
Scorpi
у меня должны строго быть числа , проверку на инн
ИНН может начинаться с 0, как вы будете хранить число начинающееся с 0 с типом number?
Scorpi
у меня должны строго быть числа , проверку на инн
Храните как строку, валидируйте как 10/12 цифр
Sergey
authSource=admin
Да, вот такая команда адекватно отработала docker-compose exec -T mongodb sh -c 'mongorestore --archive --username=mongo --password=password --authenticationDatabase=admin' < /opt/db.dump
 Aleksandr
Братцы, а кто-то знает какой алгоритм репликации на первичной инициализации реплики происходит? У меня был standalone сервер, я инициализоровал реплика сет и добавил к нему еще 1 сервер. Данные начали наливаться. тут все понятно мастер -> slave. если я в rs добавлю еще 2 сервера, данные будут литься с мастера или начнут подтягиваться с первого слейва?
вопрос поставлен к чему - лучше дождаться пока первая реплика нальется и добавить еще 1 сервер в rs, дождаться налива 2 реплики и добавить 3й или можно сразу сейчас все 3 сервера новых в rs добавлять
собственно меня интересует нагрузка, будет ли первичному серверу больно от того что его сосут сразу 3-е
yopp
Братцы, а кто-то знает какой алгоритм репликации на первичной инициализации реплики происходит? У меня был standalone сервер, я инициализоровал реплика сет и добавил к нему еще 1 сервер. Данные начали наливаться. тут все понятно мастер -> slave. если я в rs добавлю еще 2 сервера, данные будут литься с мастера или начнут подтягиваться с первого слейва?
вопрос поставлен к чему - лучше дождаться пока первая реплика нальется и добавить еще 1 сервер в rs, дождаться налива 2 реплики и добавить 3й или можно сразу сейчас все 3 сервера новых в rs добавлять
собственно меня интересует нагрузка, будет ли первичному серверу больно от того что его сосут сразу 3-е
https://docs.mongodb.com/manual/reference/command/replSetSyncFrom/#sync-logic
yopp
Если коротко, то «It cannot be an arbiter, in startup or recovering mode, and must be able to answer data queries»
yopp
если вы хотите установить syncFrom, необходимо дождаться пока новая реплика завершит inital sync и догонит праймари
yopp
про то будет ли больно, сказать трудно. Это зависит от вашего сервера и объёма данных. Вы можете посмотреть насколько сейчас загружено io: диск, сеть и условно умножить на два
yopp
initial sync по своей сути это find({}) в каждую из коллекций во всех базах, и после завершения всех find(), применяется оплог
Aleksandr
initial sync по своей сути это find({}) в каждую из коллекций во всех базах, и после завершения всех find(), применяется оплог
большое спасибо за разъяснения!
Aleksandr
данных под терабайт
Null
4.4.6 (May 10) ◦ 4.2.14 (May 6) ◦ 4.0.24 (Apr 20)
⚠️ Версия 4.4.5 содержит критическую ошибку, которая может привести к отказу при рестарте ноды или временной недоступности части данных. Требуется обновление до 4.4.6
• Решение проблем с MongoDB по подписке
• Документация
• Официальные курсы (Бесплатно)
Stable: 4.4.6 (May 10) ◦ Bugfix: 4.2.14 (May 6)
Legacy: 4.0.24 (Apr 20, ☠️Jan ’22)
По вопросам размещения вакансий, платной поддержки и покупки лицензий пишите @dd_bb
☠️ 3.6.23 (Mar ’21), 3.4.24 (Jan ‘20), 3.2.22 (Dec ’18), 3.0.15 (May ’17)
 Alexey
Господа, всем привет.
Работаю с mongoose и Mongo, появилась проблема:
У меня в базе данных есть модель, у нее массив objectId с зависимыми элементами
Как сделать удаление из базы данных всех элементов с ObjectId в массиве
Заранее огромное спасибо
 Igor
Господа, всем привет.
Работаю с mongoose и Mongo, появилась проблема:
У меня в базе данных есть модель, у нее массив objectId с зависимыми элементами
Как сделать удаление из базы данных всех элементов с ObjectId в массиве
Заранее огромное спасибо
проблема то в чем? запрос не работает, или не знаешь как удалять документы?
Alexey
проблема то в чем? запрос не работает, или не знаешь как удалять документы?
Не знаю как правильно удалить связанные с моделью объекты, objectId которых находятся в массиве
Igor
Не знаю как правильно удалить связанные с моделью объекты, objectId которых находятся в массиве
ток вытащить сначала этот массив, а потом по этому массиву удалить все связанные элементы, а потом и сам документ с этим массивом. Тут нет такого механизма как в реляционках, когда по связе база сама удаляет
Alexey
ток вытащить сначала этот массив, а потом по этому массиву удалить все связанные элементы, а потом и сам документ с этим массивом. Тут нет такого механизма как в реляционках, когда по связе база сама удаляет
Спасибо огромное, удаляю перебором через for все элементы массива, обращаясь к БД. Обычно это будет 5-12 объектов за цикл, может иногда доходить до 30. Меня не будет база данных банить за такое количество единовременных запросов?
Igor
Спасибо огромное, удаляю перебором через for все элементы массива, обращаясь к БД. Обычно это будет 5-12 объектов за цикл, может иногда доходить до 30. Меня не будет база данных банить за такое количество единовременных запросов?
зачем ты их перебором удаляешь? собери в массив и удали через $in
вопрос про бан не понял, как тебя твоя же база забанит? что за механизм
Alexey
зачем ты их перебором удаляешь? собери в массив и удали через $in
вопрос про бан не понял, как тебя твоя же база забанит? что за механизм
Понял, благодарю, тогда второй вопрос отпал и первый тоже. Еще раз спасибо
Aleksandr
если вы хотите установить syncFrom, необходимо дождаться пока новая реплика завершит inital sync и догонит праймари
А вот еще глупый вопрос)) на старом standalone серваке было 700 гигов данных (по du). я добавил новый в rs, дождался окончания синхронизации и на новом du в каталоге показывает 200гигов. Это что за шаманство?)
Aleksandr
если вы хотите установить syncFrom, необходимо дождаться пока новая реплика завершит inital sync и догонит праймари
c syncfrom всё удалось, еще раз спасибо
yopp
А вот еще глупый вопрос)) на старом standalone серваке было 700 гигов данных (по du). я добавил новый в rs, дождался окончания синхронизации и на новом du в каталоге показывает 200гигов. Это что за шаманство?)
скорее всего смесь факторов: у вас когда-то было 700гб данных, но часть из них в процессе жизни удалилась плюс при синхронизации документы уложились по страницам более оптимально (меньше пустого места в страницах и выше уровень компресии)
Aleksandr
скорее всего смесь факторов: у вас когда-то было 700гб данных, но часть из них в процессе жизни удалилась плюс при синхронизации документы уложились по страницам более оптимально (меньше пустого места в страницах и выше уровень компресии)
на старом:
569G -rw------- 1 mongodb mongodb 569G May 27 16:45 collection-18--7719106623803831280.wt
на новом серваке:
128G -rw-------. 1 mongodb rkt-admin 128G May 27 19:45 collection-161-3562971621257710630.wt
yopp
du показывает только количество выделенного места
yopp
посмотрите в db.stats()
Aleksandr
т.е. по сути оно могло разростись занимая место на жёстком диске, а по факту внутри файла данных уже не было? т.е. они были почищены, например. А можете подсказать как в будущем такое избежать? чтобы оно "переуложилось"
yopp
смотреть насколько db.stats расходятся с du и когда значение привысит критическое, сделать по всем нодам по очереди initial sync
yopp
можно ещё https://docs.mongodb.com/manual/reference/command/compact/
попробовать
yopp
вы можете попробовать на том сервере где 596гб занято, но скорее всего до 128гб оно не уменьшится, если вообще уменьшится
yopp
вы можете попробовать на том сервере где 596гб занято, но скорее всего до 128гб оно не уменьшится, если вообще уменьшится
^ когда вы его из реплики выведете
Aleksandr
посмотрите в db.stats()
"dataSize" : 424.89,
"storageSize" : 589.18,
"indexes" : 32,
"indexSize" : 63.5749,
"totalSize" : 652.76,
yopp
Aleksandr
щас пощитаю, там в байтах отдаётся, переведу
Aleksandr
"dataSize" : 424.93,
"storageSize" : 145.34,
"indexes" : 32,
"indexSize" : 23.7691,
"totalSize" : 169.11,
Aleksandr
это он так получается компрессию применил
yopp
если у вас на 3.6 не была включена компрессия, то возможно это эффект от неё, да
Aleksandr
а на производительность компрессия как влияет?
Aleksandr
ну понятно что замедляет, в смысле на сколько и стоит ли?
yopp
почти всегда стоит
Aleksandr
И вообще компакт делать стоит периодически? и если да, как часто? каждую ночь, например, или раз в месяц
yopp
Данные сжимаются когда они выгружаются из кеша wt и разжимаются когда они загружаются в кеш wt. Так как под кеш wt отдаётся 50% доступной памяти, вся остальная свободная память будет использованна операционной системой под дисковый кеш и там данные будут уже сжатыми.
будет ли это негативно влиять на latency запросов? скорее всего нет. сходить в оперативную память это достаточно длительная операция, за которую процессор может успеть выполнить десятки или даже сотни операций, не говоря уже о времени доступа к диску, даже nmve.
Так как данные сжатые, то размер IO будет меньше, как следствие время доступа будет меньше, но так как оно всё равно не нулевое, то время которое процессор ждёт завершения IO, он может тратить на компрессию/декомпрессию
 Azamjon
Добрый день, есть приложение для 32 бита?
Azamjon
Добрый день, есть приложение для 32 бита?
Оказывается теперь для 32бита нет, последнее 2018 года выпуска
Azamjon
спасибо
 Guli
всем доброго дня ! кто-нибудь знаком с ArangoDB?
Guli
вопрос такой, я хотела найти всю информацию в двух коллекциях по одному имени
Guli
FOR x IN fruits FOR y IN citrus FILTER x.fruit_name && y.fruit_name == 'Apple' RETURN {x, y}
Guli
что-то типо такого)
Guli
если знаете, подскажите, пожалуйста)
 Nick
FOR x IN fruits FOR y IN citrus FILTER x.fruit_name && y.fruit_name == 'Apple' RETURN {x, y}
вам нужен аналог для монги?
 Pt. Loki
монго в контексте когда есть 1кк записей из них все с 3 полями (инт + 2 строки) и половина с доп полями по 2 строки. выгоднее ли при выборке по основным полям (те что 3)? и mariadb и mysql и монго дают спорные результаты при синтетических тестах)
Pt. Loki
ну строки условно 255