 Andrey


ааа, стикеры
 Alexander
тебе показалось
 Timofey
Хочу отметить что свагер фуфло и генераторы у него отстой. Проще самому генерилку поверх серванта написать
Не использовал, не знаю. Но контора завалидировала сваггер и не собирается валидировать хаскелль. Так что придётся пользоваться тем, что есть.
Timofey
Хочу отметить что свагер фуфло и генераторы у него отстой. Проще самому генерилку поверх серванта написать
Ну и линейка "проще-сложнее" у каждого своя
 𝙽𝚒𝚌𝚔
Хочу отметить что свагер фуфло и генераторы у него отстой. Проще самому генерилку поверх серванта написать
У меня сугубо положительный опыт с https://github.com/haskell-servant/servant-swagger
А если есть лишнее время, его можно занять куда как более полезными вещами, чем генерилки писать :-]
 Олек
А какая цель вообще писать ассемблерный код? Не, я понимаю, что хочется выжать из железа максимально, но чисто интуитивно кажется, что тогда уже проще сразу перепрыгнуть через этап в FPGA/ASIC-и.
Ну AMD производит gpu, а не fpga. А так как хочется продавать свои gpu в датацентры большими пачками и не по desktop ценам, нужна не только железка, а продукт, включая софт, библиотеки, поддержку и многое другое. Вот и получается, что кто-то должен эти библиотеки под железки писать, да чтобы производительность была сколько-нибудь конкурентноспособная. А это в сложившейся ситуации без использования ассемблера невозможно.
Олек
@Bulat_Ziganshin большое спасибо за пояснения, всё верно. Генерация OpenCL нам не подходит, ибо семантика языка итак далека от железа, компилятор совсем неуправляемый и делает что ему вздумается, а не то, что надо.
Олек
В некоторых местах очень важно строго выдерживать тайминги, потому скедул инструкций ведётся в полуручном варианте. Ну и плюс мы порой любим побаловаться всякими хаками, о которых не то что компилятор, а его разработчики иногда не знают. Не от хорошей жизни, конечно ))
 Bulat
один пример из того, с чем я сам сталкивался - CUDA включает несколько высокооптимизированных спецами нвидии бибилиотек, в частности Thrust, реализующей radix sort. Так вот, она работает на порядок быстрее, чем реализация в boost.compute и нескольких других универсальных библиотеках
Bulat
и если посмотреть скажем на CUB и ModernGPU, то видно насколько глубоко они влезают в микроархитектуру GPU. Если не ошибаююсь, я читал что нвидия тоже пишет код в подобных бибилиотеках в реальном ассемблере - несмотря на то, что у них микроархитектура заметно меняется с каждым вторым поколением gpu
Bulat
в целом, хорошо известно что на играх гефорсы работают быстрее при равном железе, и это приводит к тому что амд получает меньше маржу от продажи игровых гпу
Bulat
в области gpgpu nvidia захватила лидерство благодаря отличной экосистеме CUDA, включая высооптимизрованные бибилиотеки, и это то что AMD необходимо исправить, осбенно учитывая грядущий выход Intex Xe
 آزاد
ну и очевидный дип ленин, который без nvidia кажется не обходится
Олек
У nvidia часть библиотек на PTX, который более-менее стабилен, но самые ответственные места на реальном асме. И да, микроархитектура у них меняется часто. Вот тут есть некоторые детали их современной ISA https://arxiv.org/abs/1804.06826
Олек
Ага, экосистема слабое место, ну и другие проблемы тоже имеются.
 Danila Matveev
в области gpgpu nvidia захватила лидерство благодаря отличной экосистеме CUDA, включая высооптимизрованные бибилиотеки, и это то что AMD необходимо исправить, осбенно учитывая грядущий выход Intex Xe
основная причина даже не скорость, cuda единственное чем можно пользоваться, не испытывая тяги к суициду
 Алексей
А вспоминал галид больше как источник идей, т.к. говорим хаскелль — подразумеваем DSL & кодогенрацию
Олек
 Cheese
А вспоминал галид больше как источник идей, т.к. говорим хаскелль — подразумеваем DSL & кодогенрацию
нельзя забывать про clash — интересное исключение
Олек
Хотя знакомый глубоко копается в CUDA и постоянно аргументированно кроет трехэтажным матом NV. Но для работы с amd надо быть более психически стойким, это факт.
Bulat
У nvidia часть библиотек на PTX, который более-менее стабилен, но самые ответственные места на реальном асме. И да, микроархитектура у них меняется часто. Вот тут есть некоторые детали их современной ISA https://arxiv.org/abs/1804.06826
а по микроархитектуре amd и встройки intel что-то подобное есть? ну к примеру я абсолютно не представляю какие там тайминги чтения из кеша/sharedmemю да и просто intruction latency/throughput, за исключением того что fmad на amd выполняется back-to-back
Олек
На мой взгляд, лучший наглядный обзор gcn это GS-4106: “A Crash Course: The AMD GCN Architecture” (на slideshare сейчас не доступен, но тут можно скачать http://laylamah.com/wp/?page_id=134). Есть какие-то цифры по кэшам, но без таймингов.
 Андрей
ну и очевидный дип ленин, который без nvidia кажется не обходится
> "дип ленин" вызвал ассоциации про захоронение вождя )))
Олек
У большинства 32-битных v_* инструкций issue занимает 1 такт. В CU живут 4 simd и каждый такт один из них активен на issue в round robin режиме. То есть throughput - 1 v_* каждый такт, а каждый simd получает раз в 4 такта. Инструкции разных типов можно запихнуть за один такт, например скалярный s_add + векторный v_mul + чтение из памяти.
Bulat
У большинства 32-битных v_* инструкций issue занимает 1 такт. В CU живут 4 simd и каждый такт один из них активен на issue в round robin режиме. То есть throughput - 1 v_* каждый такт, а каждый simd получает раз в 4 такта. Инструкции разных типов можно запихнуть за один такт, например скалярный s_add + векторный v_mul + чтение из памяти.
эту информацию как раз можно почерпнуть из слайдов 11-го года
Олек
Тайминги у кешей по очевидным причинам не предсказуемы, но с ними проблем не особо много, если по пропускной способности всё что надо пролезает.
Bulat
почему не предсказуемы? у cpu они хорошо иззветсны, для nviidia измерения тоже есть
Bulat
потом - все ли операции выполняются за 4 такта как fmad? есть ли ALU инструкции с уменьшенным throughput, как у nvidia?
Bulat
>Инструкции разных типов можно запихнуть за один такт
но только из разных simd, верно? из одного потока, как это было у maxwell, две инструкции за такт не выполнишь?
Олек
Ну в плане, что в случае cache-hit и только одного запроса ответ будет через цать тактов, цифры есть (можно и самому померить, но в открытых источниках не видел, может потому что и не искал), но оно на реальных задачах не самое важное, я даже и не помню конкретику. Shared доступ там определённости побольше, и порядок около пары десятков.
Bulat
у меня нет amd gpu чтобы мерять :) пара десятков, если речь идёт именно о маленьких тактах - лучше чем было на maxwell
Олек
>Инструкции разных типов можно запихнуть за один такт
но только из разных simd, верно? из одного потока, как это было у maxwell, две инструкции за такт не выполнишь?
Вернее сказать из разных потоков. Из одного потока только одна инструкция за такт. Потоки прибиты к своим simd.
Bulat
а, ну да, именно из разных потоков одного, текущего simd
Bulat
это как раз та информация, кторую можно извлечь из слайдов AMD, если хорошенько над ними помедитировать. надеюсь, в акутальной презентаци это говорили более прямо
Олек
потом - все ли операции выполняются за 4 такта как fmad? есть ли ALU инструкции с уменьшенным throughput, как у nvidia?
Есть и такие. Но они более-менее ожидаемы, полный целочисленный mul, sqrt, sin и всё в таком духе
Олек
Что-то мы уже немного оффтопим на канале haskell )), не стоит ли переместить обсуждение в личку?
Олек
Или тут ок?
Bulat
в целом, gcn с его 256КБ регистров+64 КБ кеша на 64 алу выглядел вполне прилично по сравнению с maxwell (128 КБ+96 КБ на 128 АЛУ), учитывая что у amd есть ещё скалярные регистры, back-to-back выролнение команд, хотя и вдвое шире wavefront
Max
Что-то мы уже немного оффтопим на канале haskell )), не стоит ли переместить обсуждение в личку?
Лучше отдельный чатик запилить, я бы с удовольствием послушал бы.
 Λrtem
Anonymous
David Hall будет жить. Поприветствуем!
 Vladimir
 Kirill
?
Kirill
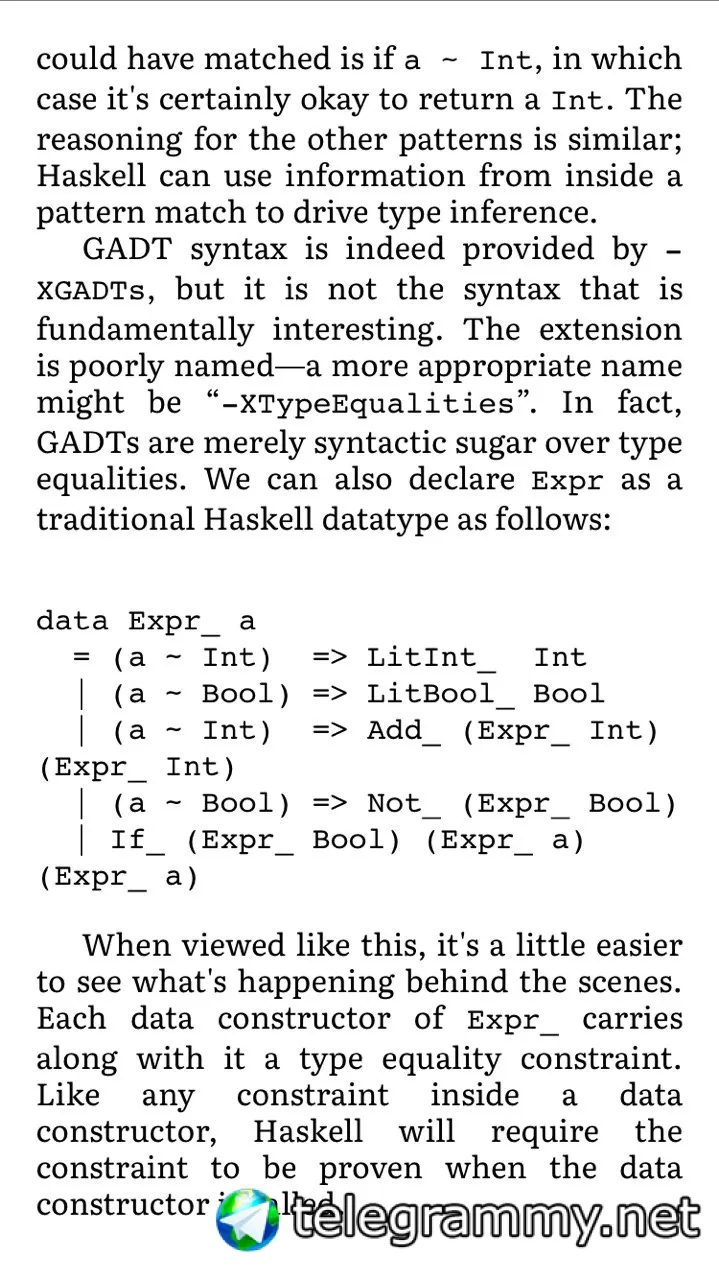
Могу рассказать пример из нашего проекта с работы. Мы использовали GADTs, чтобы хранить суммы типов в SQL таблицах. Есть набор полей общий для каждого объекта — время создания, id, источник создания, etc. А специфичные для каждого конструктора данные хранятся как текстовый объект в формате JSON в SQL в таблице в поле с названием data. И вот надо уметь парсить этот JSON в зависимости от того, какой там был источник создания. Более того, часто хочется выбрать данные только одного источника, и чтобы при этом декодер сам догадался, как именно парсить JSON. Код закрытый, скинуть не могу( Но тип данных выглядит примерно так:
data Source = Source1 | Source2 | Source3
data Reading (s :: Source) where
Reading1 :: ReadingData1 -> Reading Source1
Reading2 :: ReadingData2 -> Reading Source2
Reading3 :: ReadingData3 -> Reading Source3
Cheese
Vladimir
Ок, спасибо!
Anonymous
Alejandro Sanchez будет жить. Поприветствуем!
Vasilii
Я к вам с таким вопросом. Вот есть у меня файлики с csv, которые я паршу с помощь. cassava. И всё вроде хорошо - подключил DeriveGeneric и радуюсь тому как всё удобно.
Но вот незадача, часть данных в файликах имеют лишние пробелы которые я хочу убрать. Для Text, ToField и FromField уже определены самой cassava и как я понимаю вклиниться не удастся. Ок, сделал свой тип SText и написал для него конвертацию туда сюда. Но все места где используются геттеры рекордов ожидают там Text а не мой SText.
Как бы мне избежать явной конвертации? ЧТо-то аля как это делает OverloadedStrings ?
 A64m
неявной конвертации в хаскеле нет. перегруженные литералы ничего не конвертируют, они полиморфные просто
Vasilii
ок, что посоветуешь?)
Vasilii
derieve Generic убирать совсем не хочется =( пока не пойму где вклиниться
A64m
явно конвертировать рекорд в котором текстовые поля обернуты в рекорд, в которых текстовые поля не обернуты
Anonymous
@LuckyCatDev будет жить. Поприветствуем!
Алексей
Ну или безумная магия на типах
Vasilii
хм.. грустненько.
Алексей
Постпроцессинг ещё
Vasilii
а можно по-подробнее?
Vasilii
под постпроцессингом я так понимаю - аналог того что @A64m_qb0 предлагает
A64m
зависит от того что там за процессинг нужен
Vasilii
ну мне нужно просто strip вызвать на всех Text полях
A64m
может можно значения в некоторых полях подправить без заведения второго типа
A64m
ну, вызовите стрип на всех текстовых полях тогда
Vasilii
На крайний случай я везде всё и руками подправлю конечно, но думал может есть элегантное решение какое и я просто что-то упускаю
A64m
ну можно дженериками буквально сделать что вы сказали, применить функцию ко всем полям определенного типа
Vasilii
о! а куда копнуть/посмотреть? может пример есть какой?
A64m
дженериками из lens например или generic-lens
Vasilii
ок, посмотрю туда, спасибо!
Anonymous
Dmitri Young будет жить. Поприветствуем!
A64m
ок, посмотрю туда, спасибо!
вот простой пример
> :set -XDeriveDataTypeable
> import Data.Data
> data Foo = Foo { foo, bar :: Text, baz :: Int } deriving (Show, Data)
> import Data.Data.Lens
> (Foo " foo " "bar " 42) & template %~ T.strip
Foo {foo = "foo", bar = "bar", baz = 42}
Vasilii
выглядит как то, что мне нужно 🙂 спасибо )
Maxim
а как работает template?
A64m
траверсал по всем полям какого-то типа. тип тут определился из типа параметра T.strip
Maxim
удивительная магия
A64m
где тут магия-то?
 Denys
траверсал по всем полям какого-то типа. тип тут определился из типа параметра T.strip
Это без рефлексии и прочего заглядывания в метаданные делается?
A64m
с рефлексией, конечно. рантаймовой в случае с моим примером из lens и компайл таймовой в generic-lens
Andrey
deriving (Show, Data)