— regex-tdfa
λ> mrSubList ("<between>" =~ "<(.*)>" :: MatchResult String)
["between"]
*Main Regex.Parser Text.Regex.TDFA> mrSubList ("<kek> <kek>s <kek>a" =~ "<(.*)>" :: MatchResult String)
["kek> <kek>s <kek"]
 Ryner Reinhardt

 Ryner Reinhardt
Вот в этом и дело
 Cheese
регулярки — это отдельная тема
 Andrei
"now you have two problems"©
Cheese
ты хотел, чтобы хаскельная библиотека научила тебя подводным камням мира регулярных выражений?
Ryner Reinhardt
[^>]*
Main Regex.Parser Text.Regex.TDFA> mrSubList ("<kek> <kek>s <kek>a" =~ "<(.*)^>" :: MatchResult String)
[]
Ryner Reinhardt
?????
Ryner Reinhardt
ты хотел, чтобы хаскельная библиотека научила тебя подводным камням мира регулярных выражений?
В тернетах куча примеров этого
Ryner Reinhardt
Но они не работают
Cheese
я бы уточнил — у тебя не работают
Cheese
наверно, как-то неправильно используешь
Cheese
Cheese
ты не понял, что такое «[^>]*» и куда его вставить?
andor0
^ не лишняя?
Ryner Reinhardt
> [^>]*
Что ты имел ввиду тут не понял
 Vladislav
[^>]* значит последовательность любых символов кроме >
Ryner Reinhardt
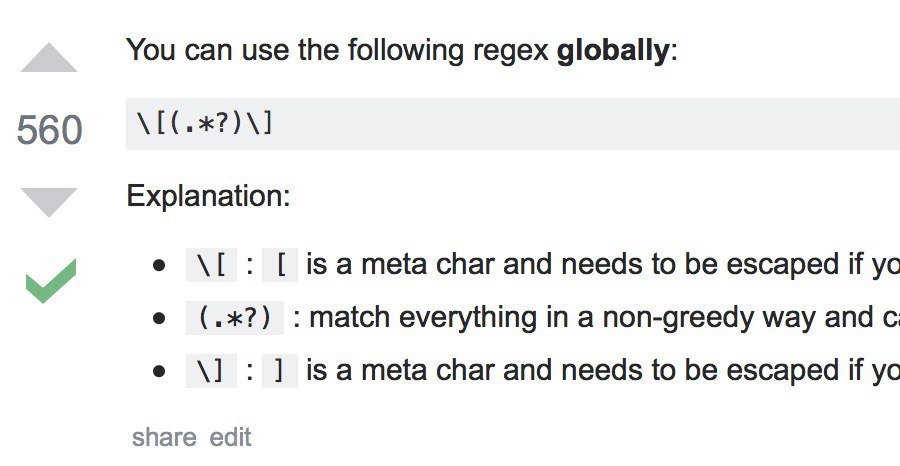
Почему то эскейпинг не работает
mrSubList ("[kek] [kek]s [kek]a" =~ "\[(.*)\]" :: MatchResult String)
<interactive>:20:39: error:
lexical error in string/character literal at character '[
Ryner Reinhardt
 Ryner Reinhardt
И когда оставляешь ? в (.*?) тоже ошибка
Vladislav
Потому что у тебя хаскельный эскейпинг получился, ты наверное \\ хочешь
Ryner Reinhardt
Тоже пробовал
Ryner Reinhardt
mrSubList ("[kek] [kek]s [kek]a" =~ "\\[(.*)\\]" :: MatchResult String)
["kek] [kek]s [kek"]
Vladislav
Ну а можно не страдать с эскейпингом и взять regex-applicative
Vladislav
> Тоже пробовал
Ну так у тебя получилось
Vladislav
Попробуй вместо копирования со StackOverflow понять как регулярки работают
Vladislav
Ты специфицировал, что берешь всё между [ и ], тебе и пришло.
Cheese
Vladislav
Как сказать, чтобы внутри ] не было, тебе тоже показали
Cheese
Ну а можно не страдать с эскейпингом и взять regex-applicative
там придётся страдать с поиском всех вхождений
Vladislav
Один many добавить?
Vladislav
Ок, тогда что-то типа unfoldr вот этого http://hackage.haskell.org/package/regex-applicative-0.3.3/docs/Text-Regex-Applicative.html#v:findFirstInfix
Vladislav
Только там тройка в конце, надо ее в двойку
Vladislav
\(_, a, b) -> (a, b)
Cheese
странно, что Рома не добавил такую штуку в библиотеку
Vladislav
manySep re = many (few anySym *> re)
Vladislav
Или вот так.
Vladislav
findAll re = findFirstPrefix (manySep re)
Cheese
действительно,
λ> unfoldr (\input -> do (_, kek, rest) <- findShortestInfix ("<" *> many anySym <* ">") input; pure (kek, rest)) "<lol> <kek>"
["lol", "kek"]
 A64m
вроде же в GHC.Integer.GMP.Internals должно быть
 Leonid 🦇
boxed - указатель а lifted - с днищем, так?
 Alexander
да
Leonid 🦇
а что может быть lifted unboxed?
A64m
ничего
Leonid 🦇
потому что бывают unboxed, unlifted и lifted а не 2 оси?
A64m
бывает лифтед, анлифтед и зиллион разных анбоксед
Alexander
bytearray же!
Alexander
оно лифтед, но анбоксед
Alexander
ой анлифтед и боксед
Alexander
туплю
A64m
data RuntimeRep = VecRep VecCount VecElem -- ^ a SIMD vector type
| TupleRep [RuntimeRep] -- ^ An unboxed tuple of the given reps
| SumRep [RuntimeRep] -- ^ An unboxed sum of the given reps
| LiftedRep -- ^ lifted; represented by a pointer
| UnliftedRep -- ^ unlifted; represented by a pointer
| IntRep -- ^ signed, word-sized value
| WordRep -- ^ unsigned, word-sized value
| Int64Rep -- ^ signed, 64-bit value (on 32-bit only)
| Word64Rep -- ^ unsigned, 64-bit value (on 32-bit only)
| AddrRep -- ^ A pointer, but /not/ to a Haskell value
| FloatRep -- ^ a 32-bit floating point number
| DoubleRep -- ^ a 64-bit floating point number
A64m
(в head уже больше, короткие инты добавились, но не полный комплект еще)
Alexander
UnliftedRep - represented by a pointer, это что?
A64m
это анлифтед и есть
Leonid 🦇
unboxed sum это типа такого?
struct {
enum { kA, kB } tag;
union {
A a;
B b;
} val;
}
A64m
не совсем
A64m
там все в плоскую структуру запаковывается, но переиспользование места частичное
A64m
The code generator tries to generate as compact layout as possible for each unboxed sum. In the best case, size of an unboxed sum is size of its biggest alternative plus one word (for a tag). The algorithm for generating the memory layout for a sum type works like this:
All types are classified as one of these classes: 32bit word, 64bit word, 32bit float, 64bit float, pointer.
For each alternative of the sum type, a layout that consists of these fields is generated. For example, if an alternative has Int, Float# and String fields, the layout will have an 32bit word, 32bit float and pointer fields.
Layout fields are then overlapped so that the final layout will be as compact as possible. For example, suppose we have the unboxed sum:
(# (# Word32#, String, Float# #)
| (# Float#, Float#, Maybe Int #) #)
The final layout will be something like
Int32, Float32, Float32, Word32, Pointer
The first Int32 is for the tag. There are two Float32 fields because floating point types can’t overlap with other types, because of limitations of the code generator that we’re hoping to overcome in the future. The second alternative needs two Float32 fields: The Word32 field is for the Word32# in the first alternative. The Pointer field is shared between String and Maybe Int values of the alternatives.
As another example, this is the layout for the unboxed version of Maybe a type, (# (# #) | a #):
Int32, Pointer
The Pointer field is not used when tag says that it’s Nothing. Otherwise Pointer points to the value in Just. As mentioned above, this type is lazy in its lifted field. Therefore, the type
data Maybe' a = Maybe' (# (# #) | a #)
is precisely isomorphic to the type Maybe a, although its memory representation is different.
In the degenerate case where all the alternatives have zero width, such as the Bool-like (# (# #) | (# #) #), the unboxed sum layout only has an Int32 tag field (i.e., the whole thing is represented by an integer).
Leonid 🦇
ага. спасибо
Alexander
у меня есть тип для базы, где поля могут быть индексом или хешом, как бы это в 1 тип запихнуть, чтобы не дублировать код?
Alexander
и есть ли у нас что-то готовое, чтобы представлять дифф структуры как тип данных
Alexander
можно отдельный тип для каждого дерайвить, можно общий
Alexander
наверняка же уже кто-нибудь написал?
Leonid 🦇
и есть ли у нас что-то готовое, чтобы представлять дифф структуры как тип данных
типа data Foo = Foo { a :: Int, b :: String } -> data FooDiff { a :: Maybe Int, b :: Maybe String } ?
Leonid 🦇
я такое точно видел на TH написаное. пару лет назад было и память моя уже не та
Alexander
скорее что-то типа:
data Foo = Foo { a :: Int, b :: String }
data FooDiff = FooDiffA Int | FooDiffB String
Leonid 🦇
хм. не такое не видал
Alexander
мне просто нужно ассоциировать изменение с человеческим описанием, из общего диффа я его не выцеплю нормально
Alexander
хотя может и могу
A64m
gdiff
Alexander
да, был такой
Alexander
он нормальный, как то давно мне не подошёл, но там все равно руками пришлось все делать
Alexander
?