 Timur


Правильно пишут код😂😂
 Vasily
мухи отдельно, котлеты отдельно
Timur
А вообще модель не должна импортить ничего кроме libs
Timur
Stdlib
Timur
Vendor
Timur
Selflib
 Wingman
модель и не импортит
Wingman
а вот саму модель - разные пакеты импортят
и друг друга они тоже импортят
Michael
Код в студию голосом Якубовича
Wingman
там много
Wingman
ща ещё посоображаю)
 Aleksey
Кстати, Баду раньше по го хорошие митапы устраивало? Был на других темах, было хорошо.
 Aleksandr
Всем привет! Кто-нибудь работал с этим пакетом https://github.com/uber-go/icu4go? У меня при установке возникает такая ошибка https://github.com/uber-go/icu4go/issues/4.
Нужен мне этот пакет для вывода локализованной даты и времени, т.е. в зависимости от страны выводить в принятном в этой стране формате. Можете подсказать альтернативы?
ручками склонируй. где надо добавь вторую строчку:
// #include "bridge.h"
// #cgo pkg-config: icu-i18n
import "C"
без нее не работает
Anonymous
Denis
Как вы считаете, когда пишу data access layer, на каждую модель есть репозиторий. Как сделать лучше, сделать один общий repo который будет возвращать interface{}, или сделать на каждую реализацию конкретный интерфейс, который возвращает конкретную структуру?
Aleksandr
второй вариант
🎉
Подскажите что это? https://github.com/search?q=topic%3Adependency-injection+org%3Auber-go+fork%3Atrue
 Sergey
Подскажите есть ли сейчас смысл использовать ORM типа gorm,xorm или стоит писать все самому на SQL?
Denis
Подскажите есть ли сейчас смысл использовать ORM типа gorm,xorm или стоит писать все самому на SQL?
Орм за тебя решает проблемы управления пулом коннектов и маппингом.
Если каеф поднять скилл - не используй, для бизнеса - необходимо.
Sergey
Орм за тебя решает проблемы управления пулом коннектов и маппингом.
Если каеф поднять скилл - не используй, для бизнеса - необходимо.
А вы что используете? Я пробовал xorm и gorm. gorm выглядить более удобным
Denis
я использовал только gorm, говорят он лучший, но не type safe. вообще стараюсь не использовать реляционные базы по возможности
Michael
Орм за тебя решает проблемы управления пулом коннектов и маппингом.
Если каеф поднять скилл - не используй, для бизнеса - необходимо.
в Го и без орм есть пул и работает ок ок
Denis
в Го и без орм есть пул и работает ок ок
Ну так за ним следить нужно, обрабатывать все ошибки, ВОВРЕМЯ закрывать.
Например вытащить коллекцию из итератора это не так тривиально как может показаться с первого взгляда.
Michael
Ну так за ним следить нужно, обрабатывать все ошибки, ВОВРЕМЯ закрывать.
Например вытащить коллекцию из итератора это не так тривиально как может показаться с первого взгляда.
вероятно, это дело вкуса или ещё чего, работа с чистым sql & mongo не вызывает проблем
 Pawel
на гошке свои базы данных пишут, стыдно должно быть сиплюсплюсную базу юзать
пусть напишут embedded SQL по образу и подобию sqlite, тогда можно будет пальцы загибать. имхо
пока что по факту из перечисленного
tidb - а зачем ещё один маргинальный SQL сервер?
bolt - годится только для самых простых случаев, а sqlite универсален, практически всегда его можно брать вместо болта без риска что-то потерять
Pawel
Вообще надо сказать что NoSQL - это в принципе в 95%-ах юзкейсов на практике говно, потому что ни кто толком не понимает когда и как его использовать. NoSQL - строго для упрощения и ускорения рапределённых БД без транзакций, всё остальное - от бесов.
В том числе bolt.
В том числе redis в качестве кеша.
Roman
я вот думаю, не надо мыслить чужими штампами. каждый инструмент для своих задач. надо хранить массив структур на время uptime - храним его в []struct. надо быстро найти запись - тогда map[key]struct. надо это расшарить с другими - делаем api. надо сохранять между сеансами - горутиной пишем массив в файл. данных стало много - идем в kv storage. надо джойнить таблицы и делать хитрожопые запросы - переходим на sql. надо поискать соседей - идем в graphql. и т.д.
Anonymous
Наверно не в graphql а в neo4j?
Roman
dgraph
Roman
neo4j не по феншую
Timur
graphql не база
 ceiling cat
+
Graphql это интерфейс к данным
Pawel
даже простой набор рекордов бех хитрых джойнов разумнее хранить в sqlite, чем в болте:
- для sqlite есть крутой тулинг, не надо саому писать гуй для простых КРУД оперций
- sqlite быстрее раза примерно в два
- хитрые джойны могут понадобиться завтра
Pawel
А почему все в один голос советуют эту neo4j, когда есть альтернатива orientdb с кучей профитов?
.
А почему все в один голос советуют эту neo4j, когда есть альтернатива orientdb с кучей профитов?
вообще почему советуют такого рода БД? Каковы преимущества?
 andrew
а можно по подробнее про тулинг?
.
Может вопрос не по теме, но есть ли у кого то статья или видео обьясняющее разницу между разного рода Базами Данных? Типа чем реляцонные хуже/лучше графовых, в чем преимущества и недостатки, и т.п.
Pawel
вообще почему советуют такого рода БД? Каковы преимущества?
если коротко - преимуществ овердофига для графовых и древовидных в частности структур данных
.
Конкретный пример можно?
.
В какой ситуации
 Stanislav
Anonymous
 Pawel
Конкретный пример можно?
Деревьев очень много в предметных областях, но работая с реляционными СУБД их стараются избегать, так как работа с ними вызывает много боли. Оптимизация обхода графа для SSD накопителей вообще нечеловеческими усилиями достигается (если это вообще возможно). Статей на эту тему написано - море. Графовые БД всё это более или менее решают
Pawel
а можно по подробнее про тулинг?
я использую универсальный JetBrains-плагин для всех БД в goland-е, но можно взять софтину, на подобие этой http://sqlitebrowser.org/
Roman
разница в том, что нужно добиться в конкретной задаче - скорости, экономии ресурсов, сложных выборок, отказоустойчивости
Roman
любые субд проигрывают по скорости хранению структур inmemory, это очевидно. но дальше возникают вопросы с долговременным хранением и восстановлением оттуда
Roman
когда данных очень много, их накладно все держать inmemory (раньше так было)
Roman
хотя современные тенденции (sap hana) возвращают нас обратно к kv in memory, за счет наращивания оперативной памяти на серверах
 Vladimir
когда данных очень много, их накладно все держать inmemory (раньше так было)
так сейчас ничего принципиально не изменилось. Есть задачи где можно держать in-memory, есть задачи где нельзя (ну то есть конечно можно, но десятки терабайт памяти не завезли еще).
 Slava
Подскажите, а этот чат чем-то отличается от pro.go? Или просто исторически сложилось, что случилось 2 чата в 1.4к человек и никто их не замержил?
На мой взгляд здесь более адекватные люди, чем в pro.go
 heavycharged
И там и тут вижу одних и тех же людей. Уже по чуть-чуть начинаю путать эти чаты.
Pawel
разница в том, что нужно добиться в конкретной задаче - скорости, экономии ресурсов, сложных выборок, отказоустойчивости
Не-а. Любую SQL БД можно без напрягов использовать в качестве kv storage, а вот обратное утверждение не верно.
А разница именно в ACID. Который в распределённых SQL БД достигается такими ужасными вещами, как шардинг и репликация. Которые в принципе невозможно сделать нормально, без усложнения системы на 1-2 порядка. В nosql ни о каком acid речи не идёт, все гарантии в пределах одного ключа или документа. Поэтому распределённые хранилища nosql не сложнее локальных. Вот для этого nosql и нужен - это ественный выбор для распред. БД без транзакций.
Pawel
А вот это вот всё про производительность и in-memory в контексте SQL vs NoSQL - оно абсолютно ни о чём, потому что тут всё зависит от конкретной схемы данных, а не от СУБД.
Игорь
 heavycharged
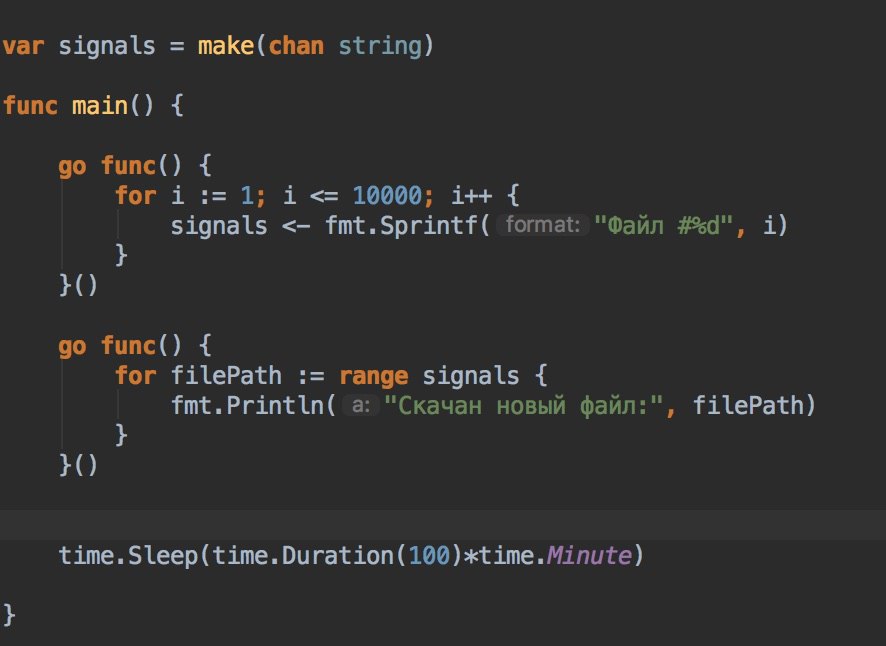
в данном случае - нету смысла. по крайней мере я не вижу его, может на низком уровне это как-то влияет
heavycharged
аргументы в горутины нужно в цикле передавать
heavycharged
и ещё, вместо time.Sleep, посмотрите про sync.WaitGroup.
heavycharged
им легко пользоваться. Сначала делается wg := &sync.WaitGroup{}, затем перед вызовом горутины
wg.Add(1)
go func() {
defer wg.Done()
// ваш код
heavycharged
и в конце wg.Wait()
Pawel
.
Такой вопрос. Есть хэндлер запросов API, есть группы вызовов(users, records, ...). Каждый вызов возвращает ответ через функцию normalResponse (OK) или errorResponse (not OK). Количество строк растет, ориентироваться все сложнее и сложнее. Думал разбить хэндлер на части по группам а потом их импорировать в одном файле. Но тогда проблема с функциями возврата ответа - от них зависят все вызовы, что с ними делать? тоже выносить в отдельный файл и импортировать в каждый файл группы вызовов?
heavycharged
очень странный пример и не менее странный вопрос. "передавать переменные внутрь горутины через аргументы функции" - это что вообще?
это go func(i int) { }(i), если переменная извне горутины, но в данном случае коненчо звучит странно. они уже внутри горутины)
heavycharged
.
Конкретнее показать не могу сейчас
Pawel
это go func(i int) { }(i), если переменная извне горутины, но в данном случае коненчо звучит странно. они уже внутри горутины)
ну это всё равно что спросить как лучше передавать переменные в функцию - через аргументы или глобальные переменные. Ответ - через аргументы конечно, но сдаётся мне вы что-то другое имели ввиду
heavycharged
Конкретнее показать не могу сейчас
Мне сходу не понятны ваши хендлеры, я сейчас пилю подобный веб-проект, и кажется тоже столкнулся с такой-же проблемой. у меня есть пакет status, где есть всякие status.NotFound(), status.InternalError() и прочее. Я просто его импортирую, и в зависимости от того, вернула ли мне модель sql.ErrNoRows, или что-то вроде этого, вызываю хендлер и делаю return. Но честно говоря, решение идиотическое и я думаю как от него уйти. Пока думаю сделать имплементацию ServeMux, но пока не придумал как это мне поможет, все нету времени набросать тестовый проект с несколькими моделями. Ещё можно глянуть в сторону context.Context, он хоть и подходит больше для контроля горутин, но и структурировать все это дело позволяет.
heavycharged
Проблема в том, что везде тонны бойлерплейта вроде
if err != nil {
if err == sql.ErrNoRows {
status.NotFound(w)
return
} else {
//
Тут либо err превращать в какой-то HTTPError, со своим status, а в хендлерах делать if err != nil { handlerError(HttpError) return }
Либо Mux имплементировать, и через ServeHTTP и контексты разруливать. Но не уверен, что там по финалу выйдет лучше.
heavycharged
ну и дробить, дробить, дробить.. делать экшены, выносить из хендлеров логику, и т.д.
Vladimir
Pawel
А можно немного поподробнее рассказать? Какими усложнениями?
шардинг и репликация - это сложно, что тут ещё сказать. В nosql можно жить без этого ценой потери acid, вот и все подробности
Vladimir
Vladimir
шардинг и репликация - это сложно, что тут ещё сказать. В nosql можно жить без этого ценой потери acid, вот и все подробности
А ещё что скажешь про всякие новые базы. Вот в clickhouse есть sql, репликация и шардирование
Vladimir
Вообще что такое acid?
Pawel
А чем сложно?
на настройку и тестирование нод требуется на много больше инженеро-часов, чем на связывание нод для монги. Ну и для обеспечения требований по latency может потребоваться принять много нетривиальных решений и компромисов. В nosql всё это проще
clickhouse не использовал, но по отзывам коллег она очень гут. ну и она колоночная, это не тоже самое что постгрес горизонтально масштабировать (я чисто теоретически говорю)
acid - атомарность, согласованность, изолированность, устойчивость