Roman
Пробовал python с numpy , как-то неуклюже выглядит имхо
Мерль
За скалу ничего не могу сказать Ещё mathematica, но она стоит как карманная звезда смерти
Мерль
Пробовал python с numpy , как-то неуклюже выглядит имхо
Если у тебя чешется 6а красоту и изящность, попробуй хаскель, у меня есть пара знакомых которые ваяют на нём матан при помощи cuda и хитрого DSL на типах По их словам получается быстро, изящно и безопасно, прямо световой меч Но это хардкор, для ты только на изучение концепций языка потратишь примерно столько же времени сколько на изучение основ линейной алгебры, или дальше больше В общем, не могу посоветовать тут ничего более определенного
Мерль
Ну и о документации и туториалах забудь сразу, конечно)
Мерль
только не надо что для ml пофиг какой язык, важнее модель )
На самом деле почти так и есть, сначала лучше изучить предметную область, потом большую часть инструментов ты освоишь очень быстро. Может даже go подойдёт, всякое бывает
Мерль
С матаном все норм, 2.5 курса матфака А вот с опытом в ml пока не очень, присматриваюсь к инструментам
Тогда лучше использовать то, что используют авторы выбранного тобой курса) С вероятностью 0.9 это будет питон+scipy+pyplot+pandas
Pawel
попробуй хаскель, у меня есть пара знакомых которые ваяют на нём матан при помощи cuda и хитрого DSL на типах для хаскеля же почти нет либ нормальных - либо дичь, либо заброшенное контрибьютерами. и caball hell.
Pawel
Ещё годный вариант для машинного обучения - F#, мне понравилось его именно для этих целей. Такой себе гуманный C# с реплом
Daniel
я реально ненавижу это все.
Daniel
даже хороший код на плюсах та еще бодяга (слишком выразительный язык)
Daniel
а говнокод вообще хер прочтешь
Oleg
Содомиты
В скале ты можешь любую последовательность закорючек перегрузить. Тебе не обязательно брать оператор сдвига и говорить, что "теперь это stream output"
Chebyrash
а говнокод вообще хер прочтешь
Перегрузку "+", "-" и "<<" уже обсудили? Это же п*здец какой-то.
Oleg
Можно взять нелепую херню типа ^-?
Мерль
даже хороший код на плюсах та еще бодяга (слишком выразительный язык)
Мне кажется проблема не в выразительности, а в комбинации раздутости языка и его небезопасности
Chebyrash
Oleg
Это же нечитабельно
Никто не спорит, не поэтому для неспособных читать/писать закорючки рядом лежит алиач composeOptional
Daniel
способных писать закорючки многовато на свете
Мерль
Мне кажется проблема не в выразительности, а в комбинации раздутости языка и его небезопасности
И всё это при убогой системе типов Причём мне тут пришло в голову: в go ущербность системы типов в общем-то компенсируется минимализмом языка Это как если бы стрелка индикатора удобства ушла под ноль и подошла к другому концу шкалы 🤔
Oleg
способных писать закорючки многовато на свете
семантически эта закорючка - это точка, вот как user.name вместо user getField name, просто получается, что это programmable structure, и может иметь заранее известные эффекты при set/get операциях. В хачкеле, к слову, это и будет просто точка. Поэтому код с такими закорючками вполне читаем, если вся команда достигла консенсуса использования этого стиля.
Daniel
коллега, я в курсе
Daniel
но у меня специфический опыт
Daniel
я обычно принимаю чужой просраный проект с разбежавшейся командой
Daniel
и тут эта ваша перегрузка операторов начинает выглядеть абсолютным злом
Daniel
абсолютным
Oleg
ну вот, вероятно я очень быстро согласился бы, если бы не слово "абсолютно". Точно также сошлюсь на свою тысячелетний опыт за плечами. Всё-таки повидав и попереписывав тот и другой код могу сказать, что часто за вербозностью просто скрывают сложность кода. В ужатом символьном ДСЛ ты видишь строчку и не можешь понять её назначения. А если заменить иероглифы на инглиш получается три строчки, ощущение WTF уходит. Но напрасно! Потому что склеенные эти три строчки та же чушь, что и была, просто её теперь тружнее заметить, потому что смысловой акцент переместился на имена методов, а не последовательность имён пересенных
Oleg
Действительно, очень часто символьный DSL - наркомания, но иногда - парадоксальный путь к sanity
Michael
Вечер добрый. Подскажите, пожалуйста, как заставить Client из net/http делать все новые запросы через новые tcp-соединения?
Aleksandr
А сейчас не так?
Michael
А сейчас не так?
Я вижу, что идёт подряд несколько http-запросов с одного и того-то tcp-порта.
Michael
Ну и как бы в документации написано, что соединения кэшируются.
.
Что
Aleksandr
Ну и как бы в документации написано, что соединения кэшируются.
Слушай, ну ты дошел до документации, но не смогла в ней прочесть где true поставить для отключения? Как так?
Michael
Вот так.
Aleksandr
Ну перечитай. Поиск по странице tcp, disable, re-use
Michael
при помощи своего транспорта должно получится
Ну вот у меня сейчас выбор: или пересоздавать транспорт или можно имеющийся как-то заставить.
Michael
там есть CloseIdleConnections() . но не ясно, что будет с теми соединениями, которые работают. При следующем запросе они переоткроются или пролдолжат работать по имеющемуся?
Aleksandr
Ну там же есть
Aleksandr
// DisableKeepAlives, if true, prevents re-use of TCP connections // between different HTTP requests. DisableKeepAlives bool
.
Есть кто проходил курс по алгоритмам на Khan Academy? Какие отзывы? https://www.khanacademy.org/computing/computer-science
Anonymous
Приветствую, требуется парсер фб. Цель: спарсить весь фб Реализация: Фэйсбук имеет жесткие лимиты на почти весь парсинг, кроме парсинга по типу имя + город. Этим и воспользуемся. Указываем список городом и список имен. Парсим все, что нам выдают. Алгоритм будет примерно такой: Имеется города Нью-йорк, Филадельфия имена: Минди, Джон, Алиса Парсер обрабатывает так: Минди + Нью-йорк, Джон + Нью-йорк, Алиса + Нью-йорк Минди + Филадельфия, Джон + филадельфия, Алиса + филадельфия Понадобится где-то 1 к потоков. Вероятно, использовать амазон (как я понимаю, они для этих целей имеют сервера) Прокси ipv6. Вероятно, через браузер или имитацию его. Хотя можно и через хттп запросы попробовать. Аккаунты, в любом случае, будут лететь в бан, так что нужен регистратор, который будет подтягивать аккаунты на время парсинга. Далее все это собирается в базу. В которой мы можем: 1) Использовать минус-слова по нужным нам категориям. (например, имя и слово "Лера". Все люди с именем Лера, удалятся) 2) Плюс слова по нужным нам категориям. Например, имя и слово "Лера". Все люди с именем Лера, останутся. Этап фильтрации многоступенчатый. Т.е. операции плюс и минус слов могут использоваться несколько раз. Как в обычной бд. А также понадобится рейтинг по самым популярным совпадениям. Приведу пример. У нас есть категория Имя. Софт считает, сколько имен совпадает и выстраивает рейтинг от самого большого количества к самому меньшему. Если у нас в Списке: Сергей Филатов Сергей Есенин Александр Пушкин Софт выстроит все так: Сергей - 2 Александр 1 Категории: 1) !Вся! графа Favorites (рейтинг) 2) Образование 3) Город 4) имя и фамилия 5) Любимые цитаты (рейтинг_) 6) Работа (рейтинг) 7) пол
Chebyrash
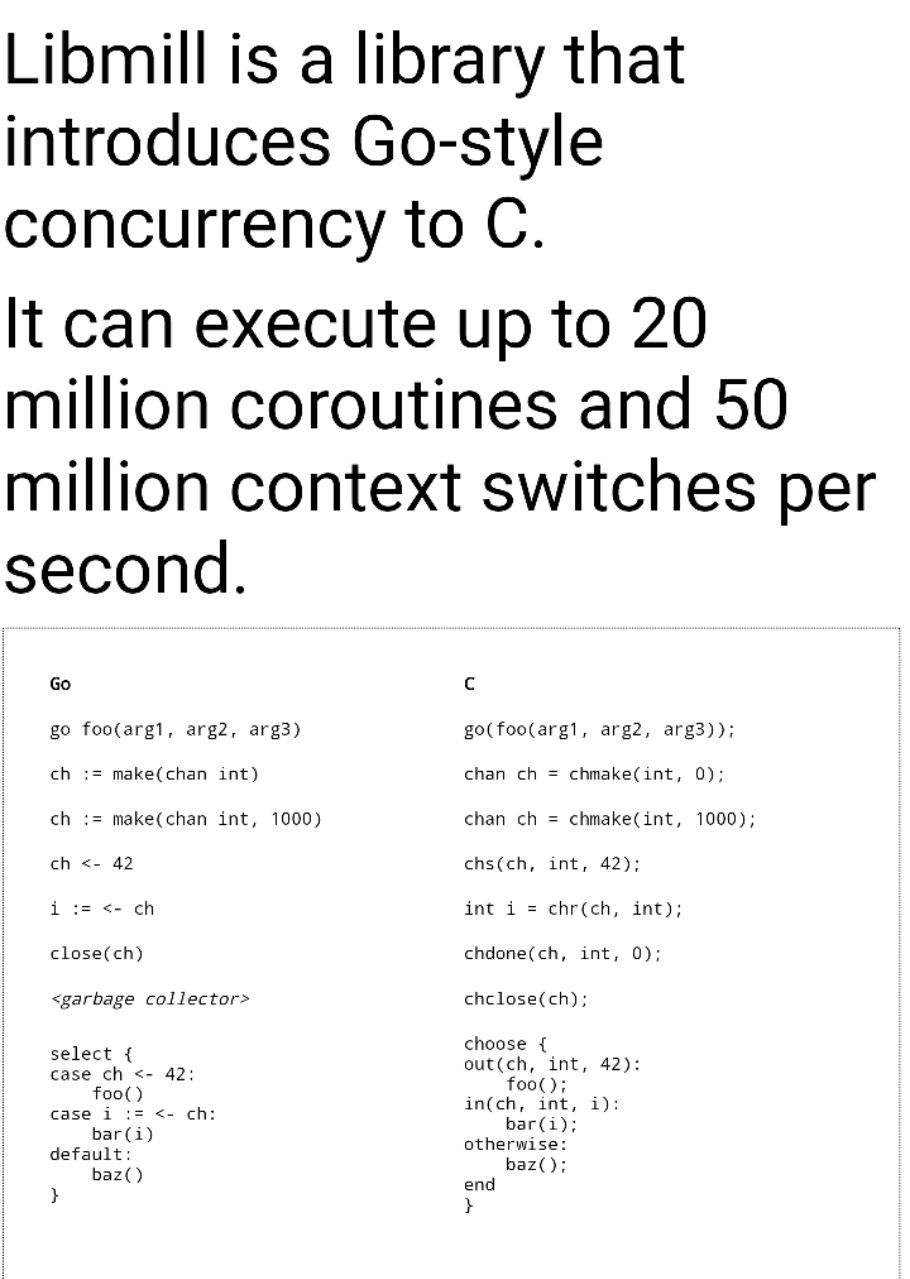
Зацените - libmill.org
Chebyrash
Andrew
Приветствую, требуется парсер фб. Цель: спарсить весь фб Реализация: Фэйсбук имеет жесткие лимиты на почти весь парсинг, кроме парсинга по типу имя + город. Этим и воспользуемся. Указываем список городом и список имен. Парсим все, что нам выдают. Алгоритм будет примерно такой: Имеется города Нью-йорк, Филадельфия имена: Минди, Джон, Алиса Парсер обрабатывает так: Минди + Нью-йорк, Джон + Нью-йорк, Алиса + Нью-йорк Минди + Филадельфия, Джон + филадельфия, Алиса + филадельфия Понадобится где-то 1 к потоков. Вероятно, использовать амазон (как я понимаю, они для этих целей имеют сервера) Прокси ipv6. Вероятно, через браузер или имитацию его. Хотя можно и через хттп запросы попробовать. Аккаунты, в любом случае, будут лететь в бан, так что нужен регистратор, который будет подтягивать аккаунты на время парсинга. Далее все это собирается в базу. В которой мы можем: 1) Использовать минус-слова по нужным нам категориям. (например, имя и слово "Лера". Все люди с именем Лера, удалятся) 2) Плюс слова по нужным нам категориям. Например, имя и слово "Лера". Все люди с именем Лера, останутся. Этап фильтрации многоступенчатый. Т.е. операции плюс и минус слов могут использоваться несколько раз. Как в обычной бд. А также понадобится рейтинг по самым популярным совпадениям. Приведу пример. У нас есть категория Имя. Софт считает, сколько имен совпадает и выстраивает рейтинг от самого большого количества к самому меньшему. Если у нас в Списке: Сергей Филатов Сергей Есенин Александр Пушкин Софт выстроит все так: Сергей - 2 Александр 1 Категории: 1) !Вся! графа Favorites (рейтинг) 2) Образование 3) Город 4) имя и фамилия 5) Любимые цитаты (рейтинг_) 6) Работа (рейтинг) 7) пол
компьютер думал 1 000 лет, а потом выдал результат "42"
Anonymous
Приветствую, требуется парсер фб. Цель: спарсить весь фб Реализация: Фэйсбук имеет жесткие лимиты на почти весь парсинг, кроме парсинга по типу имя + город. Этим и воспользуемся. Указываем список городом и список имен. Парсим все, что нам выдают. Алгоритм будет примерно такой: Имеется города Нью-йорк, Филадельфия имена: Минди, Джон, Алиса Парсер обрабатывает так: Минди + Нью-йорк, Джон + Нью-йорк, Алиса + Нью-йорк Минди + Филадельфия, Джон + филадельфия, Алиса + филадельфия Понадобится где-то 1 к потоков. Вероятно, использовать амазон (как я понимаю, они для этих целей имеют сервера) Прокси ipv6. Вероятно, через браузер или имитацию его. Хотя можно и через хттп запросы попробовать. Аккаунты, в любом случае, будут лететь в бан, так что нужен регистратор, который будет подтягивать аккаунты на время парсинга. Далее все это собирается в базу. В которой мы можем: 1) Использовать минус-слова по нужным нам категориям. (например, имя и слово "Лера". Все люди с именем Лера, удалятся) 2) Плюс слова по нужным нам категориям. Например, имя и слово "Лера". Все люди с именем Лера, останутся. Этап фильтрации многоступенчатый. Т.е. операции плюс и минус слов могут использоваться несколько раз. Как в обычной бд. А также понадобится рейтинг по самым популярным совпадениям. Приведу пример. У нас есть категория Имя. Софт считает, сколько имен совпадает и выстраивает рейтинг от самого большого количества к самому меньшему. Если у нас в Списке: Сергей Филатов Сергей Есенин Александр Пушкин Софт выстроит все так: Сергей - 2 Александр 1 Категории: 1) !Вся! графа Favorites (рейтинг) 2) Образование 3) Город 4) имя и фамилия 5) Любимые цитаты (рейтинг_) 6) Работа (рейтинг) 7) пол
Сделаю сегодня, 5$.
🎉
Приветствую, требуется парсер фб. Цель: спарсить весь фб Реализация: Фэйсбук имеет жесткие лимиты на почти весь парсинг, кроме парсинга по типу имя + город. Этим и воспользуемся. Указываем список городом и список имен. Парсим все, что нам выдают. Алгоритм будет примерно такой: Имеется города Нью-йорк, Филадельфия имена: Минди, Джон, Алиса Парсер обрабатывает так: Минди + Нью-йорк, Джон + Нью-йорк, Алиса + Нью-йорк Минди + Филадельфия, Джон + филадельфия, Алиса + филадельфия Понадобится где-то 1 к потоков. Вероятно, использовать амазон (как я понимаю, они для этих целей имеют сервера) Прокси ipv6. Вероятно, через браузер или имитацию его. Хотя можно и через хттп запросы попробовать. Аккаунты, в любом случае, будут лететь в бан, так что нужен регистратор, который будет подтягивать аккаунты на время парсинга. Далее все это собирается в базу. В которой мы можем: 1) Использовать минус-слова по нужным нам категориям. (например, имя и слово "Лера". Все люди с именем Лера, удалятся) 2) Плюс слова по нужным нам категориям. Например, имя и слово "Лера". Все люди с именем Лера, останутся. Этап фильтрации многоступенчатый. Т.е. операции плюс и минус слов могут использоваться несколько раз. Как в обычной бд. А также понадобится рейтинг по самым популярным совпадениям. Приведу пример. У нас есть категория Имя. Софт считает, сколько имен совпадает и выстраивает рейтинг от самого большого количества к самому меньшему. Если у нас в Списке: Сергей Филатов Сергей Есенин Александр Пушкин Софт выстроит все так: Сергей - 2 Александр 1 Категории: 1) !Вся! графа Favorites (рейтинг) 2) Образование 3) Город 4) имя и фамилия 5) Любимые цитаты (рейтинг_) 6) Работа (рейтинг) 7) пол
Сделаю за час 3$.
Andrew
Покупаю
🎉
Давай
Ты не заказчик. Сорян брат. 😜
Andrew
Ты не заказчик. Сорян брат. 😜
вот черт)) а я уже губу раскатал
Roman
есть парсер пользовательской инфы
Alexander
Ну всё, вот и кончился Go. Потерял свой главный козырь. Расходимся
Nikita
Перекатываемся в С
У вас segmentation fault
Daniel
у них не только сегфолт, у них еще переполнение буфера
Daniel
и утечки памяти
Stanislav
Приветствую, требуется парсер фб. Цель: спарсить весь фб Реализация: Фэйсбук имеет жесткие лимиты на почти весь парсинг, кроме парсинга по типу имя + город. Этим и воспользуемся. Указываем список городом и список имен. Парсим все, что нам выдают. Алгоритм будет примерно такой: Имеется города Нью-йорк, Филадельфия имена: Минди, Джон, Алиса Парсер обрабатывает так: Минди + Нью-йорк, Джон + Нью-йорк, Алиса + Нью-йорк Минди + Филадельфия, Джон + филадельфия, Алиса + филадельфия Понадобится где-то 1 к потоков. Вероятно, использовать амазон (как я понимаю, они для этих целей имеют сервера) Прокси ipv6. Вероятно, через браузер или имитацию его. Хотя можно и через хттп запросы попробовать. Аккаунты, в любом случае, будут лететь в бан, так что нужен регистратор, который будет подтягивать аккаунты на время парсинга. Далее все это собирается в базу. В которой мы можем: 1) Использовать минус-слова по нужным нам категориям. (например, имя и слово "Лера". Все люди с именем Лера, удалятся) 2) Плюс слова по нужным нам категориям. Например, имя и слово "Лера". Все люди с именем Лера, останутся. Этап фильтрации многоступенчатый. Т.е. операции плюс и минус слов могут использоваться несколько раз. Как в обычной бд. А также понадобится рейтинг по самым популярным совпадениям. Приведу пример. У нас есть категория Имя. Софт считает, сколько имен совпадает и выстраивает рейтинг от самого большого количества к самому меньшему. Если у нас в Списке: Сергей Филатов Сергей Есенин Александр Пушкин Софт выстроит все так: Сергей - 2 Александр 1 Категории: 1) !Вся! графа Favorites (рейтинг) 2) Образование 3) Город 4) имя и фамилия 5) Любимые цитаты (рейтинг_) 6) Работа (рейтинг) 7) пол
сделаю. 500k$
Artem
Приветствую, требуется парсер фб. Цель: спарсить весь фб Реализация: Фэйсбук имеет жесткие лимиты на почти весь парсинг, кроме парсинга по типу имя + город. Этим и воспользуемся. Указываем список городом и список имен. Парсим все, что нам выдают. Алгоритм будет примерно такой: Имеется города Нью-йорк, Филадельфия имена: Минди, Джон, Алиса Парсер обрабатывает так: Минди + Нью-йорк, Джон + Нью-йорк, Алиса + Нью-йорк Минди + Филадельфия, Джон + филадельфия, Алиса + филадельфия Понадобится где-то 1 к потоков. Вероятно, использовать амазон (как я понимаю, они для этих целей имеют сервера) Прокси ipv6. Вероятно, через браузер или имитацию его. Хотя можно и через хттп запросы попробовать. Аккаунты, в любом случае, будут лететь в бан, так что нужен регистратор, который будет подтягивать аккаунты на время парсинга. Далее все это собирается в базу. В которой мы можем: 1) Использовать минус-слова по нужным нам категориям. (например, имя и слово "Лера". Все люди с именем Лера, удалятся) 2) Плюс слова по нужным нам категориям. Например, имя и слово "Лера". Все люди с именем Лера, останутся. Этап фильтрации многоступенчатый. Т.е. операции плюс и минус слов могут использоваться несколько раз. Как в обычной бд. А также понадобится рейтинг по самым популярным совпадениям. Приведу пример. У нас есть категория Имя. Софт считает, сколько имен совпадает и выстраивает рейтинг от самого большого количества к самому меньшему. Если у нас в Списке: Сергей Филатов Сергей Есенин Александр Пушкин Софт выстроит все так: Сергей - 2 Александр 1 Категории: 1) !Вся! графа Favorites (рейтинг) 2) Образование 3) Город 4) имя и фамилия 5) Любимые цитаты (рейтинг_) 6) Работа (рейтинг) 7) пол
не сделаю. 1000$
Anonymous
Приветствую, требуется парсер фб. Цель: спарсить весь фб Реализация: Фэйсбук имеет жесткие лимиты на почти весь парсинг, кроме парсинга по типу имя + город. Этим и воспользуемся. Указываем список городом и список имен. Парсим все, что нам выдают. Алгоритм будет примерно такой: Имеется города Нью-йорк, Филадельфия имена: Минди, Джон, Алиса Парсер обрабатывает так: Минди + Нью-йорк, Джон + Нью-йорк, Алиса + Нью-йорк Минди + Филадельфия, Джон + филадельфия, Алиса + филадельфия Понадобится где-то 1 к потоков. Вероятно, использовать амазон (как я понимаю, они для этих целей имеют сервера) Прокси ipv6. Вероятно, через браузер или имитацию его. Хотя можно и через хттп запросы попробовать. Аккаунты, в любом случае, будут лететь в бан, так что нужен регистратор, который будет подтягивать аккаунты на время парсинга. Далее все это собирается в базу. В которой мы можем: 1) Использовать минус-слова по нужным нам категориям. (например, имя и слово "Лера". Все люди с именем Лера, удалятся) 2) Плюс слова по нужным нам категориям. Например, имя и слово "Лера". Все люди с именем Лера, останутся. Этап фильтрации многоступенчатый. Т.е. операции плюс и минус слов могут использоваться несколько раз. Как в обычной бд. А также понадобится рейтинг по самым популярным совпадениям. Приведу пример. У нас есть категория Имя. Софт считает, сколько имен совпадает и выстраивает рейтинг от самого большого количества к самому меньшему. Если у нас в Списке: Сергей Филатов Сергей Есенин Александр Пушкин Софт выстроит все так: Сергей - 2 Александр 1 Категории: 1) !Вся! графа Favorites (рейтинг) 2) Образование 3) Город 4) имя и фамилия 5) Любимые цитаты (рейтинг_) 6) Работа (рейтинг) 7) пол
Договорюсь с Цукербергом, чтобы он сам выгрузил все в Эксель, 1 000 000 BTC: 3MQTRzttkMtsMEy9dRq4Sf1xiSsWKgQkyH
Anonymous
Приветствую, требуется парсер фб. Цель: спарсить весь фб Реализация: Фэйсбук имеет жесткие лимиты на почти весь парсинг, кроме парсинга по типу имя + город. Этим и воспользуемся. Указываем список городом и список имен. Парсим все, что нам выдают. Алгоритм будет примерно такой: Имеется города Нью-йорк, Филадельфия имена: Минди, Джон, Алиса Парсер обрабатывает так: Минди + Нью-йорк, Джон + Нью-йорк, Алиса + Нью-йорк Минди + Филадельфия, Джон + филадельфия, Алиса + филадельфия Понадобится где-то 1 к потоков. Вероятно, использовать амазон (как я понимаю, они для этих целей имеют сервера) Прокси ipv6. Вероятно, через браузер или имитацию его. Хотя можно и через хттп запросы попробовать. Аккаунты, в любом случае, будут лететь в бан, так что нужен регистратор, который будет подтягивать аккаунты на время парсинга. Далее все это собирается в базу. В которой мы можем: 1) Использовать минус-слова по нужным нам категориям. (например, имя и слово "Лера". Все люди с именем Лера, удалятся) 2) Плюс слова по нужным нам категориям. Например, имя и слово "Лера". Все люди с именем Лера, останутся. Этап фильтрации многоступенчатый. Т.е. операции плюс и минус слов могут использоваться несколько раз. Как в обычной бд. А также понадобится рейтинг по самым популярным совпадениям. Приведу пример. У нас есть категория Имя. Софт считает, сколько имен совпадает и выстраивает рейтинг от самого большого количества к самому меньшему. Если у нас в Списке: Сергей Филатов Сергей Есенин Александр Пушкин Софт выстроит все так: Сергей - 2 Александр 1 Категории: 1) !Вся! графа Favorites (рейтинг) 2) Образование 3) Город 4) имя и фамилия 5) Любимые цитаты (рейтинг_) 6) Работа (рейтинг) 7) пол
Привезу сервера из датацентров Facebook вам на дачу. Стоимость: Бюджет России на 2018-ый.
Roman
Всем добрый день, хотел сообщить что вчера оффициально вышла первая бета версия нашей библиотеки вебсокетов: https://github.com/qbeon/webwire-go было бы круто получить feedback от тех, кому тема интересна, буду рад вопросам / комментариям, в любом случае спасибо за внимение! 🙂
Илья
Еще одна зачем
Илья
Еще одна зачем
Увидел в описании
Roman
PR принимаете?
в смысле?)
Chebyrash
в смысле?)
Пулл реквесты
Roman
Зачем?
надеюсь описание написано понятно, если в ней какие-либо неясности то конечно я рад принять критику дабы её улучшить