 Sergey


Сетки на ГПУ считаются
 Arthur
ну машины для гпу вычислений у меня нит (
Sergey
Кароче я конечно давно это все трогал
Но тебя зря посадили)
 Vasiliy
https://leonardo.osnova.io/b7a2c633-1e4e-5942-973f-ba7b0607a4fd/-/format/mp4/
 Крылатый
Велкам бэк
Vasiliy
Прям в тему имени чата
 Doge
На основе чего?
Arthur
Кароче я конечно давно это все трогал
Но тебя зря посадили)
ды я сам вызвался в кач. эксперимента. нужно было заоптимизировать алгоритм классификации. щас мы считаем симилярити по похожим айтемам в бд, а я накидал сетку для бинарной классификации текста
Arthur
тренировал на маленьком датасете, результаты были обнадеживающими (в плане классификации). решил выгрузить 1.3млн рекордов для обучения, но не думал, шо так долго будет
Arthur
так-то у нас мльщик есть, но он щас занят другими делами и к нам доберется очень не скоро, мб ток через пару кварталов
Arthur
Ты не на GPU считаешь? А что за модель?
не, судя по утилизации ресурсов, ml.net считает на цпу (из коробки, во всяком случае). бинарная классификация, averaged perceptron трейнер из мл,нет
Doge
Sergey
Перцептрон:)
Arthur
ну там вроде есть судя по доке и более продвинутые алгоритмы, но в кач. проверки гипотезы пошел по простому пути
Doge
Я думал тут речь про файнтьюн каких-то языковых моделей. И ещё удивился, что это вообще на цпу делается
Arthur
о, натренировало, наконец-то
Doge
А по каким признакам вообще классифицировать нужно?
Arthur
Я думал тут речь про файнтьюн каких-то языковых моделей. И ещё удивился, что это вообще на цпу делается
у меня от МЛя знания из универа почти все выветрились, я не мл инженер, чтобы таким заниматься хд
Arthur
но если выйдет заоптимизировать текущий алгоритм (который сложный и долгий), то на ближайшие пару кварталов сильно облегчим себе жизнь
Arthur
А по каким признакам вообще классифицировать нужно?
ну типа есть набор транзакций клиента, по описанию транзакции нужно определять её тип
Arthur
а типов там пару сотен существует
Doge
ну типа есть набор транзакций клиента, по описанию транзакции нужно определять её тип
В смысле описание текстом на языке?
Arthur
да
Arthur
ну вот ща, пример покажу
Arthur
amount description type ???
____________________________________
250$ Website designing & Development Services
50$ Opening Balance
10$ Fee
Arthur
у нас в бд лежат типы транзакций, грубо говоря, и нужно определять, к какому типу относится та или иная операция
Arthur
и типа как щас работает: мы выгружаем список транзакций, формируем из них пары (50 транзакций как пример и 1 нужно распознать — 50 пар), отправляем в наш МЛ сервис и тот для каждой пары сравнивает similarity index в описаниях. и если где-то большой уровень похожести, то мы говорим, что мы распознали эту 1у транзакцию и она имеет такой-то тип
соот-но, перф у такого решения плохой + само решение сложное + автоматическое распознание держится на уровне 10 - 15% всего. а если взлетит классификация, то мы закроем наши ОКРы на пару кварталов вперед
Arthur
почему так вообще вышло — новое направление в компании, сколотили решение на скорую руку чтобы проверить его потребность
Doge
А не думали посмотреть на всякие BERT и т.п. модели и дообучить одну на эту задачу?
Arthur
А не думали посмотреть на всякие BERT и т.п. модели и дообучить одну на эту задачу?
думали, но это будет не скоро. в планах была существенная оптимизация этого добра, но эти планы наступят не скоро, сейчас другие цели и задачи
Arthur
ну, т.е. не так. что конкретно думали — я хз, я в команду на позапрошлой неделе пришел ) но точно знаю, что хотели писать новое решение с помощью МЛ
Doge
думали, но это будет не скоро. в планах была существенная оптимизация этого добра, но эти планы наступят не скоро, сейчас другие цели и задачи
Просто кажется, что для персептрона это может быть задачей со звездочкой
Doge
Тут все же требуется понимание текста хоть какое-то
Doge
Можно ещё на huggingface посмотреть есть ли модель под задачу уже обученная
Arthur
Просто кажется, что для персептрона это может быть задачей со звездочкой
ну проверю, датасет достаточно большой, подсчитать % успешно распознанных (и сравнить их с теми значениями, которые в бд уже лежат) вполне возможно. если совсем говно будет, то может возьму другое что-то
Doge
ну проверю, датасет достаточно большой, подсчитать % успешно распознанных (и сравнить их с теми значениями, которые в бд уже лежат) вполне возможно. если совсем говно будет, то может возьму другое что-то
А ты прям на всех данных учил или оставил какой-то набор данных вне обучения, чтобы потом можно было провалидировать модель?
Arthur
Doge
Ну зашибись
Doge
Тогда можно будет проверить
Arthur
вообще я вот от сюда инфу брал, какой алгоритм для классификации брать https://docs.microsoft.com/en-us/dotnet/machine-learning/how-to-choose-an-ml-net-algorithm#meta-algorithms
Doge
вообще я вот от сюда инфу брал, какой алгоритм для классификации брать https://docs.microsoft.com/en-us/dotnet/machine-learning/how-to-choose-an-ml-net-algorithm#meta-algorithms
Ну это всё совсем примитив, насколько я понимаю State-of-the-art текущий
Doge
Правда весь State-of-the-art - это берем сервак загруженный нвидиовскими энтерпрайз видюхами под завязку и запускаем модельку с как можно большим числом слоев.
Doge
Так что может это не под ваш кейс
Doge
Зато понимание естественного языка у них отличное
 Антон
https://fsprojects.github.io/FSharpPlus/type-compose.html только сказал, что начал понимать монады, как нихера не понял в этом примере
окей, в three у нас лежит композиция, но как её использовать потом?
Антон
пишешь let! a = three - шлет в очко сразу
Doge
https://fsprojects.github.io/FSharpPlus/type-compose.html только сказал, что начал понимать монады, как нихера не понял в этом примере
окей, в three у нас лежит композиция, но как её использовать потом?
Ух, не надо это всё смотреть на примере FSharpPlus
Антон
Ух, не надо это всё смотреть на примере FSharpPlus
1) почему?
2) так шо с этим three делать-то?
Doge
1) почему?
2) так шо с этим three делать-то?
1. Потому что это набор хаков, а не что-то разумное на чём можно изучать эти темы.
2. А как он тебя точно шлёт и в рамках какого CE?
Sergey
вообще я вот от сюда инфу брал, какой алгоритм для классификации брать https://docs.microsoft.com/en-us/dotnet/machine-learning/how-to-choose-an-ml-net-algorithm#meta-algorithms
Кмк для первых подходов надо было брать питон
Sergey
На гайдах по мл.нет далеко не уедешь
Антон
1. Потому что это набор хаков, а не что-то разумное на чём можно изучать эти темы.
2. А как он тебя точно шлёт и в рамках какого CE?
я пока чисто примеры в fsi пошагово запускаю, выполнил все что на странице, потом начал тупить, и написал let! a = three, что очевидно не работает
Doge
(Что вряд ли)
 Pavel S
Пример на картинке выше это какая-то хуйня нерабочая.
Я имел ввиду, какую проблему решает добавление такой фичи в язык? Если только убирает необходимость заворачивания объекта в кейс юниона, то это хуйня, пушто эта фича усложняет язык для использования/понимания/изучения, усложняет компилятор, и все ради какой-то хуйни, которая никого не напрягает
Untagged unions полезны, есть ишью где обсуждались и (вроде) даже принято решение признать фичу годной и заимплементить. Тема пошла по мотивам фэйбла, иначе интероп с жс либами в ряде кейсов больно и неудобно
Антон
1. Потому что это набор хаков, а не что-то разумное на чём можно изучать эти темы.
2. А как он тебя точно шлёт и в рамках какого CE?
на моем уровне (не)понимания языка как понять что является набором хаков, а что нет?
Doge
на моем уровне (не)понимания языка как понять что является набором хаков, а что нет?
Ну конкретно FSharpPlus им является.
Если хочется лучше со всякими монадами и т.п. ознакомиться, то лучше в хаскель залезть, в нём понять и потом вернуться
Антон
Ну конкретно FSharpPlus им является.
Если хочется лучше со всякими монадами и т.п. ознакомиться, то лучше в хаскель залезть, в нём понять и потом вернуться
ну так вопрос "почему именно он является набором хаков?"
Doge
ну так вопрос "почему именно он является набором хаков?"
Потому что он странным образом пытается эмулировать HKT и тайпклассы
Антон
Потому что он странным образом пытается эмулировать HKT и тайпклассы
это в итоге сказывается на скорости выполнения или непонятных эксепшнах? или и на том и на другом?
Doge
это в итоге сказывается на скорости выполнения или непонятных эксепшнах? или и на том и на другом?
Это сказывается на удобстве пользования библиотекой и разумности сообщений об ошибках компиляции
Антон
Arthur
Тогда у меня будут сильные вопросы к решению которое было до
эхехехех. можешь задавать вопросы
Arthur
 Arthur
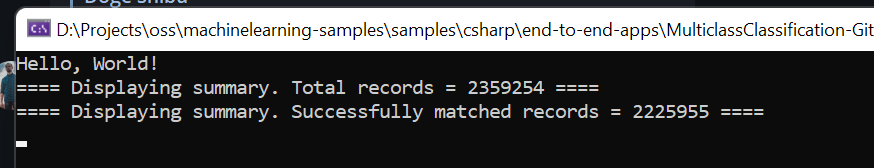
Текущее решение даёт 15%, даже меньше
Arthur
Ну это всё совсем примитив, насколько я понимаю State-of-the-art текущий
А ты не подскажешь, какой алгоритм лучше для этого использовать ? Кажется, что ты лучше меня в теме разбираешься )
Doge
А ты не подскажешь, какой алгоритм лучше для этого использовать ? Кажется, что ты лучше меня в теме разбираешься )
А, тогда кажется, что ничего особо больше и не надо
Arthur
Если совсем помечтать, то если доведу до 99, то можно идти за премией
 Дмитрий
amount description type ???
____________________________________
250$ Website designing & Development Services
50$ Opening Balance
10$ Fee
1) если скорость важна, используй бустинг деревьев, а не вот это всё.
2) для бустинга нужны численные (желательно целые) признаки => бей строки на перекрывающиеся 2-граммы или 3-граммы, и считай сколько каждого биграмма в наблюдении.
3) всё!
Arthur
1) если скорость важна, используй бустинг деревьев, а не вот это всё.
2) для бустинга нужны численные (желательно целые) признаки => бей строки на перекрывающиеся 2-граммы или 3-граммы, и считай сколько каждого биграмма в наблюдении.
3) всё!
У меня кстати много строк из 1-2 слов
Где-то 35% от общего числа. Имеет смысл ?
2ой тезис не понял, сорри ( все ж я не мльщик и не датасаентитст, можешь, пожалуйста, расшифровать или статьей какой-то швырнуться ?)
Arthur
А, тогда кажется, что ничего особо больше и не надо
кажется понял, почему только 94. нашел в датасете большое кол-во одинаковых дескрипшнов, но при этом уже распознанные текущей реализацией типы транзакций различаются, и таких кейсов не мало
хороший вопрос на тему того, не битый ли датасет
Doge
 Ivan
Дмитрий
У меня кстати много строк из 1-2 слов
Где-то 35% от общего числа. Имеет смысл ?
2ой тезис не понял, сорри ( все ж я не мльщик и не датасаентитст, можешь, пожалуйста, расшифровать или статьей какой-то швырнуться ?)
Как раз для небольших и неплохо структурированных примеров небольших и несложных моделей хватает за глаза.
И да, в поиске информации современные лучшие результаты пока на бустинге, а не на нейронках.
Сейчас поищу статью, но общий посыл такой:
Пусть у тебя наблюдения
аб в,
г де,
Тогда твои биграммы
#а, аб, б#, #в, в#, #г, г#, #д,де, е#
Для удобства нумеруешь их и добавляешь «ранее не видимый биграм» в начало (индекс 0).
Тогда «где?» имеет координаты (поиндексно): 0: 1, 6: 1, 8: 1, а все остальные – по нулям. Вот тебе и вектор признаков. Детали я упростил, но и так должно сработать.
Arthur
Как раз для небольших и неплохо структурированных примеров небольших и несложных моделей хватает за глаза.
И да, в поиске информации современные лучшие результаты пока на бустинге, а не на нейронках.
Сейчас поищу статью, но общий посыл такой:
Пусть у тебя наблюдения
аб в,
г де,
Тогда твои биграммы
#а, аб, б#, #в, в#, #г, г#, #д,де, е#
Для удобства нумеруешь их и добавляешь «ранее не видимый биграм» в начало (индекс 0).
Тогда «где?» имеет координаты (поиндексно): 0: 1, 6: 1, 8: 1, а все остальные – по нулям. Вот тебе и вектор признаков. Детали я упростил, но и так должно сработать.
каеф, спасибо! тогда пошел погуглю, может чото получится в эту сторону нарыть, если получится найти статью — буду вдвойне благодарен ))