Есть много каких, есть @async, есть @Scheduled, есть CompletableFuture, есть, прости господи, TaskExecutor и ExecutorService.
Если этот вопрос - продолжение темы про 1000 RPS, то это все немного не в тему, скорее всего, тем более, если там финтех домен. По крайней мере, за решение с мьютексами/локами я бы надавал по рукам
То есть лучше писать многопоток с помощью Java без Spring?
 Neron


 Ziya
То есть лучше писать многопоток с помощью Java без Spring?
Не пишу на джаве, но думаю через спринг можно не писать)
 Данил
То есть лучше писать многопоток с помощью Java без Spring?
Добавь хоть больше контекста, какова суть задачи
 Anna
То есть лучше писать многопоток с помощью Java без Spring?
Нет, посыл был не в этом. Посыл в том, что задача звучит сложнее, чем «добавить многопоточность»
Neron
Добавь хоть больше контекста, какова суть задачи
К сожалению больше ничего нет касательно этой задачи
Neron
Нет, посыл был не в этом. Посыл в том, что задача звучит сложнее, чем «добавить многопоточность»
Ну я понимаю что добавить многопоток и сделать так, чтобы не было конфликтов но при этом так, чтобы от этого продуктивность не слишком страдала
Anna
Ну я понимаю что добавить многопоток и сделать так, чтобы не было конфликтов но при этом так, чтобы от этого продуктивность не слишком страдала
Что такое "продуктивность"?
1000 RPS на кошелек - это огромные цифры, реализовать такое достаточно сложно. Там огромное количество проблем, я хз какой смысл давать такое в тестовом задании и что ожидается от кандидата
Но, собственно, если ты интересуешься "есть ли в spring какая-то реализация многопоточности", то у меня есть небольшие подозрения в том, что, возможно, данное тестовое задание рановато делать
Neron
Что такое "продуктивность"?
1000 RPS на кошелек - это огромные цифры, реализовать такое достаточно сложно. Там огромное количество проблем, я хз какой смысл давать такое в тестовом задании и что ожидается от кандидата
Но, собственно, если ты интересуешься "есть ли в spring какая-то реализация многопоточности", то у меня есть небольшие подозрения в том, что, возможно, данное тестовое задание рановато делать
"Все вопросы решать по своему усмотрению"
Ну и учитывая что там уже кого-то другого взяли не суть важно)
Мне просто интересно довести до полноценно рабочего состояния)
Все остальное довёл вроде уже
Остались только тесты и 1000rps
Neron
Neron
Вот кому интересно сурс
Сказано было сделать за 3 дня, но продлевали дедлайн)
 Иван
 infa
Ребята
У меня вопрос по тестовому заданию (Java, Spring, PostgreSQL, Liquibase, Docker)
Обратите особое внимание проблемам при работе в конкурентной среде (1000 RPS по одному кошельку).
Что это значит и как это реализовывать в джаве. Я полагаю это значит что нужна многопоточность. Если так то есть ли в spring какая-то реализация и если есть то как делать?
Заранее спасибо за помощь
Я думаю что всю проблему многопоточности возьмет на себя веб-сервер просто добавь воркеров если нужно и всё)
Maksim Pozharskiy
 Anna
 Maksim Pozharskiy
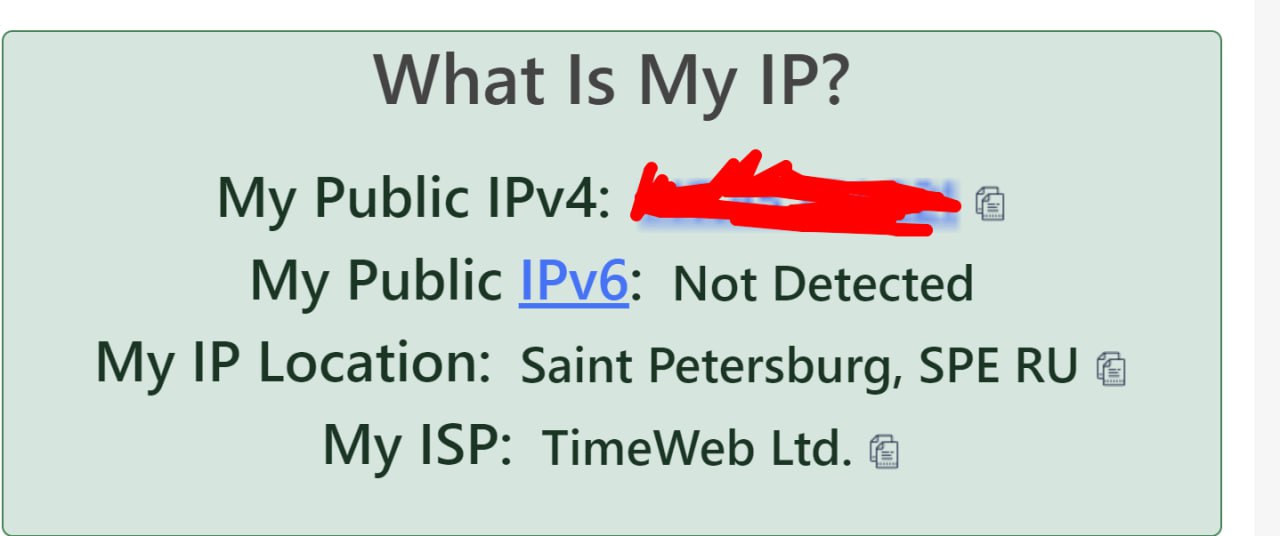
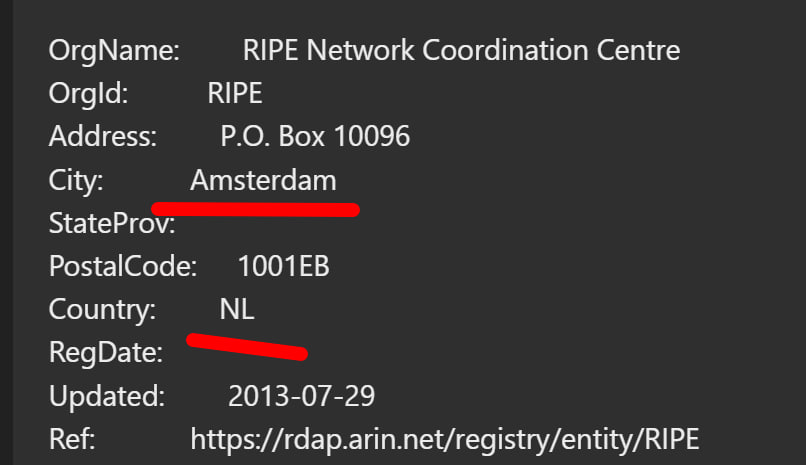
TimeWeb Ltd получается российская компания, но сервера физически в Нидерландах, но зареганы в российской компании (пренадлежат условнго)
Maksim Pozharskiy
Пока ковырялся еще обнаружил интересную штуку.
На одном и том же сайте если проверять IP в гуглхром браузере - тогда показывает РФ.
Если на том же сайте смотреть в MS Edge - тогда показывает Нидерланды.
Сначала подумал что может я хромом пользуюсь поэтому там всякие куки и подобное сохранены что выдаёт что я в РФ, но в инкогните режиме тоже самое.
Получается хром как то еще узнает об этом
Anna
Пока ковырялся еще обнаружил интересную штуку.
На одном и том же сайте если проверять IP в гуглхром браузере - тогда показывает РФ.
Если на том же сайте смотреть в MS Edge - тогда показывает Нидерланды.
Сначала подумал что может я хромом пользуюсь поэтому там всякие куки и подобное сохранены что выдаёт что я в РФ, но в инкогните режиме тоже самое.
Получается хром как то еще узнает об этом
Сравни хедеры, которые передаются при запросе страницы из хрома и из эджа
Oleksii
Oleksii
самое то, а то залетел на фриланс как бекендер, а по факту сижу на фронте
Maksim Pozharskiy
самое то, а то залетел на фриланс как бекендер, а по факту сижу на фронте
пути фриланса неисповедимы
akalexus
Нет, посыл был не в этом. Посыл в том, что задача звучит сложнее, чем «добавить многопоточность»
Прочитайте внимательно задание!
Операции, которые требуется выполнять - простые, не требуют транзакций и блокировок. Ни о какой многопоточности здесь думать особо не надо. Достаточно добавить оптимальное количество потоков воркеров в томкате и этого достаточно, как писал выше Sergey, которому вы поставили дизлайк.
Каждая операция выполняется одним запросом к базе:
1. Увеличение счета выполняется обычным апдейтом.
2. Списание выполняется примерно так:
update accounts set balance=balance-value where account_id=? and balance>=value
где value сумма списания. Апдейт возвращает количество обновленных строк, если 1 - все успешно, если 0 - денег не хватает и списания не происходит. Так как каждый запрос выполняется изолированно на уровне базы (гарантия ACID), то можно выполнять сколь угодно таких запросов параллельно и никаких коллизий и отрицательных балансов не возникнет.
Итого: не думаем в данном задании о многопоточности, реализуем так как я описал выше, также все остальные линейные операции стараемся выполнить проще и оптимально и будем вам счастье. Вполне можно достичь 1000rps.
Есть ещё вопросы по теме?
akalexus
Влом писать решение, через рекурсивный CTE можно решить (если диалект SQL позволяет, он не определен в задаче).
А только через рекурсию в sql и можно решить эту задачу. Т.к. выполнить ее можно только итеративно, когда следующий шаг зависит от результата предыдущего.
Anna
А только через рекурсию в sql и можно решить эту задачу. Т.к. выполнить ее можно только итеративно, когда следующий шаг зависит от результата предыдущего.
Так рекурсивно или итеративно только можно решить? Вы уж определитесь.
Вынудили-таки написать решение в 7 утра через оконные функции без рекурсии: https://www.db-fiddle.com/f/7NLejbD6xbbQxjuKZsnK5q/0
При известной максимальной длине строки вполне себе решение, генератор последовательности выглядит убого, конечно, но у нас ограничение на процедуры.
akalexus
Так рекурсивно или итеративно только можно решить? Вы уж определитесь.
Вынудили-таки написать решение в 7 утра через оконные функции без рекурсии: https://www.db-fiddle.com/f/7NLejbD6xbbQxjuKZsnK5q/0
При известной максимальной длине строки вполне себе решение, генератор последовательности выглядит убого, конечно, но у нас ограничение на процедуры.
Все правильно я сказал. Решается итеративно, но в sql итерации реализуются через рекурсию.
Anna
Прочитайте внимательно задание!
Операции, которые требуется выполнять - простые, не требуют транзакций и блокировок. Ни о какой многопоточности здесь думать особо не надо. Достаточно добавить оптимальное количество потоков воркеров в томкате и этого достаточно, как писал выше Sergey, которому вы поставили дизлайк.
Каждая операция выполняется одним запросом к базе:
1. Увеличение счета выполняется обычным апдейтом.
2. Списание выполняется примерно так:
update accounts set balance=balance-value where account_id=? and balance>=value
где value сумма списания. Апдейт возвращает количество обновленных строк, если 1 - все успешно, если 0 - денег не хватает и списания не происходит. Так как каждый запрос выполняется изолированно на уровне базы (гарантия ACID), то можно выполнять сколь угодно таких запросов параллельно и никаких коллизий и отрицательных балансов не возникнет.
Итого: не думаем в данном задании о многопоточности, реализуем так как я описал выше, также все остальные линейные операции стараемся выполнить проще и оптимально и будем вам счастье. Вполне можно достичь 1000rps.
Есть ещё вопросы по теме?
На момент того сообщения никакой задачи еще не было в чате.
Никто не говорил, что нужно решать через многопоточность. И да, воркеры - лучший подход, я нигде не утверждал обратного. Я лишь говорил, что этого будет недостаточно и приведенное вами решение в лоб - плохое решение.
Во-первых, смотрим как СУБД будет работать при 1000 апдейтах одной строки в секунду. Спойлер: плохо.
Во-вторых, аргумент про ACID странный, ACID не дает гарантий изоляций сам, зависит от уровня изоляции, выставленного в конкретной БД. У вас может быть read uncommitted isolation level (если речь про постгрес), у нас все еще ACID, но никаких гарантий нет.
В-третьих, что будет в случае, если ваш воркер упал в процессе исполнения? Что с идемпотентностью? Что с ретраями?
В-четвертых, нам неизвестно планируемое количество кошельков, это сразу ставит перед собой вопрос возможного партишининга/репликации, что поражает еще огромное количество проблем.
Понятно, что в тестовом задании это не покрыть. Я лишь освещаю потенциальные проблемы и утверждаю тезис, что задача чуть сложнее, чем кажется.
akalexus
Так рекурсивно или итеративно только можно решить? Вы уж определитесь.
Вынудили-таки написать решение в 7 утра через оконные функции без рекурсии: https://www.db-fiddle.com/f/7NLejbD6xbbQxjuKZsnK5q/0
При известной максимальной длине строки вполне себе решение, генератор последовательности выглядит убого, конечно, но у нас ограничение на процедуры.
Генератор декартовым произведением действительно выглядит убого.Мало того, что в нем изначально ограничене на количество, так ещё и громоздкий. Посмотри как красиво просто можно сделать генератор через рекурсию в инете.
Но проблема вообще не в этом, там такой генератор не нужен:
ты неправильно понял задачу - разбить с переносом по целым словам, т.е. если слово не помещается в текущую строку, то надо следующую начать с него. Такое решается только итерацией.
akalexus
На момент того сообщения никакой задачи еще не было в чате.
Никто не говорил, что нужно решать через многопоточность. И да, воркеры - лучший подход, я нигде не утверждал обратного. Я лишь говорил, что этого будет недостаточно и приведенное вами решение в лоб - плохое решение.
Во-первых, смотрим как СУБД будет работать при 1000 апдейтах одной строки в секунду. Спойлер: плохо.
Во-вторых, аргумент про ACID странный, ACID не дает гарантий изоляций сам, зависит от уровня изоляции, выставленного в конкретной БД. У вас может быть read uncommitted isolation level (если речь про постгрес), у нас все еще ACID, но никаких гарантий нет.
В-третьих, что будет в случае, если ваш воркер упал в процессе исполнения? Что с идемпотентностью? Что с ретраями?
В-четвертых, нам неизвестно планируемое количество кошельков, это сразу ставит перед собой вопрос возможного партишининга/репликации, что поражает еще огромное количество проблем.
Понятно, что в тестовом задании это не покрыть. Я лишь освещаю потенциальные проблемы и утверждаю тезис, что задача чуть сложнее, чем кажется.
1. Тебе в любом случае нужно коммитить данные в БД, иначе ты можешь терять деньги при сбоях. Такого быть не должно. При гарантии сохранности денег - только так. Теоретическая возможная альтернатива - геораспределенное хранилище инмемори, из нескольких серверов с кворумом, но там скорость будет медленнее и очень дорого и не вписывается в наш проект. При правильно настроенном постгресе, схеме данных и быстрых дисках - потянет.
2. Естественно, надо установить соответсвующий уровень изоляции - read committed. Ну а вообще, где ты видел уровень изоляции read uncommitted? На практике никогда не видел, чтобы его использовали в системах, где нужны хоть какие-то гарантии.
3. Если упадет воркер или весь сервер или бд, единственное что может случиться - клиент не получит ответа о завершенной транзакции. При этом все равно ничего лишнего никогда не спишемся и баланс не уйдет в минус. Если нужна полная надёжность - то распределённая транзакция с брокером сообщений и сервисом гарантированной доставки. Но это не соответствует условиям задачи, т.к. у нас просто REST в задании.
4. Да, мы не знаем сколько у нас кошельков. Но в задании явно не требуется проектировать twitter с десятками миллионов запросов секунду, это тоже выходит за рамки и совсем другая архитектура точно не для джунского задания.
Anna
Генератор декартовым произведением действительно выглядит убого.Мало того, что в нем изначально ограничене на количество, так ещё и громоздкий. Посмотри как красиво просто можно сделать генератор через рекурсию в инете.
Но проблема вообще не в этом, там такой генератор не нужен:
ты неправильно понял задачу - разбить с переносом по целым словам, т.е. если слово не помещается в текущую строку, то надо следующую начать с него. Такое решается только итерацией.
Хорошо, спасибо за совет, обязательно посмотрю в интернете :)
Но в целом подобная пассивно-агрессивная форма подачи не очень приветствуется тут.
akalexus
На момент того сообщения никакой задачи еще не было в чате.
Никто не говорил, что нужно решать через многопоточность. И да, воркеры - лучший подход, я нигде не утверждал обратного. Я лишь говорил, что этого будет недостаточно и приведенное вами решение в лоб - плохое решение.
Во-первых, смотрим как СУБД будет работать при 1000 апдейтах одной строки в секунду. Спойлер: плохо.
Во-вторых, аргумент про ACID странный, ACID не дает гарантий изоляций сам, зависит от уровня изоляции, выставленного в конкретной БД. У вас может быть read uncommitted isolation level (если речь про постгрес), у нас все еще ACID, но никаких гарантий нет.
В-третьих, что будет в случае, если ваш воркер упал в процессе исполнения? Что с идемпотентностью? Что с ретраями?
В-четвертых, нам неизвестно планируемое количество кошельков, это сразу ставит перед собой вопрос возможного партишининга/репликации, что поражает еще огромное количество проблем.
Понятно, что в тестовом задании это не покрыть. Я лишь освещаю потенциальные проблемы и утверждаю тезис, что задача чуть сложнее, чем кажется.
Я предложил реально простое решение соответствующее тестовому несложному заданию, а вы начали бросаться аргументами и нюансами сопоставимыми со сложной большой системой.
Anna
Сергей
Шо тут происходит?
 Azamat
akalexus
Хорошо, спасибо за совет, обязательно посмотрю в интернете :)
Но в целом подобная пассивно-агрессивная форма подачи не очень приветствуется тут.
Ничего личного, никого не хотел оскорблять. Но если что-то выглядит действительно не очень, я считаю, что не надо льстить, а прямо сказать об этом.
Сергей
Эх, все бы ничего, но предложенное решение плохо масштабируется, есть проблемы с параллельным доступом, потом при увеличении нагрузки у нас пойдут проблемы с консистенцией.
Когда потом, с большей нагрузкой, мы вернемся к этому - это доп затраты. Так же мы не обрабатываем никак ошибки.
В итоге мы имеем так себе ответ, который ну очень слабо тянет на существование в будущем. Чувствую, что вы не ответили бы на фолловап вопросы и тем самым провалили бы собеседование в компанию. ☺️
 Алексей
akalexus
Эх, все бы ничего, но предложенное решение плохо масштабируется, есть проблемы с параллельным доступом, потом при увеличении нагрузки у нас пойдут проблемы с консистенцией.
Когда потом, с большей нагрузкой, мы вернемся к этому - это доп затраты. Так же мы не обрабатываем никак ошибки.
В итоге мы имеем так себе ответ, который ну очень слабо тянет на существование в будущем. Чувствую, что вы не ответили бы на фолловап вопросы и тем самым провалили бы собеседование в компанию. ☺️
Вот вы опять проектируете Bank of America. Это же задание джуну, там не было никаких вопросов масштабирования и гарантированной отказоустойчивости с кучей девяток.
Я решал указанное задание, а не надуманный вами сложный проект.
Сергей
Вот вы опять проектируете Bank of America. Это же задание джуну, там не было никаких вопросов масштабирования и гарантированной отказоустойчивости с кучей девяток.
Я решал указанное задание, а не надуманный вами сложный проект.
Проблема как раз таки в том, что вы очень узко смотрите на то, что написано на бумаге, хороший подход подразумевает что вы, как минимум спросите пару-тройку доп вопросов и тем самым реализуете самое эффективное решение. Это сделано? Нет.
Банк Америки проектировать не надо, но решение тяжело назвать эффективным, просто потому что он плохо масштабируется.
Удачи 🙂
Сергей
Так может оно и не планируется к масштабируемости
Сегодня у вас покупают картошку Петя и Вова, а завтра ещё все их одноклассники. А потом ещё из соседней школы, района, города, вы картофельный магнат. Вопрос: на сколько у вас хватит сил - таскать столько картошки на такую толпу?
akalexus
Проблема как раз таки в том, что вы очень узко смотрите на то, что написано на бумаге, хороший подход подразумевает что вы, как минимум спросите пару-тройку доп вопросов и тем самым реализуете самое эффективное решение. Это сделано? Нет.
Банк Америки проектировать не надо, но решение тяжело назвать эффективным, просто потому что он плохо масштабируется.
Удачи 🙂
Ну даже и не знаю. Дискуссионный вопрос. Задание было конкретное, без всего этого. Считаю, что не надо усложнять там, где этого не требуется. Надо продавая картошку думать наперед о том, что эту картошку будет есть Вася, который встретит Люсю и у них будет сын Петя, который станет серийным убийцем и ты будешь виноват в этом: так если бы все просчитал и не продал Васе, то он не встретил бы Люсю и не было бы убийцы и жертв. Вот такаю аналогию я вижу.
 Макс
Алексей
Сегодня у вас покупают картошку Петя и Вова, а завтра ещё все их одноклассники. А потом ещё из соседней школы, района, города, вы картофельный магнат. Вопрос: на сколько у вас хватит сил - таскать столько картошки на такую толпу?
А может я продаю горилку только своим друзьям в количестве 5 человек?
Алексей
Так-себе бизнес XD
Так дискуссия про масштабируемость а не про качество бизнеса. Мало ли мы знаем "Ашотов" которые торгуют всю жизнь с одного лотка так никуда и не масштабировались
akalexus
А может я продаю горилку только своим друзьям в количестве 5 человек?
Главное не забывай регулярно бэкапиться.
Neron
Ну даже и не знаю. Дискуссионный вопрос. Задание было конкретное, без всего этого. Считаю, что не надо усложнять там, где этого не требуется. Надо продавая картошку думать наперед о том, что эту картошку будет есть Вася, который встретит Люсю и у них будет сын Петя, который станет серийным убийцем и ты будешь виноват в этом: так если бы все просчитал и не продал Васе, то он не встретил бы Люсю и не было бы убийцы и жертв. Вот такаю аналогию я вижу.
Ну слушай
С другой стороны если сделать продумав то можно показать работодателю что ты думаешь наперёд
Хотя и показать что ты усложняешь тоже можно
Neron
Ладно
Вернусь к начальному вопросу
Как лучше делать? Полагаю через воркеры, но напомните что такое воркеры
В целом делаю уже для себя, так что наверное лучше делать с расчетом на всё
Anna
1. Тебе в любом случае нужно коммитить данные в БД, иначе ты можешь терять деньги при сбоях. Такого быть не должно. При гарантии сохранности денег - только так. Теоретическая возможная альтернатива - геораспределенное хранилище инмемори, из нескольких серверов с кворумом, но там скорость будет медленнее и очень дорого и не вписывается в наш проект. При правильно настроенном постгресе, схеме данных и быстрых дисках - потянет.
2. Естественно, надо установить соответсвующий уровень изоляции - read committed. Ну а вообще, где ты видел уровень изоляции read uncommitted? На практике никогда не видел, чтобы его использовали в системах, где нужны хоть какие-то гарантии.
3. Если упадет воркер или весь сервер или бд, единственное что может случиться - клиент не получит ответа о завершенной транзакции. При этом все равно ничего лишнего никогда не спишемся и баланс не уйдет в минус. Если нужна полная надёжность - то распределённая транзакция с брокером сообщений и сервисом гарантированной доставки. Но это не соответствует условиям задачи, т.к. у нас просто REST в задании.
4. Да, мы не знаем сколько у нас кошельков. Но в задании явно не требуется проектировать twitter с десятками миллионов запросов секунду, это тоже выходит за рамки и совсем другая архитектура точно не для джунского задания.
1. Конечно, но их можно просто сохранять как transaction log, и в бекграунде время от времени (как собственно это примерно и делается в реальной жизни). Схема с 1000 апдейтами одной строки в секунду - это плохая идея даже для джуниорского тестового задания.
2. Поинт в том, что каждый запрос выполняется изолированно на уровне базы (гарантия ACID), - некорректный тезис, ибо ACID - это про транзакции, а не про гарантированность изоляции. Ну и если на то пошло, при Read Committed нет гарантий того, что не будет lost updates (2 транзакции на апдейт выполняются одновременно, первая ее не закомичена, вторая выполняется после, результатом будет потерянная первая транзакция).
3. >> Если упадет воркер или весь сервер или бд, единственное что может случиться - клиент не получит ответа о завершенной транзакции.
Это не так. Воркер может упасть в момент, когда транзакция завершена, тогда пользователь не узнает, что транзакция была завершена и повторит запрос. Воркер может упасть посередине транзакции, тогда есть вероятность лока. Вариантов масса.
Скажу больше, "Если нужна полная надёжность - то распределённая транзакция с брокером сообщений и сервисом гарантированной доставки. Но это не соответствует условиям задачи, т.к. у нас просто REST в задании." - это не гарантирует полной надежности никак.
4. "Да, мы не знаем сколько у нас кошельков. Но в задании явно не требуется проектировать twitter с десятками миллионов запросов секунду, это тоже выходит за рамки и совсем другая архитектура точно не для джунского задания."
Это неизвестно, я не знаю, каккие критерии оценки тестового задания. В моей текущей компании вполне могли бы дать такое задание, подразумевая жесткий хайлоад, в том числе и на джуниорскую позицию.
Anna
Я предложил реально простое решение соответствующее тестовому несложному заданию, а вы начали бросаться аргументами и нюансами сопоставимыми со сложной большой системой.
Мне не хочется продолжать бессмысленный спор.
Мой поинт был не в том, что "АХАХАХА ВЫ ВСЕ ДЕЛАЕТЕ НЕ ТАК", а в том, что задание ВОЗМОЖНО гораздо сложнее, нежели простое решение в лоб, и я объяснил, в чем могут быть подводные камни.
Мне до сих пор кажется странным условие 1000 rps для одного кошелька, я так и не понял, зачем это было добавлено в несложное тестовое задание, вот и все.
Anna
Ничего личного, никого не хотел оскорблять. Но если что-то выглядит действительно не очень, я считаю, что не надо льстить, а прямо сказать об этом.
Поинт был в том, что выше вы ультимативно сказали, что есть только рекурсивное решение, я привел пример итеративного. Теперь у вас возмущение, что итеративное решение "некрасивое", про красоту никакого уговора не было.
Затем начались непонятные нападки "посмотри как красиво сделать рекурсивно ". Ну я могу в ответ сказать, "погугли μ-recursive functions и доказательство того, что любая рекурсия может быть написана итеративно". Про "красоту" и "неубогость" решения никто не говорил.
Про "неправильно понял задачу" - оно не особо сложно допиливается до нужного состояния, я накидал примерное напрвавление без рекурсии.
Мир, дружба, жвачка
akalexus
Поинт был в том, что выше вы ультимативно сказали, что есть только рекурсивное решение, я привел пример итеративного. Теперь у вас возмущение, что итеративное решение "некрасивое", про красоту никакого уговора не было.
Затем начались непонятные нападки "посмотри как красиво сделать рекурсивно ". Ну я могу в ответ сказать, "погугли μ-recursive functions и доказательство того, что любая рекурсия может быть написана итеративно". Про "красоту" и "неубогость" решения никто не говорил.
Про "неправильно понял задачу" - оно не особо сложно допиливается до нужного состояния, я накидал примерное напрвавление без рекурсии.
Мир, дружба, жвачка
Да нет же. Ну не решили вы задачу от слова совсем. Вы решили другую, простую задачу, которая решается легко, а ту, которая была в условии можно решить только через рекурсию, вы не решили.
akalexus
1. Конечно, но их можно просто сохранять как transaction log, и в бекграунде время от времени (как собственно это примерно и делается в реальной жизни). Схема с 1000 апдейтами одной строки в секунду - это плохая идея даже для джуниорского тестового задания.
2. Поинт в том, что каждый запрос выполняется изолированно на уровне базы (гарантия ACID), - некорректный тезис, ибо ACID - это про транзакции, а не про гарантированность изоляции. Ну и если на то пошло, при Read Committed нет гарантий того, что не будет lost updates (2 транзакции на апдейт выполняются одновременно, первая ее не закомичена, вторая выполняется после, результатом будет потерянная первая транзакция).
3. >> Если упадет воркер или весь сервер или бд, единственное что может случиться - клиент не получит ответа о завершенной транзакции.
Это не так. Воркер может упасть в момент, когда транзакция завершена, тогда пользователь не узнает, что транзакция была завершена и повторит запрос. Воркер может упасть посередине транзакции, тогда есть вероятность лока. Вариантов масса.
Скажу больше, "Если нужна полная надёжность - то распределённая транзакция с брокером сообщений и сервисом гарантированной доставки. Но это не соответствует условиям задачи, т.к. у нас просто REST в задании." - это не гарантирует полной надежности никак.
4. "Да, мы не знаем сколько у нас кошельков. Но в задании явно не требуется проектировать twitter с десятками миллионов запросов секунду, это тоже выходит за рамки и совсем другая архитектура точно не для джунского задания."
Это неизвестно, я не знаю, каккие критерии оценки тестового задания. В моей текущей компании вполне могли бы дать такое задание, подразумевая жесткий хайлоад, в том числе и на джуниорскую позицию.
1. Лог сохранять то можно. Но как вы думаете работает база? Оказывается, она тоже пишет данные во write ahead log. Предлагаете написать свой велосипед круче бд? Или сохранять в памяти и терять транзакции при сбое. Или писать сложный диспетчер с блокировками, который пакетно обрабатывает запросы и который не под силу даже мидлу, не говоря уже о джуне?
2. Подтяните, пожалуйста, теорию баз данных. База гарантирует, что отдельно взятый запрос либо выполнится целиком согласованно по всем данным, которые он затрагивает, либо не выполнится совсем. Это называется неявная транзакция на уровне оператора. Иначе, будет полный хаос. Нам необязательно явно начинать транзакцию, т.к. у нас один запрос. Он выполнится гарантированно транзакционно, что нам и требуется. ACID будет соблюдён неукоснительно, никаких lost updates не будет. Коллизия возможна только если выполняется несколько отдельных запросов. Это достигается блокировкой изменяемых строк на время запроса.
3. Вы написали, что я не прав, а потом тут же повторили точь в точь то, что я сказал, что клиент может не получить ответа о завершенной транзакции при сбое. И если вы утверждаете, что мое решение с брокером не даёт должной гарантии, то я парирую, что полной гарантии не может дать ничто, но надо исходить из благоразумия.
4. Заставлять на собесе проектировать жесткий хайлоад джуна? Серьезно? А потом он все равно будет перекладывать джейсоны, потому что джуны не могут делать жёсткий хайлоад. Иначе это не джун. Даже многие сеньоры не могут это сделать. Могут побросаться технологиями в теории в разговоре, но на практике не смогут.
akalexus
Ну слушай
С другой стороны если сделать продумав то можно показать работодателю что ты думаешь наперёд
Хотя и показать что ты усложняешь тоже можно
Будешь усложнять, можешь уехать в темы, в которых тебя завалят и сочтут балаболом. Лучше выполнить задание как просят, а устно можно потом и подискутировать о теоретических возможных улучшениях.
akalexus
Ладно
Вернусь к начальному вопросу
Как лучше делать? Полагаю через воркеры, но напомните что такое воркеры
В целом делаю уже для себя, так что наверное лучше делать с расчетом на всё
Сам решай как делать. Я бы на собесе джуна, который сделал бы как я сказал и смог бы обосновать это, сразу взял без вопросов.
Воркеры или лисенеры - это пул потоков в томкате, которые обрабатывают входящие запросы. Оптимальное значение зависит от нескольких параметров: кол-ва ядер, ожидаемого rps, характер нагрузки (io/cpu) т.д.
Anna
1. Лог сохранять то можно. Но как вы думаете работает база? Оказывается, она тоже пишет данные во write ahead log. Предлагаете написать свой велосипед круче бд? Или сохранять в памяти и терять транзакции при сбое. Или писать сложный диспетчер с блокировками, который пакетно обрабатывает запросы и который не под силу даже мидлу, не говоря уже о джуне?
2. Подтяните, пожалуйста, теорию баз данных. База гарантирует, что отдельно взятый запрос либо выполнится целиком согласованно по всем данным, которые он затрагивает, либо не выполнится совсем. Это называется неявная транзакция на уровне оператора. Иначе, будет полный хаос. Нам необязательно явно начинать транзакцию, т.к. у нас один запрос. Он выполнится гарантированно транзакционно, что нам и требуется. ACID будет соблюдён неукоснительно, никаких lost updates не будет. Коллизия возможна только если выполняется несколько отдельных запросов. Это достигается блокировкой изменяемых строк на время запроса.
3. Вы написали, что я не прав, а потом тут же повторили точь в точь то, что я сказал, что клиент может не получить ответа о завершенной транзакции при сбое. И если вы утверждаете, что мое решение с брокером не даёт должной гарантии, то я парирую, что полной гарантии не может дать ничто, но надо исходить из благоразумия.
4. Заставлять на собесе проектировать жесткий хайлоад джуна? Серьезно? А потом он все равно будет перекладывать джейсоны, потому что джуны не могут делать жёсткий хайлоад. Иначе это не джун. Даже многие сеньоры не могут это сделать. Могут побросаться технологиями в теории в разговоре, но на практике не смогут.
Да что за пассивно-агрессаивный язык такой. Будем продолжать так писать? Окей, я принимаю правила игры.
1. Научитесь в разницу между WAL и transactional log. Я не про физические транзакции, я про транзакции на уровне приложения.
Посмотрите технические доклады финтеха в конце-то концов. Разберитесь в топике, потом подумайте глубоко и приходите пообщаться.
2. Подтяните знания про ACID. Вы смешали в кучу все подряд.
Почитайте про read committed и lost updates. Минимальный уровень, чтобы гарантировать отсутствие lost updates - это repeatable read. Если вы этого не знаете и утверждаете обратное - то дальнейший диалог бесполезен, я рекомендую подтянуть знания СУБД.
3. Вы рассмотрели частный случай, я оспорил заявление "единственное что может случиться - клиент не получит ответа о завершенной транзакции." Я написал, что может случиться, и, в зависимости от падения, варианты будут разными.
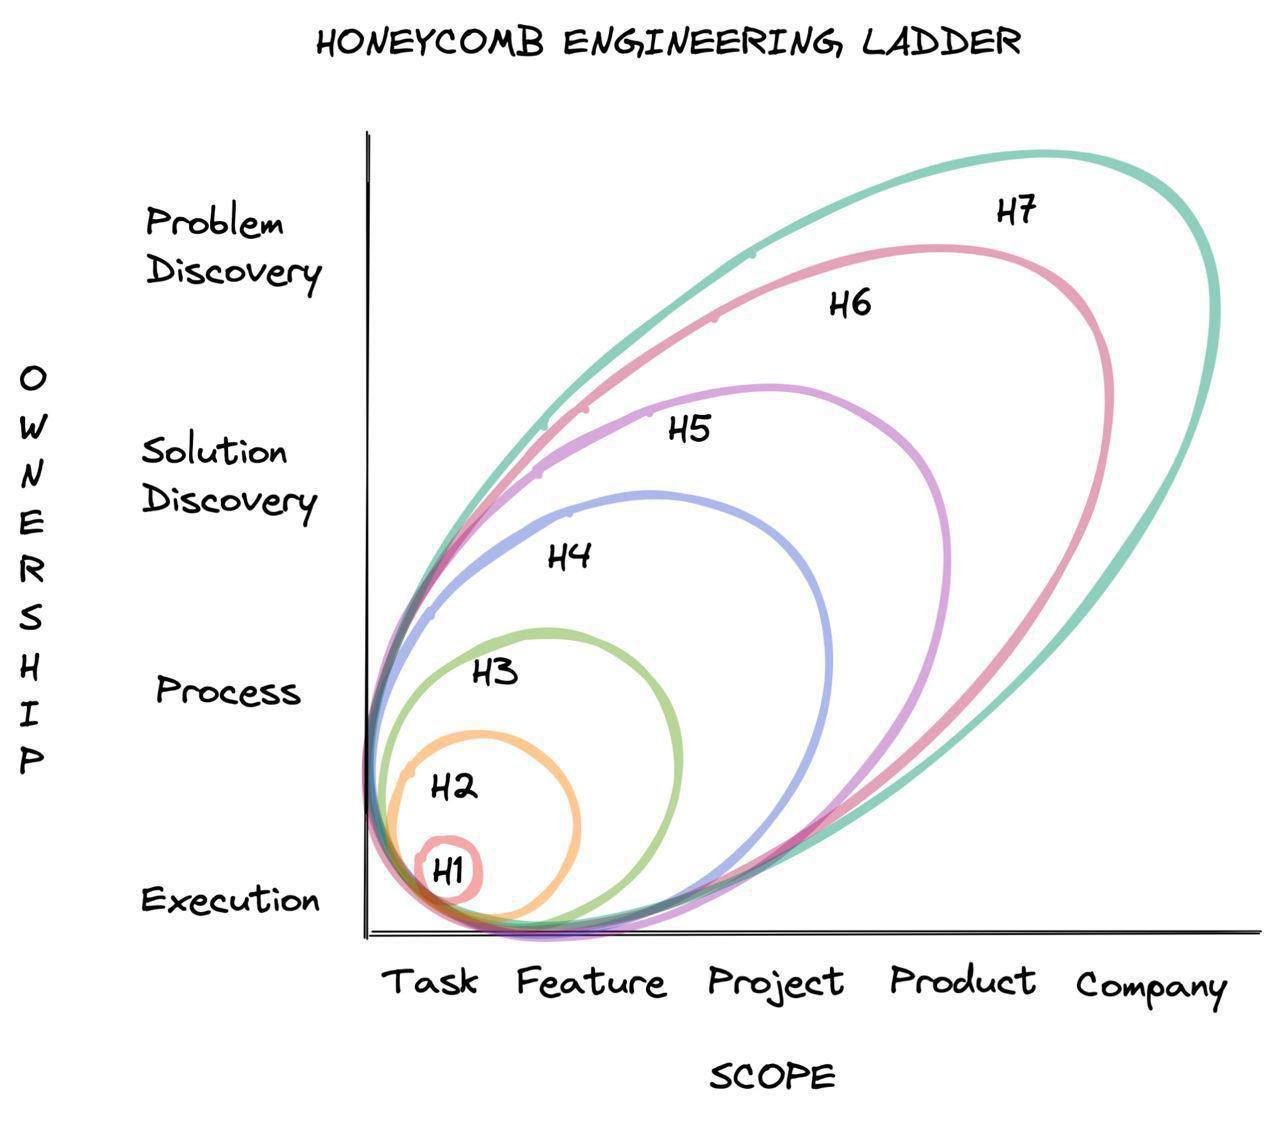
4. Джун != entry level. Грейд не особо зависит от технических знаний в бигтех компаниях. Если не разбираетесь в вопросе, рекомендую посмотреть описание левелов в ФААНГе, возможно, это поможет в вашем пути становления профессиональным программистом.
В целом не вижу смысла говорить с непрофессионалом, как только изучите вопросы чуть глубже (ну или прекратите писать в таком стиле) тогда возможно и поговорим. Удачи в этом нелегком пути
Anna
Да нет же. Ну не решили вы задачу от слова совсем. Вы решили другую, простую задачу, которая решается легко, а ту, которая была в условии можно решить только через рекурсию, вы не решили.
https://www.db-fiddle.com/f/n78qUYMXTN4bvUfv6ctRAh/0
Пожалуйста, решение без рекурсии.
Или вы считаете set-based операции в оконных функциях не итеративными?
Больше не хочу тратить время на общение с вами, спасибо.
akalexus
Да что за пассивно-агрессаивный язык такой. Будем продолжать так писать? Окей, я принимаю правила игры.
1. Научитесь в разницу между WAL и transactional log. Я не про физические транзакции, я про транзакции на уровне приложения.
Посмотрите технические доклады финтеха в конце-то концов. Разберитесь в топике, потом подумайте глубоко и приходите пообщаться.
2. Подтяните знания про ACID. Вы смешали в кучу все подряд.
Почитайте про read committed и lost updates. Минимальный уровень, чтобы гарантировать отсутствие lost updates - это repeatable read. Если вы этого не знаете и утверждаете обратное - то дальнейший диалог бесполезен, я рекомендую подтянуть знания СУБД.
3. Вы рассмотрели частный случай, я оспорил заявление "единственное что может случиться - клиент не получит ответа о завершенной транзакции." Я написал, что может случиться, и, в зависимости от падения, варианты будут разными.
4. Джун != entry level. Грейд не особо зависит от технических знаний в бигтех компаниях. Если не разбираетесь в вопросе, рекомендую посмотреть описание левелов в ФААНГе, возможно, это поможет в вашем пути становления профессиональным программистом.
В целом не вижу смысла говорить с непрофессионалом, как только изучите вопросы чуть глубже (ну или прекратите писать в таком стиле) тогда возможно и поговорим. Удачи в этом нелегком пути
1. Использовать transaction log в данном решении это бред. Т.е. как минимум удвоить IO. А как вы собираетесь учитывать баланс, чтобы в минус не уйти при очередной транзакции, клиенту надо же сразу ответить? Тоже хранить его ещё где то отдельно и утроить IO?
2. Про ACID поговорим завтра. Но ещё раз повторю: lost update здесь не произойдет даже при read committed, это не тот случай. БД заблокирует строку, изменит атомарно и разблокирует. Две транзакции не могут одновременно изменять одну и ту же строку.
4. От чего же тогда зависит грейд, если не от технических знаний и опыта?
В целом, тоже пока не убедили, что профессионально владеете техническими знаниями, особенно в области БД.
Сергей
1. Использовать transaction log в данном решении это бред. Т.е. как минимум удвоить IO. А как вы собираетесь учитывать баланс, чтобы в минус не уйти при очередной транзакции, клиенту надо же сразу ответить? Тоже хранить его ещё где то отдельно и утроить IO?
2. Про ACID поговорим завтра. Но ещё раз повторю: lost update здесь не произойдет даже при read committed, это не тот случай. БД заблокирует строку, изменит атомарно и разблокирует. Две транзакции не могут одновременно изменять одну и ту же строку.
4. От чего же тогда зависит грейд, если не от технических знаний и опыта?
В целом, тоже пока не убедили, что профессионально владеете техническими знаниями, особенно в области БД.
 Сергей
Еще проще - senior где-то у вас в компании, далеко не senior в около FAANG компаниях
akalexus
https://www.db-fiddle.com/f/n78qUYMXTN4bvUfv6ctRAh/0
Пожалуйста, решение без рекурсии.
Или вы считаете set-based операции в оконных функциях не итеративными?
Больше не хочу тратить время на общение с вами, спасибо.
Ну неужели настолько непонятное условие, что никак не можете понять, что именно надо. С вашей входной строкой результат должен быть такой (не просто разбить, а перенести слова там, где не влезают в строку):
Это пример строки,
которая должна быть
разделена на
несколько строк
длиной до двадцати
символов
А у вас не то в результате (короткие строки, куда влезло бы ещё по слову):
Это пример
строки,
которая
должна быть
разделена на
несколько
строк длиной
до двадцати
символов
akalexus
Алексей

 Maksim
Алексей
Проверь что файл на месте или есть к нему права
Index.php? На месте права стандартные www-data: www-data
infa
Index.php? На месте права стандартные www-data: www-data
да там же написано файл сокета php8.2fpm.sock