На работе много у кого Lenovo и Huawei, работают почти без нареканий, с моей стороны вопросы к драйверам, но от модели к модели ситуация меняется почему-то.
Я вообще интересовался вот такой китайский есть chuwi mini book😁
 Сергей


 Azamat
Я вообще интересовался вот такой китайский есть chuwi mini book😁
Знакомый брал чуви, но другой модели
На винде всё ок, на убунту не встал звук и тачпад
 Robert
Я вообще интересовался вот такой китайский есть chuwi mini book😁
Надо чётче формулировать вопрос, экстрасенсы по выходным отдыхают.
Azamat
Надо чётче формулировать вопрос, экстрасенсы по выходным отдыхают.
Тогда я зайду в понедельник
Сергей
Надо чётче формулировать вопрос, экстрасенсы по выходным отдыхают.
Да я чёт не думал что леново и хуавей это Китай. Я сужу по машинам как бы
Сергей
Всё Китай, почти
Robert
Да я чёт не думал что леново и хуавей это Китай. Я сужу по машинам как бы
Есть уважаемый Китай, а есть китай.
Robert
Всё зависит от степени контроля качества комплектующих и сборки.
Яна цист
Пересоздай учётку без интернета или переустанови и пропусти момент с настройкой интернета при первом запуске.
у меня не получилось отключить интернет.....но я вспомнил свой другую учётную запись и пошло поехала короче спасибо 👍
 Ol
Читаю про хэш ключа дистрибьюции (гринплам), и не понимаю, что это такое. Это какое-то преобразование в цифры. Но зачем и как это работает?
Хеши же есть не только в субд. Если эти понятия одинаковы, то есть ли какая-то статья или ролик на Ютубе "для маленьких и тупых"?
 m700
Читаю про хэш ключа дистрибьюции (гринплам), и не понимаю, что это такое. Это какое-то преобразование в цифры. Но зачем и как это работает?
Хеши же есть не только в субд. Если эти понятия одинаковы, то есть ли какая-то статья или ролик на Ютубе "для маленьких и тупых"?
А я говорил что для маленьких и тупыхте понравится
Anna
Читаю про хэш ключа дистрибьюции (гринплам), и не понимаю, что это такое. Это какое-то преобразование в цифры. Но зачем и как это работает?
Хеши же есть не только в субд. Если эти понятия одинаковы, то есть ли какая-то статья или ролик на Ютубе "для маленьких и тупых"?
А какой вопрос-то именно? Что такое хеш? Что такое хеш-функция? Что такое дистрибуция? Что такое ключ?
В чем именно затык, можешь подробнее описать.
 Igor
Читаю про хэш ключа дистрибьюции (гринплам), и не понимаю, что это такое. Это какое-то преобразование в цифры. Но зачем и как это работает?
Хеши же есть не только в субд. Если эти понятия одинаковы, то есть ли какая-то статья или ролик на Ютубе "для маленьких и тупых"?
Мы задаем поле в таблице по значению в котором распределим данные по серверам, наша цель сделать это максимально равномерно и второе требование зная ключь должны уметь сказать где он лежит. Просто распределить по значению фигово потому что можно злоупотреблять специально или просто попачюсть на неудачные данные. Поэтому перед тем как использовать данные из ключа их хешируют.
Igor
Допустим у нас 10 серверов и поле key целочисленное, если мы распределим по серверам через key%10, то если кто то напихает ключей 10 20 30 и тд они все пойдут на один сервер, а если мы их прохешируем, то расползуться бм равномерно
Igor
Собственно в хэштаблице хеширование делается с той же целью
Igor
Хэш это один из самых простых вариантов распихать данные по бакетам "равномерно" и применяется довольно часто
 Dmitry (Inock)
 меденов азамат
Подскажите, как правильно .env передать в aws ec2 instancе ? безопасно ли будет его просто туда скопировать
Igor
Или совковых олдов))) тут хз
 Алексей
Какой же я нахер старый)))
lil kir
Где найти ментора? Или кто хочет быть моим ментором? Стек: js, ts, react
Ol
Допустим у нас 10 серверов и поле key целочисленное, если мы распределим по серверам через key%10, то если кто то напихает ключей 10 20 30 и тд они все пойдут на один сервер, а если мы их прохешируем, то расползуться бм равномерно
 Ol
А какой вопрос-то именно? Что такое хеш? Что такое хеш-функция? Что такое дистрибуция? Что такое ключ?
В чем именно затык, можешь подробнее описать.
да. в том, что такое хэш и нафига он нужен в субд
Anna
m700
по этой хуйне у меня диссер был суть в том что когда вася дает указание какие телефоны куда везти он скрытно может сообщить - тикайте сгороду нам пызда.
m700
а почему нормальное распределение?
хэши же устойчивы к лавинному эффекту, потому должно быть равномерное распределение. Или я совсем чушпан и ничо не понял?(
Anna
а почему нормальное распределение?
Там опечатка, «равномерное» конечно же имелось в виду. Нормальность тут не особо играет роли, мы хеш используем для выбора инстанса, нам плевать на нормальность в этом случае.
m700
Anna
Как раз с партишингом вопросов, наверное, нет. Я понимаю, что каждый сегмент будет разбит на партиции внутри этого самого сегмента.
Ну типа разбить айфоны и мотороллы в обоих пунктах на 2 части: старше 2000г и новые(с 2001 г)
Все равно непонятно, как идёт распределение по этим хэшам. Ну вот наглядно по значению ключа дистрибьюции - ясно. Но причем тут хэш?
К тому, что как ты сделаешь маппинг, например, IMEI телефона => 4 точки продажи
Ol
К тому, что как ты сделаешь маппинг, например, IMEI телефона => 4 точки продажи
Может, мы о разном говорим?
Есть партиции range, list. Это понятно. А есть какое-то партиционирование по хэшам💩Вот эта хрень непонятна. Потому что непонятно глобально, что такое хэш и зачем он
Anna
Может, мы о разном говорим?
Есть партиции range, list. Это понятно. А есть какое-то партиционирование по хэшам💩Вот эта хрень непонятна. Потому что непонятно глобально, что такое хэш и зачем он
Хеш нужен для того, чтобы из бесконечного множества сделать ограниченное в данном контексте. Все.
Apple => 1
Motorolla => 2
Huawei -> 3
Samsung => 2
Xiaomi => 4
…
Вот хеш - это будет 1/2/3/4. Хеш-функция - это то, что переводит твое значение в хеш.
 German
 Dart
Как можно внедрить ИИ в свой сайт?
API OpenAI подходит и LM Studio (а тут куча моделей) и к ChatGTP , это сейчас основная бибилиотека к многим нейронкам и моделям. Я успешно применяю на python.
Dmitry (Inock)
 Алексей
Может кто подскажет как спросить гугл. Мне нужно сделать в одной программе обращение к дискам и папкам и в Линукс и в Виндоус. Как это написать в одной программе если у систем слеш разные
Maksim Pozharskiy
Может кто подскажет как спросить гугл. Мне нужно сделать в одной программе обращение к дискам и папкам и в Линукс и в Виндоус. Как это написать в одной программе если у систем слеш разные
Написать две функции, определять какая ОС текущая и вызвать соответствующую функцию в условии
Алексей
Написать две функции, определять какая ОС текущая и вызвать соответствующую функцию в условии
Вариант я думал про хеддер, но смысл тот же
m700
написать хелпер который будет возвращать в нужном формате строку
 vildhjata
Dmitry (Inock)
Яна цист
 m700
Ol
Хеш нужен для того, чтобы из бесконечного множества сделать ограниченное в данном контексте. Все.
Apple => 1
Motorolla => 2
Huawei -> 3
Samsung => 2
Xiaomi => 4
…
Вот хеш - это будет 1/2/3/4. Хеш-функция - это то, что переводит твое значение в хеш.
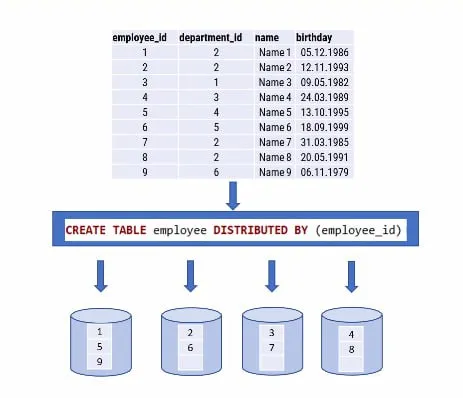
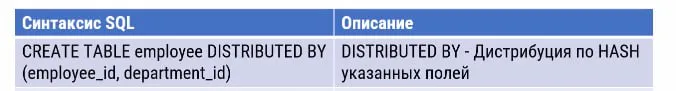
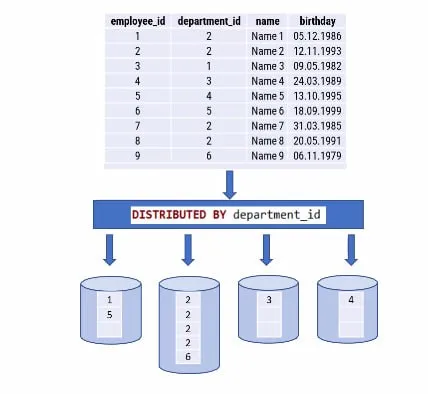
Получается, что для id_department хэши будут одинаковые, где значения 2, например. А для employee все 9 хэш значений разные и субд просто равномерно раскидывает эти хэши по сегментам во 2 случае?
Т.е. для департамента будут созданы 6 уникальных хэшей, т.к. разных id шесть, а для работников - 9 уникальных хэшей?
ЗЫ: Я понимаю, что хэш-функция - это то, что переделывает значение ключа в хэш)
Яна цист
а че
m700
ну до 18 яндекс исполняет законодательство по безопасному интернету для детей, потому оставляй его
m700
Получается, что для id_department хэши будут одинаковые, где значения 2, например. А для employee все 9 хэш значений разные и субд просто равномерно раскидывает эти хэши по сегментам во 2 случае?
Т.е. для департамента будут созданы 6 уникальных хэшей, т.к. разных id шесть, а для работников - 9 уникальных хэшей?
ЗЫ: Я понимаю, что хэш-функция - это то, что переделывает значение ключа в хэш)
есть еще термин дайджест хэш функци...это все тот же хэш
Яна цист
m700
при этом пашет команда notepad c: / boot . ini
m700
без пробелов
Anna
Получается, что для id_department хэши будут одинаковые, где значения 2, например. А для employee все 9 хэш значений разные и субд просто равномерно раскидывает эти хэши по сегментам во 2 случае?
Т.е. для департамента будут созданы 6 уникальных хэшей, т.к. разных id шесть, а для работников - 9 уникальных хэшей?
ЗЫ: Я понимаю, что хэш-функция - это то, что переделывает значение ключа в хэш)
Все так. Поэтому все записи с department_id=2 на картинке попали в один бакет.
Хорошо это или плохо - другой вопрос.
Anna
Может кто подскажет как спросить гугл. Мне нужно сделать в одной программе обращение к дискам и папкам и в Линукс и в Виндоус. Как это написать в одной программе если у систем слеш разные
Сделай слой абстракции и работай с ним. Затем две имплементации, реализующие этот слой абстракции - в зависимости от системы, которые и будут реализовывать нужное «обращение к дискам и папкам» для той или иной системы.
Сергей
Сергей
Потому что у питона есть os либа, которой пофигу на различия и она допускает разные слеши
Сергей
У плюсов тоже есть
Сергей
а тебе какой надо?
Сергей
я твой вопрос не догнал последний
Сергей
ну представлено было в 17м и что?