Котаны, есть класс, есть bool property в классе, есть метод который возвращает этот bool (больше ничего не делает, только return bool, и есть много потоков, которые вызывают этот метод. А другие потоки могут поменять значение bool через другие методы. Вопрос: нужен ли лок мутекса в этом методе?
Если только bool, то не вижу смысла заморачиваться
 Aleksander


 Constantine
 Aidar
Котаны, есть класс, есть bool property в классе, есть метод который возвращает этот bool (больше ничего не делает, только return bool, и есть много потоков, которые вызывают этот метод. А другие потоки могут поменять значение bool через другие методы. Вопрос: нужен ли лок мутекса в этом методе?
Совершенно точно нужна синхронизация
Aidar
Какая неважно
Aidar
Хотя изменение bool не обязательно атомарно
 🐙 Antony
А так можно было? :)
Нет, так нельзя: компилятор вправе делать оптимизации не атомарных переменных из рассчёта, что они не используется в других потоках. Поэтому он например может выкинуть запись в эту переменную значения к чёртовой бабушке. А еще он может закешировать значение переменной и никогда его не обновлять
🐙 Antony
* ну и разумеется санитайзеры будут ругаться на не атомарную работу с одной переменной из многих потоков
 Anatoly
Черт, как бы сделать так, чтобы сарказм не надо было пояснять :)
🐙 Antony
** ну и разумеется, всё это будет работать и без атомарных инструкций и атомиков. Но есть гарантия, что оно сломается в самый неподходящий момент
 Вячеслав
Табличка "сарказм" нужна
🐙 Antony
Черт, как бы сделать так, чтобы сарказм не надо было пояснять :)
Мне нужна табличка "ирония"
 Arseny
Вообще многие UB на практике проблемам не приводят.
До тех пор пока не приводят наконец. И тогда больно.
🐙 Antony
Если только bool, то не вижу смысла заморачиваться
atomic<bool> b;
...
b.store(true, memory_order_relaxed); // та же ассемблерная инструкция на x86 что и просто запись в неатомарную переменную, но компилятору запрещено чудить. Учтите, что memory_order_relaxed (как и запись в неатомарную переменную) не гарантирует "мгновенное" появление значения в другом потоке. Поэтому лучше писать:
b = true; // и никаких сюрпризов
Arseny
atomic<bool> b;
...
b.store(true, memory_order_relaxed); // та же ассемблерная инструкция на x86 что и просто запись в неатомарную переменную, но компилятору запрещено чудить. Учтите, что memory_order_relaxed (как и запись в неатомарную переменную) не гарантирует "мгновенное" появление значения в другом потоке. Поэтому лучше писать:
b = true; // и никаких сюрпризов
Я так и не понял откуда информация о том, что = true гарантирует "мгновенное" появление значения.
 Berkus
Я так и не понял откуда информация о том, что = true гарантирует "мгновенное" появление значения.
acquire-release барьер гарантирует это
Berkus
все что сделано до release обязательно появится в момент acquire
 Danil
Я так и не понял откуда информация о том, что = true гарантирует "мгновенное" появление значения.
потому что при просто = true будет seq_cst, а он гарантирует порядок операции, а при релаксед нет ограничений на реордеринг операции
Andrey
Вопрос был про чтение bool
Andrey
Запись под мутексом
Arseny
все что сделано до release обязательно появится в момент acquire
Если чтение увидело новое значение. Почему оно его увидит?
Andrey
Атомика нет
Andrey
Вопрос нужно ли лочить мутекс чтобы прочитать значение
Arseny
Вопрос нужно ли лочить мутекс чтобы прочитать значение
Не, мы тут свое уже обсуждаем. И да, нужно
vladislav
А в чём сложности тогда? Если нет атомика, то ты должен гарантировать корректность работы объекта класса между потоками, используя мутексы
vladislav
Да, нужно лочить мутекс
Andrey
Поглядел ассемблер с разными флагами оптимизации, там только мув. Разве мув не атомарный?
 Cuno
Читай что тебе пишут, что ли.
Cuno
atomic<bool> b;
...
b.store(true, memory_order_relaxed); // та же ассемблерная инструкция на x86 что и просто запись в неатомарную переменную, но компилятору запрещено чудить. Учтите, что memory_order_relaxed (как и запись в неатомарную переменную) не гарантирует "мгновенное" появление значения в другом потоке. Поэтому лучше писать:
b = true; // и никаких сюрпризов
Andrey
 Andrey
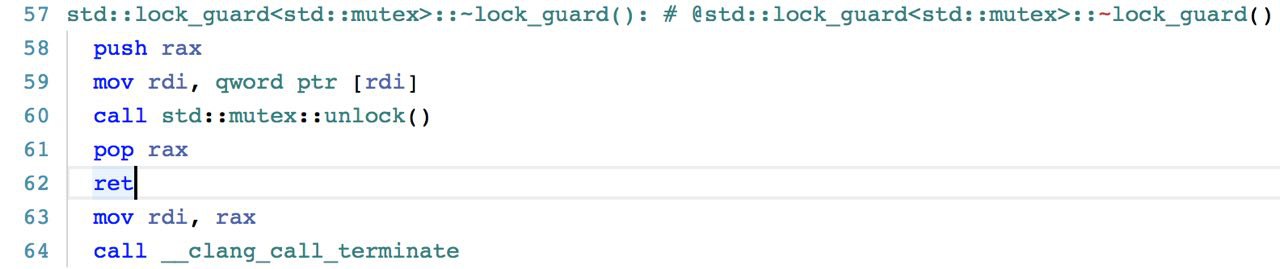
Когда строчка 63 выполнится?
Andrey
Что должно быть в rax?
Berkus
Поглядел ассемблер с разными флагами оптимизации, там только мув. Разве мув не атомарный?
мув атомарный НА ОДНОМ ЯДРЕ
Konstantin
вроде даже на одном может быть не атомарный, если адрес не выровнен
Good
Котаны, есть класс, есть bool property в классе, есть метод который возвращает этот bool (больше ничего не делает, только return bool, и есть много потоков, которые вызывают этот метод. А другие потоки могут поменять значение bool через другие методы. Вопрос: нужен ли лок мутекса в этом методе?
не нужен, если этот bool - atomic
Berkus
вроде даже на одном может быть не атомарный, если адрес не выровнен
на х86 вроде в пределах одного слова все равно атомарно, но толку то
Cuno
мув атомарный НА ОДНОМ ЯДРЕ
Разве? Если одно ядро сделает mov dword ptr [addr], 1, затем другое mov eax, [addr] то разве может быть не 1 в rax?
Good
в пределах правильно выровненного слова
Berkus
Разве? Если одно ядро сделает mov dword ptr [addr], 1, затем другое mov eax, [addr] то разве может быть не 1 в rax?
да, может, у ядер есть несколько кешей, и в память оно попадет не сразу
Cuno
да, может, у ядер есть несколько кешей, и в память оно попадет не сразу
Про кеши я в курсе, но разве кэшлинии не инвалидируются при записи?
Berkus
Про кеши я в курсе, но разве кэшлинии не инвалидируются при записи?
на одном ядре могут, между ядрами надо чтобы отработал MESI
Good
да даже если кеши отключены, чтение может зареордериться перед записью
Berkus
да даже если кеши отключены, чтение может зареордериться перед записью
мы про случай двух независмых ядер говорим, ну то есть понятно что они совершенно независимо могут заордериться как угодно, но даже если кор2 читает после записи из кор1, данные могут еще не обновиться
Good
я немного про другое, это единственный реордеринг, возможный на х86, так что даже без кешей может сработать не так, как хотелось
Good
по идее, даже на одном цпу
Arseny
Кроме барьеров процессора ещё есть барьеры компилятора. И даже если процессор гарантирует release aquire семантику, без атомиков компилятор может все переставить и испортить
Arseny
Aliaksei
atomic<bool> b;
...
b.store(true, memory_order_relaxed); // та же ассемблерная инструкция на x86 что и просто запись в неатомарную переменную, но компилятору запрещено чудить. Учтите, что memory_order_relaxed (как и запись в неатомарную переменную) не гарантирует "мгновенное" появление значения в другом потоке. Поэтому лучше писать:
b = true; // и никаких сюрпризов
https://stackoverflow.com/questions/14846494/does-seq-cst-ordering-guarentee-immediate-visibility
Cuno
я немного про другое, это единственный реордеринг, возможный на х86, так что даже без кешей может сработать не так, как хотелось
Loads may be reordered with older stores to different locations but not with older
stores to the same location.
http://www.cs.cmu.edu/~410-f10/doc/Intel_Reordering_318147.pdf
Good
да, но что значит "same"? Если мы поиграемся с меппингом и получим два разных виртуальных адреса, указывающих на один физический, то что будет? Поэтому я и написал "по идее"
Cuno
на одном ядре могут, между ядрами надо чтобы отработал MESI
https://godbolt.org/g/Q1xuAE
Почему тут тогда никаких locked инструкций не нагенерилось?
Good
Потому что запись в память на х86_64 имеет release семантику
Cuno
Потому что запись в память на х86_64 имеет release семантику
memory_order_release -> All writes in the current thread are visible in other threads that acquire the same atomic variable
Так гарантированно 1 или нет?
Cuno
Разве? Если одно ядро сделает mov dword ptr [addr], 1, затем другое mov eax, [addr] то разве может быть не 1 в rax?
Good
хмм, данный вопрос не имеет особого смысла, ибо на одной переменной не показать реордеринг. Проще говоря, может быть и так и так, и подобной гарантии дать нельзя (в мультипроцессорной системе)
Cuno
Противоречиво
Good
В самом деле, если мы физически прочитали раньше, то мы должны прочитать 0, так? А как отличить в программе, почему мы прочитали 0 - из-за процессоров, подсистемы памяти или потому что тупо прочитали раньше (до записи)?
Good
Но, если эта единичка - флаг, который сигнализирует о готовности других данных, например, тогда другое дело
Good
Но тогда надо ввести как минимум еще одну переменную (те самые данны). Поэтому в интеловском мануале все примеры, как минимум, с двумя вариаблами
Cuno
В самом деле, если мы физически прочитали раньше, то мы должны прочитать 0, так? А как отличить в программе, почему мы прочитали 0 - из-за процессоров, подсистемы памяти или потому что тупо прочитали раньше (до записи)?
В моем вопросе условия строгие. Понятно дело, что проверить это крайне сложно.
Cuno
запись происходит строго раньше, чем чтение
Good
Это проверить невозможно, значит, программа на это полагаться не должна
Cuno
ААААААА
Cuno
на гарантии стандарта полагаться нельзя?
Berkus
на гарантии стандарта полагаться нельзя?
два треда не гарантируют тебе в какой последовательности будут выполняться команды в этих двух тредах
Berkus
причем тут стандарт?
Good
стандарт говорит про предыдущие и последующие записи-чтения, т.е. см выше про 2 и более переменные
Cuno
два треда не гарантируют тебе в какой последовательности будут выполняться команды в этих двух тредах
Стандарт тут при том, что memory_order_release требует, чтобы запись была "видна" из другого треда (ядра). Я задал один простой вопрос: если ядро 1 записало по адресу 0xFFFF единичку, ЗАТЕМ ядро2 по этому адресу прочитает, то прочитает ли оно единичку? Ты утверждаешь, что не факт - из за кешей. clang тем временем генерирует код без locked инструкций.
Good
предыдущие записи были видны, когда будет видна эта запись
Good
а тут нет предыдущих, поэтому неважно, что мы прочтем - все и так и так ок будет
Good
Правильно будет так: https://godbolt.org/g/r9zuxz
Good
Тут тоже ничего такого нет, ибо х86 довольно strong-ordered, а вот если мы глянем на ppc (https://godbolt.org/g/9YpkiL), то увидим lwsync при сохранении (для порядка данных) и isync при загрузке (для порядка инструкций)
 Matwey
Ой, это же гудя
Matwey
@godstuff