Это была бага, они зачем то свой конфиг к scheduler приложили и он протух
Хаа) Уже исправили?
 Denis


 Дмитрий
а у кого-нибудь было такое, что в ранчере нельзя войти в определенный под. С ним что-то непонятное происходит. Пытаюсь из gui сделать execute shell, а окно открывается и сразу же закрывается
 Misha
вопрос любителям Helm
Misha
как в хелпере можно сгенерить строку из YAML-списка в values?
Misha
такая штука не работает
Misha
{{- define "head-ingress.healthcheck.codes" -}}
{{- range .Values.healthcheck.successCodes -}}
{{- $noop := printf . | append $.codes | set $ "codes" -}}
{{- end -}}
{{- join "," $.codes -}}
{{- end -}}
 bebebe
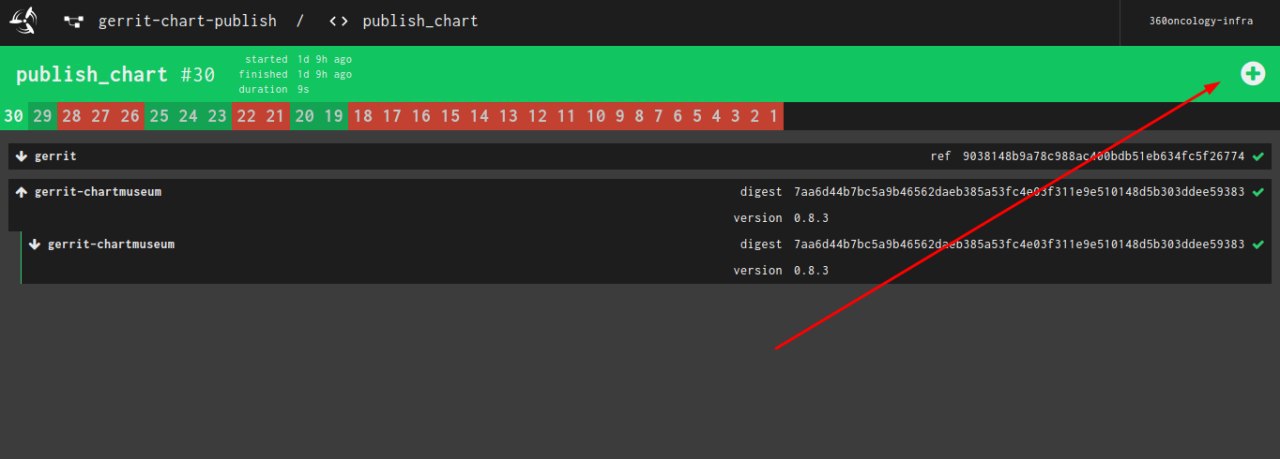
Когда concourse научится перезапускать пайплайн без фейковых комитов, можно посмотреть :)
ээээ разверните эту мысль. его можно тригернуть руками через мордочку, либо через fly
Dmitriy
Привет
Может у кого такой проект
Лагом под кубернетисом
----
Микросерисы со стейт акторами должны формировать кластер
Для этого нужно подам дать адреса сидов(вот не знаю может стейтфул сет 3 сиды под каждый такой микросервис делать)
Или может вообще весь деплой микросервиса через стейтфул сет?
Спасибо
G72K
ээээ разверните эту мысль. его можно тригернуть руками через мордочку, либо через fly
Весь пайплайн? Так чтобы один и тот же непоследний коммит через все джобы прошел?
G72K
Привет
Может у кого такой проект
Лагом под кубернетисом
----
Микросерисы со стейт акторами должны формировать кластер
Для этого нужно подам дать адреса сидов(вот не знаю может стейтфул сет 3 сиды под каждый такой микросервис делать)
Или может вообще весь деплой микросервиса через стейтфул сет?
Спасибо
А сиды чем особенные? Только известным именем или у них конфиг особый?
Dmitriy
А сиды чем особенные? Только известным именем или у них конфиг особый?
сиды это прикол акки lagomframework Cluster
именами особенные, конфигами не обязательно
решил сделать через стейтфул сеты тогда со своего стейтфул сета смогу передать свои имена
G72K
сиды это прикол акки lagomframework Cluster
именами особенные, конфигами не обязательно
решил сделать через стейтфул сеты тогда со своего стейтфул сета смогу передать свои имена
Там Akka cluster под капотом? Вот тут примеры https://developer.lightbend.com/docs/akka-management/current/bootstrap/recipes.html
Dmitriy
Там Akka cluster под капотом? Вот тут примеры https://developer.lightbend.com/docs/akka-management/current/bootstrap/recipes.html
Спасибо огромное
Попробую сделать
как мне нравилось когда можно было сказать "не знаю у меня локально все работает"
реально тяжко без ошпаренного девопса(такого чтоб и sbt правил)
у меня почему-то сто думает что можно без фул тайм крутого девопса в амазоне все развернуть 🙂
экономия
G72K
Спасибо огромное
Попробую сделать
как мне нравилось когда можно было сказать "не знаю у меня локально все работает"
реально тяжко без ошпаренного девопса(такого чтоб и sbt правил)
у меня почему-то сто думает что можно без фул тайм крутого девопса в амазоне все развернуть 🙂
экономия
Ну и зачем жопу рвать доказывая что он прав? Разве что ради саморазвития, но тогда причем тут СТО ? :)
bebebe
Весь пайплайн? Так чтобы один и тот же непоследний коммит через все джобы прошел?
я вас совсем перестал понимать
Dmitriy
Ну и зачем жопу рвать доказывая что он прав? Разве что ради саморазвития, но тогда причем тут СТО ? :)
Девопс работа реально интересная(когда получается)
Вот в амазон я не полезу, это своя професия
на гугле поднимаю, и нашего парт тайм девопса ждет
"не знаю вот у меня все работает на гугл клауде с кубернетисом , что там х....вертите на амазоне что не работает не знаю"
Метрики нужно было 30к в секунду получить
одна нода кассандры(датастаксовской) дает 10к, при ссд диске к ноде
так вот в амазоне бля тестили с какой-то фигней хелло ворлда где то памяти не хватало то вообще все нафиг дохло
вот приходится доказывать что хоть код рабочий
--
а вообще просто интересно
деву любая девопс работа в раздел достижений в резюме летит 🙂
G72K
Ну в техническом споре с коллегами, а тем более с руководством выйти победителем это благородная цель
 bebebe
вероятно я все же не понимаю, ипользую concourse 4
 Rainbow
kubeless кто-то пользуется? Как там решается zero downtime и "не собирать, если не поменялся код"?
bebebe
при нажатии этой кнопки, джоба повторяется с теми же ресурсами что и была запущена в "последнем прогоне"
bebebe
@rossmohax так, я осознал проблему
Rainbow
kubeless кто-то пользуется? Как там решается zero downtime и "не собирать, если не поменялся код"?
kubeless function update hello --from-file test.py
zerodowntime и "не собирается, если не поменялось (по sha256)"
D
ребята, кто может поделиться опытом как интегрировать гитлаб с кубером?
D
застрял на кнопку Install Helm Tiller
D
выдает неинформативные сообщения, аля “Kubernetes error.”
D
уже сны вижу с этими нодами)
D
насколько плохо деплоить образы в кластер напрямую через gitlab runner?
D
абсолютно нормально)
))) здорово, потому что я устал дебажить проблему интеграции с гитлабом, скудное количество инцидентов что-ли или кубер так быстро развивается, что гитлаб не поспевает синхронизироваться
D
я думаю через docker registry правильнее
да, вы правы, деплоить из докер реджистри, но запуск команды будет происходить из гитлаб раннера
 Alexandr ∨∧‾
ну да, правильно, нужно же команду послать
D
ну спасибо ребят, успокоили)
 Andrey
ну если это можно так назвать 😄
D
то есть ставить его в гитлаб раннер и деплоить через него?
Alexander N.
Подскажите - можно ли ингрессу подсунуть регулярку для server name?
Alexander N.
есть куча поддоменов отличающихся парой-тройкой букв
Alexander N.
писать 80+ алиасов совсем дико как-то
Alexander N.
на обычном nginx это делается без проблем, а вот на ингрессе непонятно
 Sergei
Я в своё время пофейлился с регулярками и ингрессом. Пришлось делать кастомный шаблон конфига
Дмитрий
насколько плохо деплоить образы в кластер напрямую через gitlab runner?
А как ты делал иначе?
Alexander N.
Я в своё время пофейлился с регулярками и ингрессом. Пришлось делать кастомный шаблон конфига
вроде как traefik умеет это делать, но хотелось бы избежать этого
Artem
доброе утро! я правильно понимаю, что в случае с nbd невозможно "заказать" нарезать новое блочное устройство? т.е. в качестве бэкенда для pvc с динамическим выделением ресурсов не подходит?
 Alexander
Как правильно делать, у меня кластер 3 мастера и 5 воркеров,на воркерах крутится веб прилодение. Где размещать правильно ингресс нджинкса, на каждом воркере или на мастерах? Нужно ли вообще чтото на мастерах ставить или не стоит?
 Artem
по хорошему надо выделить 1+ воркер для ингресса, поставить на него метку, что-то типа role=ingress и запускать ингресс там
Alexander
по хорошему надо выделить 1+ воркер для ингресса, поставить на него метку, что-то типа role=ingress и запускать ингресс там
Тогда входная точка в приложение будет всего один воркер?
Artem
не менее 1
Artem
у нас 2
Artem
т.е. пролейблить несколько нод
Artem
ну и ингресс контроллер запускать демонсетом
Alexander
А если нода перестала существовать то на оьорудовании выше которое смотрит на адрес воркера тоже надо будет производить изменения?
Artem
да
Alexander
Разве это правильно? В том плане что мастера их адреса и колво в основном стаичны, не выгодней ли разместить там?
Alexander
В чем профит от размещения на 1+ ноде а не на всех?
Artem
в том, что нет опасности заафектить ингресс каким-нибудь сломанным подом, который ноду положит
Artem
можно и так,
Artem
up to you
Alexander
 𝚔𝚟𝚊𝚙𝚜
доброе утро! я правильно понимаю, что в случае с nbd невозможно "заказать" нарезать новое блочное устройство? т.е. в качестве бэкенда для pvc с динамическим выделением ресурсов не подходит?
Привет, nbd - это просто протокол доставки блочного устройства, очень простой и не очень надежный. И насколько мне известно kubernetes не поддерживает его из коробки. Имхо iscsi - намного стабильнее.
𝚔𝚟𝚊𝚙𝚜
Как в случае и с iscsi экспортируемое устройство должно быть уже создано на сервере.
Artem
В чем профит от размещения на 1+ ноде а не на всех?
У нас на этих нодах только ингресс, ну и filebeat с prometheus-node-exporter для логирования и мониторинга
Alexander
Artem
нет, про ноды с role=ingress
Artem
@kvaps но спомощью кастомного CSI можно их создавать получается
D
что я делаю не так, я создал деплоймент, создал сервис и теперь пытаюсь стучаться по NodePort и порту на этот сервис, но в браузере site cannot be reached
D
кластер через kubespray развернул
Artem
А у вас прямая видимость этого хоста есть?
Artem
Посмотрите на хосте вывод netstat -antp | grep LIST
Roman
всем привет
Roman
пытаюсь прикрутить цеф к кубу, имею следующую проблему:
kubectl get pvc -n kubecloud
NAME STATUS VOLUME CAPACITY ACCESS MODES STORAGECLASS AGE
claim Pending fast 4m
kubectl describe pvc -n kubecloud
Name: claim
Namespace: kubecloud
StorageClass: fast
Status: Pending
Events:
Type Reason Age From Message
---- ------ ---- ---- -------
Warning ProvisioningFailed 8s (x20 over 4m) persistentvolume-controller Failed to provision volume with StorageClass "fast": failed to create rbd image: executable file not found in $PATH, command output:
Roman
подскажите как посмотреть подробные логи, что не получается у него?
 Alexander
потому что в дефолтном kube-controller нету бинарника
Roman
можно подробней? я не понял, что где посмотреть?
 Andrey
ceph-common стоит на нодах?
Roman
да 12.2.8-1~bpo90+1