 Rainbow


(это вдруг кому интересно самое простое решение)
 Igor
oauth2_proxy так и работает
но там можно ограничивать только участникам команды в github org
Igor
думаю можно через это реализовать роли
Igor
но подумать прийдется как это сделать
 Константин
под капотом используем вот эту штуку https://github.com/bitly/oauth2_proxy
крутяк, спасибо за ссылку
Rainbow
тут нужно, чтобы прокси на каждый url спрашивал "а сюда можно?". У auth_request проблема, что это только 1 запрос первый раз.
Rainbow
Сейчас думаю может через это
auth_request_set $переменная значение;
передавать X-User-Role
его из вне нельзя переопределить, а в самом приложении if (role !== 'admin') и тп.
А вообще решал кто-то проблему авторизацию по микросервисам централизованно?
Rainbow
Есть https://nginx.ru/ru/docs/http/ngx_http_auth_jwt_module.html
Но форму авторизации некому выдавать.
Igor
тут нужно, чтобы прокси на каждый url спрашивал "а сюда можно?". У auth_request проблема, что это только 1 запрос первый раз.
сомневаюсь что это так работает.
На каждый запрос отправляется подзапрос по auth_request
Там смотрят на cookie аутентификационную и прнимают решение.
членство в группе прийдется запрашивать и\или кешировать
 Andor
Сейчас думаю может через это
auth_request_set $переменная значение;
передавать X-User-Role
его из вне нельзя переопределить, а в самом приложении if (role !== 'admin') и тп.
А вообще решал кто-то проблему авторизацию по микросервисам централизованно?
У Яндекса был доклад про быструю межсервисную авторизацию
Igor
из документации aut_request
The module may be combined with other access modules, such as ngx_http_access_module, ngx_http_auth_basic_module, and ngx_http_auth_jwt_module, via the satisfy directive.
Igor
Before version 1.7.3, responses to authorization subrequests could not be cached (using proxy_cache, proxy_store, etc.).
Igor
так что на каждый запрос отправляется подзапрос - сюда можно?
 Denis
А как сертификатиками в кубере управлять, с учётом того что у нас nginx ingress ?
Хочется подцепить letsencrypt и чтобы оно само всё двигалось
Rainbow
cert manager
Denis
kube-lego пишет что они unsupported
Rainbow
https://cert-manager.readthedocs.io/en/latest/
Igor
мы до сих пор на kube-lego
Igor
как нибуть на cert-manager переедем
 Denis
есть эксперты helm? 🙂
два вопроса:
1. Как вы чистите (и чистите ли вообще) конфигмапы релизов, если он разростается - хелм начинает подтормаживать.
2. Как деплоите большое кол-во подов разом, он сильно просаживается по производительности (особенно если имеется configmap-mount в деплойке)
большое кол-во - от 100 и выше.
все что до 100 он вроде как прожевывает более-менее.
 Andrey
есть эксперты helm? 🙂
два вопроса:
1. Как вы чистите (и чистите ли вообще) конфигмапы релизов, если он разростается - хелм начинает подтормаживать.
2. Как деплоите большое кол-во подов разом, он сильно просаживается по производительности (особенно если имеется configmap-mount в деплойке)
большое кол-во - от 100 и выше.
все что до 100 он вроде как прожевывает более-менее.
helm init --history-max 5
Не было никаких проблем производительностью, столько и деплоим.
Denis
о, про историю не знал, спасибо!
Andrey
Что с производительностью, собираете метрики с tiller пода? По CPU в лимит упирается или OOM летят постоянные? С какими параметрами запускаете helm?
Denis
Что с производительностью, собираете метрики с tiller пода? По CPU в лимит упирается или OOM летят постоянные? С какими параметрами запускаете helm?
у нас тиллер лимитирован (но не убивается), просто деплой очень долго проходит.
Denis
стандартный helm upgrade --install ...
Denis
но мы грешим на большое кол-во конфигмапов который маунтятся в каждый под
Denis
потому что когда прилетает не мало на 1 ноду - кубелет еле пережевывает все
Denis
и куча ошибок типа du ... в kubelet
Andrey
Это да, kubelet не самый быстрый, если очень много подов на ноду.
Andrey
Из практики лучше больше сотни подов не деплоить на одну машину.
Denis
ага, у нас просто изначально несовсем правильно сделано - жирные тачки и их не много
Andrey
Что с CPU лимитами, что по графикам соотношение container_cpu_cfs_throttled_periods_total к container_cpu_cfs_periods_total? Как себя чувствует etcd и apiserver?
Denis
задрали для кубелета ресурсы и пока живем
Denis
> Как себя чувствует etcd и apiserver
etcd увеличивается на запись/чтение, на api cpu растет
Andrey
Надо всё мониторить, тюнить, скейлить вертикально и т.д.
У нас в самом Helm не было проблем с производительностью никогда. Только окружение лагало.
 Sergey
Andrey
>с производительностью
А с самим Helm'ом проблем хоть отбавляй.
 Pavel G
А какой распределённый fs проще всего стартануть и поддерживать? Исторически обхожу это давно через отдельные базы + s3/minio.
Longhorn от ранчер если автоматом
Zfs если секса мало)
GlusterFS - мы уже 6-7 лет в мелком продакшен используем
 Sergei
Господа, стоит ли смотреть на ALB-ingress-controller?
Sergei
или забить и использовать нджинкс исключительно?
 Валентин
ага, у нас просто изначально несовсем правильно сделано - жирные тачки и их не много
Железные тачки? Может тогда на них виртуалки? У меня двухпроцессорные железки - пока по 2 виртуалки на сервак сделал (и "прибил" каждую к совему процу). Очень удобно виртуалки через ovirt разрулить - быстро поднять все и надежный
 Andrey
Longhorn от ранчер если автоматом
Zfs если секса мало)
GlusterFS - мы уже 6-7 лет в мелком продакшен используем
Gluster в кубер подключается через прослойку - heketi
и у этой прослойки нет обратной синхронизации, она знает о GlusterFS только то что ей сказал кубер, очень возможен рассинхрон - поэтому в свое время отказались
Denis
Железные тачки? Может тогда на них виртуалки? У меня двухпроцессорные железки - пока по 2 виртуалки на сервак сделал (и "прибил" каждую к совему процу). Очень удобно виртуалки через ovirt разрулить - быстро поднять все и надежный
у нас разные окружения в зависимости от важности на разных виртуализациях) пока что самый ок - это железка
Denis
если нужна надежность
Rainbow
железку сложнее скопировать на соседний серв (у меня все на железе, это я так)
 Vladimir
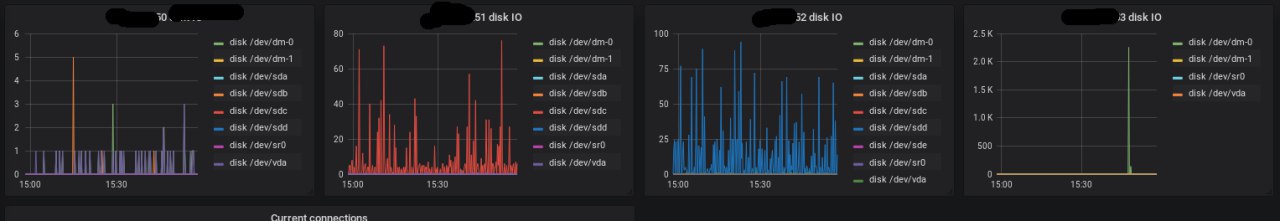
на днях наблюдал diskpressure на ноде, при этом места/инодов полно и ио почти на нуле.. через минут 15 статус поменялся на "все норм".. как такое подебажить?
Валентин
в основном на kvm
Какие? Можно в личку, реально интересно. У меня нагрузка не очень высокая пока, может потому проблем не встречал
Rainbow
Мы ранее говорили про авторизацию на микросервисы, это же умеет https://konghq.com/kong-community-edition/
Тут пару раз проскакивало. Есть у кого опыт?
 Gleb
мне как-то не очень нравится, что мой сервис при билде выплевывает 2 артефакта - хелм чарт и контейнер
Gleb
кто как с этим живет?
Rainbow
что значит выплевывает контейнер? docker push же
Gleb
ну, результатом билда моего сервиса является контейнер (в репозитории) и хелм чарт, получается
Gleb
обновлённый
Rainbow
контейнер или image?
Gleb
image, простите
Rainbow
и прям image в репу git? или вы про registry?
Gleb
про реджистри, да
Gleb
и хелм чарт тоже в реджистри должен пушиться
Rainbow
я бы не называл это артефактом. Это больше собрали коробку и отправили по почте.
Чем коробка, которая стоит под боком и все берут оттуда что нужно (это артефакты в моём понимании).
Rainbow
грубо говоря у gitlab артефакты удаляются через месяц по-умолчанию. С image так нельзя совсем.
Pavel G
Gluster в кубер подключается через прослойку - heketi
и у этой прослойки нет обратной синхронизации, она знает о GlusterFS только то что ей сказал кубер, очень возможен рассинхрон - поэтому в свое время отказались
Я не про гластер внутри куба. Гластер снаружи, к нему по multi mount nfs можно подключаться.
А внутри куба или стейтлесс или прямой МАП нфс по ключу из докеров.
(Мы правда не из куба в проде.
Виртуалки голые и докеры голые)
Pavel G
Anton
на днях наблюдал diskpressure на ноде, при этом места/инодов полно и ио почти на нуле.. через минут 15 статус поменялся на "все норм".. как такое подебажить?
--v поболее. я так нашел что у меня один маленький раздел оказалось забивался
 bebebe
Мы ранее говорили про авторизацию на микросервисы, это же умеет https://konghq.com/kong-community-edition/
Тут пару раз проскакивало. Есть у кого опыт?
хехе, год назад была идея сделать PoC на openresty + etcd как api gateway для k8s
bebebe
а у ребят получилось
 Vladimir
подскажите как в prometheus писать query? что-то недоходит
Vladimir
есть node_exporter, хочу брать node_disk_io_now а оттуда instance:"10.3.3.21:9100"
 PsyDebug
есть node_exporter, хочу брать node_disk_io_now а оттуда instance:"10.3.3.21:9100"
node_disk_io_now{instance="10.3.3.21:9100"}
Vladimir
 Vladimir
графики "клонированы" настройки графиков идентичны, скорее всего на ноде надо смотреть, но незнаю что и где
Andor
а что с ним не так?
Andrey
Покажи PromQL для какого-нибудь графика.
Vitaliy
уважаемые. есть спецы в ipvs?
проблема:
трахаюсь с k8s и в новой версии они внедрили ipvs, но оно не работает и я не понимаю что не так.
1) после ребута ноды (kebelet не включен) я делаю руками: ipvsadm -A bla bla, ipvsadm -a ..... с "Masq" и тд и с моей точки зрения все работает. vip есть, ipvsadm -ln показывает ожидаемую конфигурацию, всякие телнеты и тп прокидывают на нужный адрес:порт
2) включаю kubelet, через него kube-proxy начинает настраивать сеть... ipvsadm -ln опять показывает ожидаемую конфигурацию, а в плане того что я сам руками делал - вообще 1 в 1 матч. но с этого момента vip уже не работает. и до ребута я не могу его завести.
это не связано с iptables/ebtables, все очищал. везде accept policy
Куда копать, что проверить?
Vitaliy
вот дамп ipvsadm -Sn
-A -t 10.96.0.1:443 -s rr
-a -t 10.96.0.1:443 -r 192.168.6.161:6443 -m -w 1
-a -t 10.96.0.1:443 -r 192.168.6.162:6443 -m -w 1
-a -t 10.96.0.1:443 -r 192.168.6.163:6443 -m -w 1
в случаях когда работает и когда не работает оно совпадает.
Vladimir
уважаемые. есть спецы в ipvs?
проблема:
трахаюсь с k8s и в новой версии они внедрили ipvs, но оно не работает и я не понимаю что не так.
1) после ребута ноды (kebelet не включен) я делаю руками: ipvsadm -A bla bla, ipvsadm -a ..... с "Masq" и тд и с моей точки зрения все работает. vip есть, ipvsadm -ln показывает ожидаемую конфигурацию, всякие телнеты и тп прокидывают на нужный адрес:порт
2) включаю kubelet, через него kube-proxy начинает настраивать сеть... ipvsadm -ln опять показывает ожидаемую конфигурацию, а в плане того что я сам руками делал - вообще 1 в 1 матч. но с этого момента vip уже не работает. и до ребута я не могу его завести.
это не связано с iptables/ebtables, все очищал. везде accept policy
Куда копать, что проверить?
очень интересно, а как вообще управлять iptables на ноде? кубернетес же своих правил имеет много, как оно все коррелирует?
Vitaliy
вообще не понял вопроса
Vladimir
уважаемые. есть спецы в ipvs?
проблема:
трахаюсь с k8s и в новой версии они внедрили ipvs, но оно не работает и я не понимаю что не так.
1) после ребута ноды (kebelet не включен) я делаю руками: ipvsadm -A bla bla, ipvsadm -a ..... с "Masq" и тд и с моей точки зрения все работает. vip есть, ipvsadm -ln показывает ожидаемую конфигурацию, всякие телнеты и тп прокидывают на нужный адрес:порт
2) включаю kubelet, через него kube-proxy начинает настраивать сеть... ipvsadm -ln опять показывает ожидаемую конфигурацию, а в плане того что я сам руками делал - вообще 1 в 1 матч. но с этого момента vip уже не работает. и до ребута я не могу его завести.
это не связано с iptables/ebtables, все очищал. везде accept policy
Куда копать, что проверить?
я прочитал, что ipvs работает на уровне ядра, и поэтому оно работать должно быстрее, модули ядра установлены?