 M


sa?
 George
Да, сервисную учетку
 Lucky SB
Всем привет
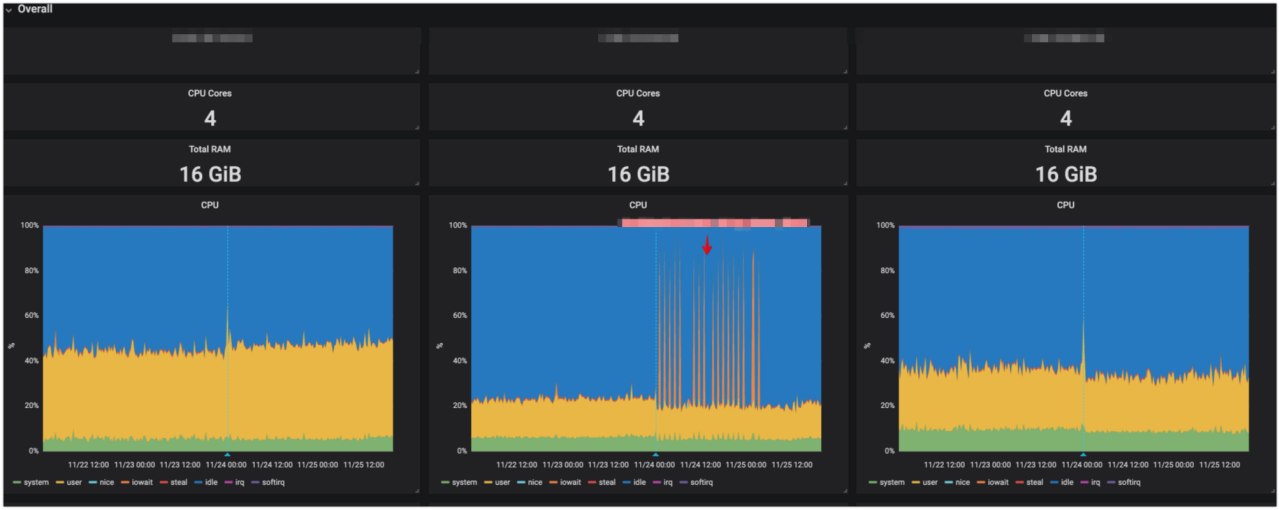
Я постарался оформить все что смог нарыть в ходе своего исследования по CPU ресурсам в Kubernetes в пост, чтобы люди которые будут в поисках знаний могли немного меньше страдать
Буду рад всем замечаниям!
https://medium.com/targetprocess/настройка-потребления-cpu-в-kubernetes-как-научить-микросервисы-дышать-полной-грудью-45f70d3f262
А можешь поделится тестовым стендом ?
Манифестами для деплоя stress-2 и tokens. дашбордами для графаны ?
Хотелось бы посмотреть как оно все под ванильным ядром centos7 и под ядрами от elrepo. будет ли разница
 G72K
Троттлинг - неизбежность при выборе пропускной способности в классическом трейдоффе throughput-latency. Если задача требует низкой latency, то можно выставить лимиты по пикам+запас, чтобы обслуживать пиковые нагрузки максимально быстро (но при этом, разумеется, отказаться от более-менее полной утилизации ресурсов из-за необхохимости держать резерв).
А можно не выставлять лимиты и получить и хорошую утилизацию и задержки
Lucky SB
А можно не выставлять лимиты и получить и хорошую утилизацию и задержки
а вот тут, кстати у меня есть непонимание.
если cpu.requests преобразуется в cpu.shares, а планировщик куба еще и следит за тем, чтобы общие реквесты не были больше количества cpu узла....
т.е. если на узле 4 cpu, и туда распределены поды с 500mcpu и 1000mcpu.
то на первый под будет отдатно 1.3 cpu, а на второй остальное 2.7 cpu
вопрос. если первому процессу планировщик больше 1.3cpu не даст, то как этот процесс может стать "взбесившимся" и выжрать все ядра ?
Lucky SB
@valioozz
Однако при отключении квот полностью теряется контроль над тем, чтобы один “взбесившийся” процесс не влиял на соседние процессы, ноду или кластер целиком. Не стоит недооценивать такую возможность: мы сталкивались с этим на нескольких кластерах, и в каждом находился новый желающий “отличиться”.
G72K
psp это ограничение на уровне API. То есть от имени какой учётки обращаешься в Api куба, на неё и действуют ограничения. То что ты прописал serviceAccountName в деплойменте, лишь означает, что в поды будет монтироваться токен от этой SA, а не от default SA. Это нужно, если у тебя приложение общается с API куба, а для других случаев это лучше совсем запретить.
В твоём случае у тебя просто половина деплойментов создавались от одной учётки SA, а другая половина от имени другой учётки SA. И к ним применяются разные psp
По SA ограничивается нормально : When a PodSecurityPolicy resource is created, it does nothing. In order to use it, the requesting user or target pod’s service account must be authorized to use the policy, by allowing the use verb on the policy.
G72K
а вот тут, кстати у меня есть непонимание.
если cpu.requests преобразуется в cpu.shares, а планировщик куба еще и следит за тем, чтобы общие реквесты не были больше количества cpu узла....
т.е. если на узле 4 cpu, и туда распределены поды с 500mcpu и 1000mcpu.
то на первый под будет отдатно 1.3 cpu, а на второй остальное 2.7 cpu
вопрос. если первому процессу планировщик больше 1.3cpu не даст, то как этот процесс может стать "взбесившимся" и выжрать все ядра ?
Он взбешивается и жрет то, до чего может дотянуться - всякие низкоприоритетные поды вроде логеров, куб прокси и проч
 Dmitry
По SA ограничивается нормально : When a PodSecurityPolicy resource is created, it does nothing. In order to use it, the requesting user or target pod’s service account must be authorized to use the policy, by allowing the use verb on the policy.
Так я этого и не отрицал. Я говорил о том, что psp прикрепляется к конкретному SA. И от него нужно деплоить.
Если ты psp прикрепишь к одному SA, а будешь деплоить от админского, psp не будут применены к твоему деплойменту
Lucky SB
Он взбешивается и жрет то, до чего может дотянуться - всякие низкоприоритетные поды вроде логеров, куб прокси и проч
https://kubernetes.io/docs/tasks/administer-cluster/reserve-compute-resources/
а вот эти резервы не помогут разве в этом случае ?
G72K
Так я этого и не отрицал. Я говорил о том, что psp прикрепляется к конкретному SA. И от него нужно деплоить.
Если ты psp прикрепишь к одному SA, а будешь деплоить от админского, psp не будут применены к твоему деплойменту
Нет, от кого деплгить вообще не важно , именно SA пода который создаётся, о том и цитата
G72K
https://kubernetes.io/docs/tasks/administer-cluster/reserve-compute-resources/
а вот эти резервы не помогут разве в этом случае ?
Помогут, но это про ресурсы на ноде. В кластере есть другие поды на которые никто нормально реквесты не повесил , вот они и умирают
 Max
Какие есть варианты создать под без yml файла через kubectl? кроме как с ключом --restart=Never ?
Cholovik
А можешь поделится тестовым стендом ?
Манифестами для деплоя stress-2 и tokens. дашбордами для графаны ?
Хотелось бы посмотреть как оно все под ванильным ядром centos7 и под ядрами от elrepo. будет ли разница
Tokens не поделюсь к сожалению
А stress это обычный stress, запускал просто:
kubectl run stress-2 --image=progrium/stress --limits=cpu=1 --requests=cpu=100m -- --cpu 2 --io 4 --vm 1 --vm-bytes 200M --timeout 10m --vm-hang 0
Lucky SB
Cholovik
а вот тут, кстати у меня есть непонимание.
если cpu.requests преобразуется в cpu.shares, а планировщик куба еще и следит за тем, чтобы общие реквесты не были больше количества cpu узла....
т.е. если на узле 4 cpu, и туда распределены поды с 500mcpu и 1000mcpu.
то на первый под будет отдатно 1.3 cpu, а на второй остальное 2.7 cpu
вопрос. если первому процессу планировщик больше 1.3cpu не даст, то как этот процесс может стать "взбесившимся" и выжрать все ядра ?
CPU shares не предоставляет механизм жесткого огранчиения
Они гарантируют что при конкуренции cgroup получит минимум столько сколько указано в относительном значении CPU shares
Если процесс решит выжрать все 4 ядра (а так как лимита нет то он вполне может это сделать) В то время как другие процессы простаивали (нагрузка же не равномерная) то он это сделает, а это может влиять на
Lucky SB
CPU shares не предоставляет механизм жесткого огранчиения
Они гарантируют что при конкуренции cgroup получит минимум столько сколько указано в относительном значении CPU shares
Если процесс решит выжрать все 4 ядра (а так как лимита нет то он вполне может это сделать) В то время как другие процессы простаивали (нагрузка же не равномерная) то он это сделает, а это может влиять на
ну вот как раз эта магия непонята. что значит "решит выжрать" ?
вот же ты пишешь:
Если мы запустим еще 2 контейнера с теми же cpu.shares = 1024, то каждый получит возможность потреблять уже только по 25% от каждого ядра.
George
Cholovik
Я это понимаю так:
Если система нагружна полностью то шары тут работают как в теории (вроде тут уже где-то всплывало замечание что если есть хоть немного свободных ресурсов то можно на софт ограничения предоставляемые шарамы них обращаться внимания)
А если есть свободные ресурсы, то любой процесс может потребить их, т.к. нет конкуренции
Cholovik
 George
Там есть блок команд для beginner
Cholovik
Вот тут обсуждали еще может более логичное объяснение
Cholovik
Реевесты - это в первую очередь количество ресурсов для аллокатора. На хостах из него выводится только относительный приоритет сигрупп в потреблении cpu (исходя из соотношения между реквестами разных контейнеров). При этом эти веса начинают работать только если cpu всем не хватает. Если нужно жестко управлять ресурсами, доступными контейнерам, используй limits.
George
Может поможет чем-то 🤷♂
 RE
https://plugins.jenkins.io/kubernetes
https://plugins.jenkins.io/kubernetes-cli
https://plugins.jenkins.io/kubernetes-credentials
Вот эти три юзаю, полёт нормальный
можно еще вопрос?
чето не заводится плагин, похоже когда запускается команда kubectl в пайплайне - она же запускается из-под юзера jenkins
и плагин кубцтл-у передает только кубконфиг в env var KUBECONFIG
но я при этом получаю ошибку:
[Pipeline] sh
+ /usr/local/sbin/kubectl get pod
error: You must be logged in to the server (Unauthorized)
а это значит что kubectl не находит .aws/credentials
но об этом на странице доки плагина вообще нет речи.
мол просто сделаете:
withKubeConfig([credentialsId: 'kubeconfig']) {
в kubeconfig как secret text указать файл кубконфига
и все
Dmitry
Нет, от кого деплгить вообще не важно , именно SA пода который создаётся, о том и цитата
Важно.
SA для пода - это монтируемый токен внутрь пода. + как мы выяснили под ним скорее всего работает replicaset контроллер, то есть он создает от имени этого SA сами поды.
Но если ты от рута задеплоишь под, и укажешь там serviceAccountName: default, то поду будет пофиг на psp для SA default. Он создаст его под psp который на рута назначен. Это легко проверить. Создай psp для SA default, c runAsUser от какого нибудь юзера . А потом запусти от админского SA - kubectl run --image=busybox --generator=run-pod/v1 debug -- sleep 999999
И проверь вывод команды id. А затем тоже самое, только создай под от учетки default.
psp - проверяется в API куба. И если ты назначишь psp для SA, который указан в serviceAccountName деплоймента. И в этом psp например запретишь монтировать emptyDir. То при создании такого deployment'а от рута у тебя deployment будет создан и API его разрешит. Но replicaset не сможет создать под, так как он уже будет пытаться это сделать от SA указанного в деплойменте. Но ведь можно сразу деплоить под нужным SA и тебе куб запретит такой деплоймент создавать, сразу будет видно ошибку.
Я могу ошибаться, но оно вроде так работает. Когда-то я проверял это
G72K
Важно.
SA для пода - это монтируемый токен внутрь пода. + как мы выяснили под ним скорее всего работает replicaset контроллер, то есть он создает от имени этого SA сами поды.
Но если ты от рута задеплоишь под, и укажешь там serviceAccountName: default, то поду будет пофиг на psp для SA default. Он создаст его под psp который на рута назначен. Это легко проверить. Создай psp для SA default, c runAsUser от какого нибудь юзера . А потом запусти от админского SA - kubectl run --image=busybox --generator=run-pod/v1 debug -- sleep 999999
И проверь вывод команды id. А затем тоже самое, только создай под от учетки default.
psp - проверяется в API куба. И если ты назначишь psp для SA, который указан в serviceAccountName деплоймента. И в этом psp например запретишь монтировать emptyDir. То при создании такого deployment'а от рута у тебя deployment будет создан и API его разрешит. Но replicaset не сможет создать под, так как он уже будет пытаться это сделать от SA указанного в деплойменте. Но ведь можно сразу деплоить под нужным SA и тебе куб запретит такой деплоймент создавать, сразу будет видно ошибку.
Я могу ошибаться, но оно вроде так работает. Когда-то я проверял это
replicaset controller работает от своего пользователя, у которого есть права создавать поды. Это видно в списке clusterrolebinding. Проверка psp для пода идёт по пользователю, который отправил под (обычно replicaset controller) ИЛИ по SA указанному в поде. Инфа сотка по состоянию на версию 1.12
 Second
Доброго утречка, господа из чатика.
Имею куб 1.14. (14 нод, 3 мастера) и один из подов периодически (23 раза за 3 дня) отваливается с Client.Timeout exceeded while awaiting headers.
куда курить ?
 Tuntsov
В приложение, в котором, наверняка, апач
Second
В приложение, в котором, наверняка, апач
так не пишет приложения никуа. говорит - со мной все в порядке саня, я работаю. и там не апач а джава )))) но памяти не кушает - на мониторинге видно что гуд все.
Cholovik
@LuckySB Чтобы не соврать перепроверил док вот тут - https://lwn.net/Articles/336127/
> In CFS, a task/task group can get more than its share of CPU if there are
enough idle CPU cycles available in the system, due to the work conserving
nature of the scheduler.
Tuntsov
так не пишет приложения никуа. говорит - со мной все в порядке саня, я работаю. и там не апач а джава )))) но памяти не кушает - на мониторинге видно что гуд все.
Попробуй курлом подергать тот запрос, который твой ливнес дергает
Second
ну это стандартный запрос - он отвечает что все ок. но иногда (в непонятных местах) не отвечает и тогда падает. может увеличить там время, количество ответов не правильных итд ?
Tuntsov
Если вам нужно понять причину — то это, очевидно, приложенька. А сделать так,чтобы кубер не убивал его можно и вовсе выпиливанием ливнеса, кек
Second
Если вам нужно понять причину — то это, очевидно, приложенька. А сделать так,чтобы кубер не убивал его можно и вовсе выпиливанием ливнеса, кек
совет конечно хороший. но вроде прод. бесшовный деплой там. все дела. надо чинить
Tuntsov
Тогда выяснять в чем причина периодически долгого ответа на который происходит реакция
G72K
Если вам нужно понять причину — то это, очевидно, приложенька. А сделать так,чтобы кубер не убивал его можно и вовсе выпиливанием ливнеса, кек
Проверьте listen backlog , может просто новые соединения принять не может. Ещё такое в моменты FullGC бывает. Так же если есть лимиты, то надо все внутренние thread pools соответственно подкручивать ,особенно если лимиты сильно меньше количества цпу на ноде
Second
Проверьте listen backlog , может просто новые соединения принять не может. Ещё такое в моменты FullGC бывает. Так же если есть лимиты, то надо все внутренние thread pools соответственно подкручивать ,особенно если лимиты сильно меньше количества цпу на ноде
простите, не очень понимаю. listen backlog это же к nginx (и ингресу) ? у меня там не стоит ничего такого. и url запрос к которому и вызывает ошибку локальный (10.213.92.172)
G72K
простите, не очень понимаю. listen backlog это же к nginx (и ингресу) ? у меня там не стоит ничего такого. и url запрос к которому и вызывает ошибку локальный (10.213.92.172)
Перечитал, у вас awaiting headers , значит запрос отправил нормально, значит смог соединиться, значит listen backlog в порядке. Беклог эта такая штука,которая есть у всех процессов , принимающих TCP соединения. Если он забьется то новые не смогут пробиться
NM
совет конечно хороший. но вроде прод. бесшовный деплой там. все дела. надо чинить
Ты в лимиты не упираешься ?
NM
Если вам нужно понять причину — то это, очевидно, приложенька. А сделать так,чтобы кубер не убивал его можно и вовсе выпиливанием ливнеса, кек
приложение под Tomcat/Jboss/WindFly ? или нативная Java свой сервис там поднимает ?
 Даня
коллеги, тут есть мейнтейнеры хельма?
Lucky SB
Я это понимаю так:
Если система нагружна полностью то шары тут работают как в теории (вроде тут уже где-то всплывало замечание что если есть хоть немного свободных ресурсов то можно на софт ограничения предоставляемые шарамы них обращаться внимания)
А если есть свободные ресурсы, то любой процесс может потребить их, т.к. нет конкуренции
почему на реквесты-шарес можно не обращать внимания при наличии свободных ресурсов ?
Я же правильно понимаю, что shares отвечают за то, что будет задействованы все мощности, в долях от всех желающих ?
Почему разделяется наличие свободных ресурсов и отсутствие.
если процесс running ему шедулер даст процессора столько сколько его вес. чем больше потребителей, тем меньше процессора при том же весе... Каким образом процесс может у шедулера захапать и не отдать ядра ? У нас же многозадачность в линуксе вытесняющая ?
Кстати, а сколько cpu.shares по умолчанию выделяется на процесс?
George
George
Касательно последнего - нисколько.
George
В смысле - ты либо пользуешься этой возможностью и устанавливаешь, либо нет, но я глубоко не копал.
Lucky SB
Многозадачность вытесняющая. Но время ядра - как оно делится ?
пропорционально запрошенным shares ?
George
Что хуже - у тебя для каждой цегруппы свои шерез
George
Т.е. цегруппы создают дерево и внутри нее вложенные делятся пропорционально их шерез
Cholovik
По поводу неиспользованных - CFS организует пул в котором учитывает всё неиспользуемое время для того чтобы его могли потребить те кто хочет
Lucky SB
Неправда, по умолчанию - 1024 на cgroup
ну значит в кублетах поставить рерзерв 1сpu и шедулер распредилит на узел столько подов, чтобы они оставили бы всем остальным как минимум 1 цпу
Dmitry
replicaset controller работает от своего пользователя, у которого есть права создавать поды. Это видно в списке clusterrolebinding. Проверка psp для пода идёт по пользователю, который отправил под (обычно replicaset controller) ИЛИ по SA указанному в поде. Инфа сотка по состоянию на версию 1.12
Инфа ни разу не сотка. Там точно есть какие-то нюансы. Для админа кластера это точно не работает
Создаем SA test
Создаем psp с минимальным id юзера 7000
Создаем роль которая прикрепляется к этому psp
Биндим эту роль на SA test
https://pastebin.com/hJmT7FEV
Создаем вот этот pod: https://pastebin.com/BMfGJ4wB, у которого SA = default.
Сначала от имени SA: test
$ kubectl --as=system:serviceaccount:default:test apply -f pod.yaml
pod/debug created
$ kubectl exec debug -- id
uid=7000 gid=7000 groups=7000
$ kubectl delete po debug
Видим применилась psp от SA: test, так как uid=7000
теперь от админа кластера:
$ kubectl apply -f pod.yaml
pod/debug created
$ kubectl exec debug -- id
uid=0(root) gid=0(root) groups=10(wheel)
Видим uid=0, то есть он наплевал на serviceAccountName внутри пода.
Но при этом если добавить psp для default. И создать под от имени SA test, то будет применен psp от default 🤷♂️.
То есть как минимум, в случае создание подов от админа или от SA это имеет значение.
Second
Знакомо
да вроде лимиты больше. тем более когда упираюсь обычно в логах так и пишут Killed. а тут пусто
Lucky SB
я все веду к тому, что shares распределяет ресурсы пропорционально количеству ядру.
но ведь распределение означает и ограничение ? не так ли ?
@valioozz @gecube
 Gleb
а если это виртуализация?
Second
приложение под Tomcat/Jboss/WindFly ? или нативная Java свой сервис там поднимает ?
там java (я не знаю что такое нативная - у нас 8.192)
G72K
Инфа ни разу не сотка. Там точно есть какие-то нюансы. Для админа кластера это точно не работает
Создаем SA test
Создаем psp с минимальным id юзера 7000
Создаем роль которая прикрепляется к этому psp
Биндим эту роль на SA test
https://pastebin.com/hJmT7FEV
Создаем вот этот pod: https://pastebin.com/BMfGJ4wB, у которого SA = default.
Сначала от имени SA: test
$ kubectl --as=system:serviceaccount:default:test apply -f pod.yaml
pod/debug created
$ kubectl exec debug -- id
uid=7000 gid=7000 groups=7000
$ kubectl delete po debug
Видим применилась psp от SA: test, так как uid=7000
теперь от админа кластера:
$ kubectl apply -f pod.yaml
pod/debug created
$ kubectl exec debug -- id
uid=0(root) gid=0(root) groups=10(wheel)
Видим uid=0, то есть он наплевал на serviceAccountName внутри пода.
Но при этом если добавить psp для default. И создать под от имени SA test, то будет применен psp от default 🤷♂️.
То есть как минимум, в случае создание подов от админа или от SA это имеет значение.
У админа есть доступ к privileged psp оно и выбирается. Поды создаёт контроллер, у него нет доступа к privileged psp, заверните под в деплоймнт
Hankey
можно еще вопрос?
чето не заводится плагин, похоже когда запускается команда kubectl в пайплайне - она же запускается из-под юзера jenkins
и плагин кубцтл-у передает только кубконфиг в env var KUBECONFIG
но я при этом получаю ошибку:
[Pipeline] sh
+ /usr/local/sbin/kubectl get pod
error: You must be logged in to the server (Unauthorized)
а это значит что kubectl не находит .aws/credentials
но об этом на странице доки плагина вообще нет речи.
мол просто сделаете:
withKubeConfig([credentialsId: 'kubeconfig']) {
в kubeconfig как secret text указать файл кубконфига
и все
да, из-под Jenkins пользователя выполняется.
Необходимо в самом k8s создать учетку (с логином и паролем) из-под которой Jenkins будет стучаться в API кластера, точнее, на мастер:6443, и сохраняя этот креденшен в Jenkins, использовать в пайплайне
RE
вооот. то есть надо креды дополнительно еще, кроме кубконфига
решил только это с помощью друого плагина все таки
withAWS(credentials:'id') {
RE
потому что непонятно как "и сохраняя этот креденшен в Jenkins, использовать в пайплайне"
withKubeConfig([credentialsId: 'kubeconfig']) {
тут же только можно указать кубонфиг
George
я все веду к тому, что shares распределяет ресурсы пропорционально количеству ядру.
но ведь распределение означает и ограничение ? не так ли ?
@valioozz @gecube
там опять же два параметра - есть минимально гарантированное и максимальное выделение
Lucky SB
там опять же два параметра - есть минимально гарантированное и максимальное выделение
где ???
Я вижу только часть от общего.
George
потому что я помню, что лично я зарезал через systemd в абсолютных значениях лимиты для цегруппы
Lucky SB
я про шарес щас.
George
https://engineering.squarespace.com/blog/2017/understanding-linux-container-scheduling
George
я просто очень давно это копал, уже давным-давно все забыл
Dmitry
У админа есть доступ к privileged psp оно и выбирается. Поды создаёт контроллер, у него нет доступа к privileged psp, заверните под в деплоймнт
Да, это так. Так как replication controller будет создавать поды от serviceAccountName, оно ведь также это делает через API куба.
Моя мысль была в том, что psp ограничение на уровне API, и нужно это учитывать. То есть важно от какого пользователя создается сам под.
А то что можно создать под от SA которая != SA в поде, на мой вкус довольно небезопасно. Так как можно повысить себе права. Достоточно знать к какой SA прикрплено более свободное в плане прав psp.
 Stas
Всем привет. Kube 1.13.12. Периодически Job падает с ошибкой:
Call to undefined method stdClass::save()SQLSTATE[HY000] [2002] php_network_getaddresses: getaddrinfo failed: Temporary failure in name resolution
При этом следующая сразу запускается нормально. Куда можно копать, может подсказать кто? Логи все прошерстили.
 Отделение Bereke Bank
DNS ❤️
Cholovik
я все веду к тому, что shares распределяет ресурсы пропорционально количеству ядру.
но ведь распределение означает и ограничение ? не так ли ?
@valioozz @gecube
Вы правы, но из того что я изучал, везде акцент делается на том что пока система не находится под нагрузкой (причем имеется в виду именно pressure, когда всем не хватает и приходится жестко конкурировать), можно потреблять сверх шары при наличии ресурсов неиспользованных другими cgroups