 Lucky SB


Ясно.
 Отделение Bereke Bank
https://istio.io/docs/ops/deployment/performance-and-scalability/
это же маркетинговый булшит. Как и у любого другого современного GOвна
 Евгений
Во-первых istio это контрол-плейн к envoy, так что смешно про go. Во-вторых это уже достаточные нагрузки, если у вас 20-30 микросервисов
 Dmitry
 UglyKoyote
дежавю)
 Вадим
namespace с тестовым, самым простым hashicorp/http-echo удаляется уже больше 5 минут, можно как-то форсировать или узнать из-за чего задержка?
Вадим
kubectl describe namespaces echo
Name: echo
Labels: <none>
Annotations: kubectl.kubernetes.io/last-applied-configuration: {"apiVersion":"v1","kind":"Namespace","metadata":{"annotations":{},"name":"echo"}}
Status: Terminating
No resource quota.
No resource limits.
Lucky SB
Поучившись SRE начинаешь понимать, что иногда бывает проще сервис меш растянуть, чем добиваться от десятков команд разработки нормальных ретраев, дедлайнов и прочих фишек
Отделение Bereke Bank
namespace с тестовым, самым простым hashicorp/http-echo удаляется уже больше 5 минут, можно как-то форсировать или узнать из-за чего задержка?
посмотри логи scheduler-а. в какойто 1.13 была такая хрень, что для удаления ns нужен был metrics server 😑 и в логах scheduler-а было об этом написано
Вадим
1.15
Отделение Bereke Bank
ну все равно глянь логи scheduler)
Евгений
Поучившись SRE начинаешь понимать, что иногда бывает проще сервис меш растянуть, чем добиваться от десятков команд разработки нормальных ретраев, дедлайнов и прочих фишек
Это когда у вас нет никакого SLO на летенси
 George
Сервис меш никак не влияет на сло по латенси, а, скорее даже, позволяет его дать более конкретно
George
(т.к. у тебя точное понимание есть сколько там ретраев и серкут брекеров внутри)
Евгений
Ну да, потому что с увеличением порядка значения порядок точности тоже повышается :)
 Mikhail [azalio]
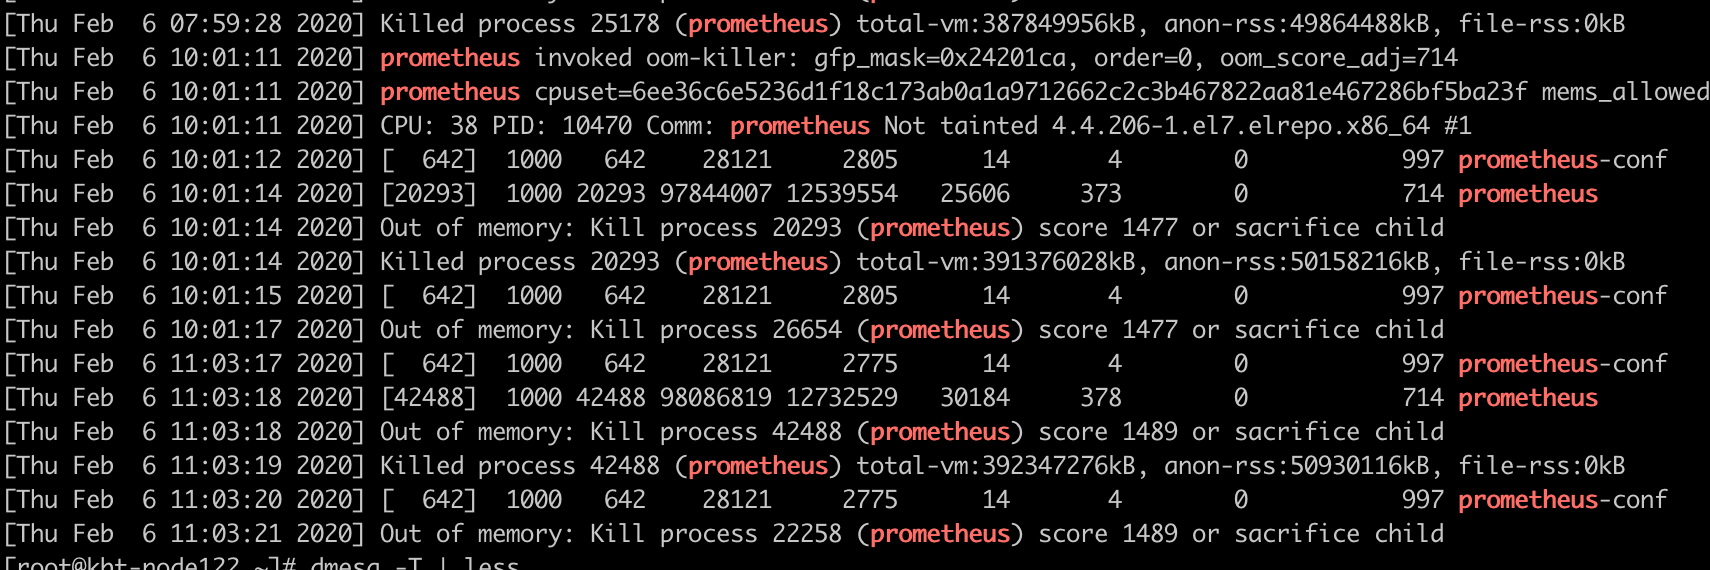
У кого-нибудь есть на примете oom-exporter, который читает dmesg, обогащает данными с апи-сервера и экспортит в прометей?
 𝚔𝚟𝚊𝚙𝚜
У кого-нибудь есть на примете oom-exporter, который читает dmesg, обогащает данными с апи-сервера и экспортит в прометей?
Отличная идея, попробуй спросить в @metrics_ru
NM
Отличная идея, попробуй спросить в @metrics_ru
А там нету по балансировщиками метрик в той церкви то 😉
 Victor
оно в принципе маст-хэв в любом кубе
 Peter
Кто-нибудь скажет что-то хорошее про Flux?
No1
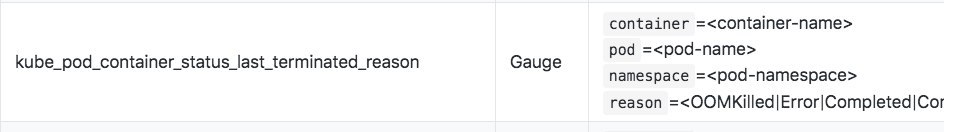
kube-state-metrics не умеет этого
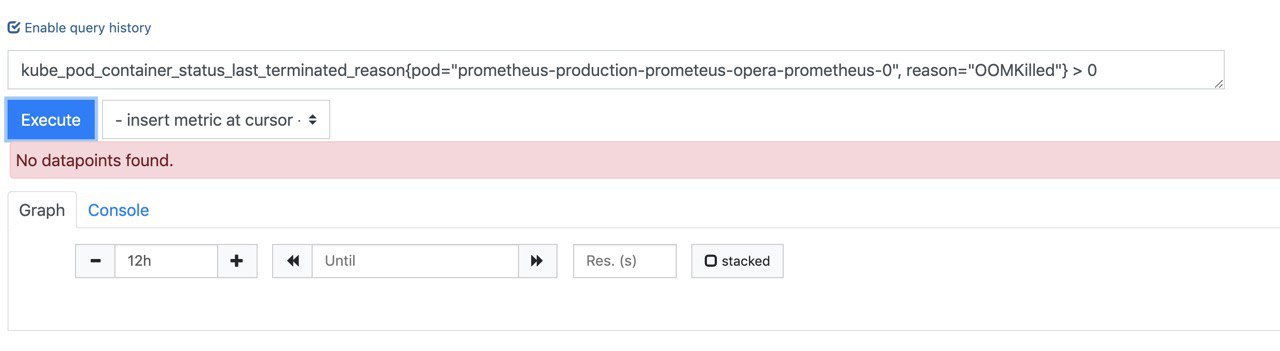
kube_pod_container_status_terminated_reason reason=<OOMKilled|Error|Completed|ContainerCannotRun|DeadlineExceeded>
 Sergei
товарищи, подскажите в filebeat можно отсеивать логи по лейблам на неймспейсе? может есть у кого example, не совсем профильный канал конечно, для данного вопроса
Mikhail [azalio]
 Mikhail [azalio]
 Mikhail [azalio]
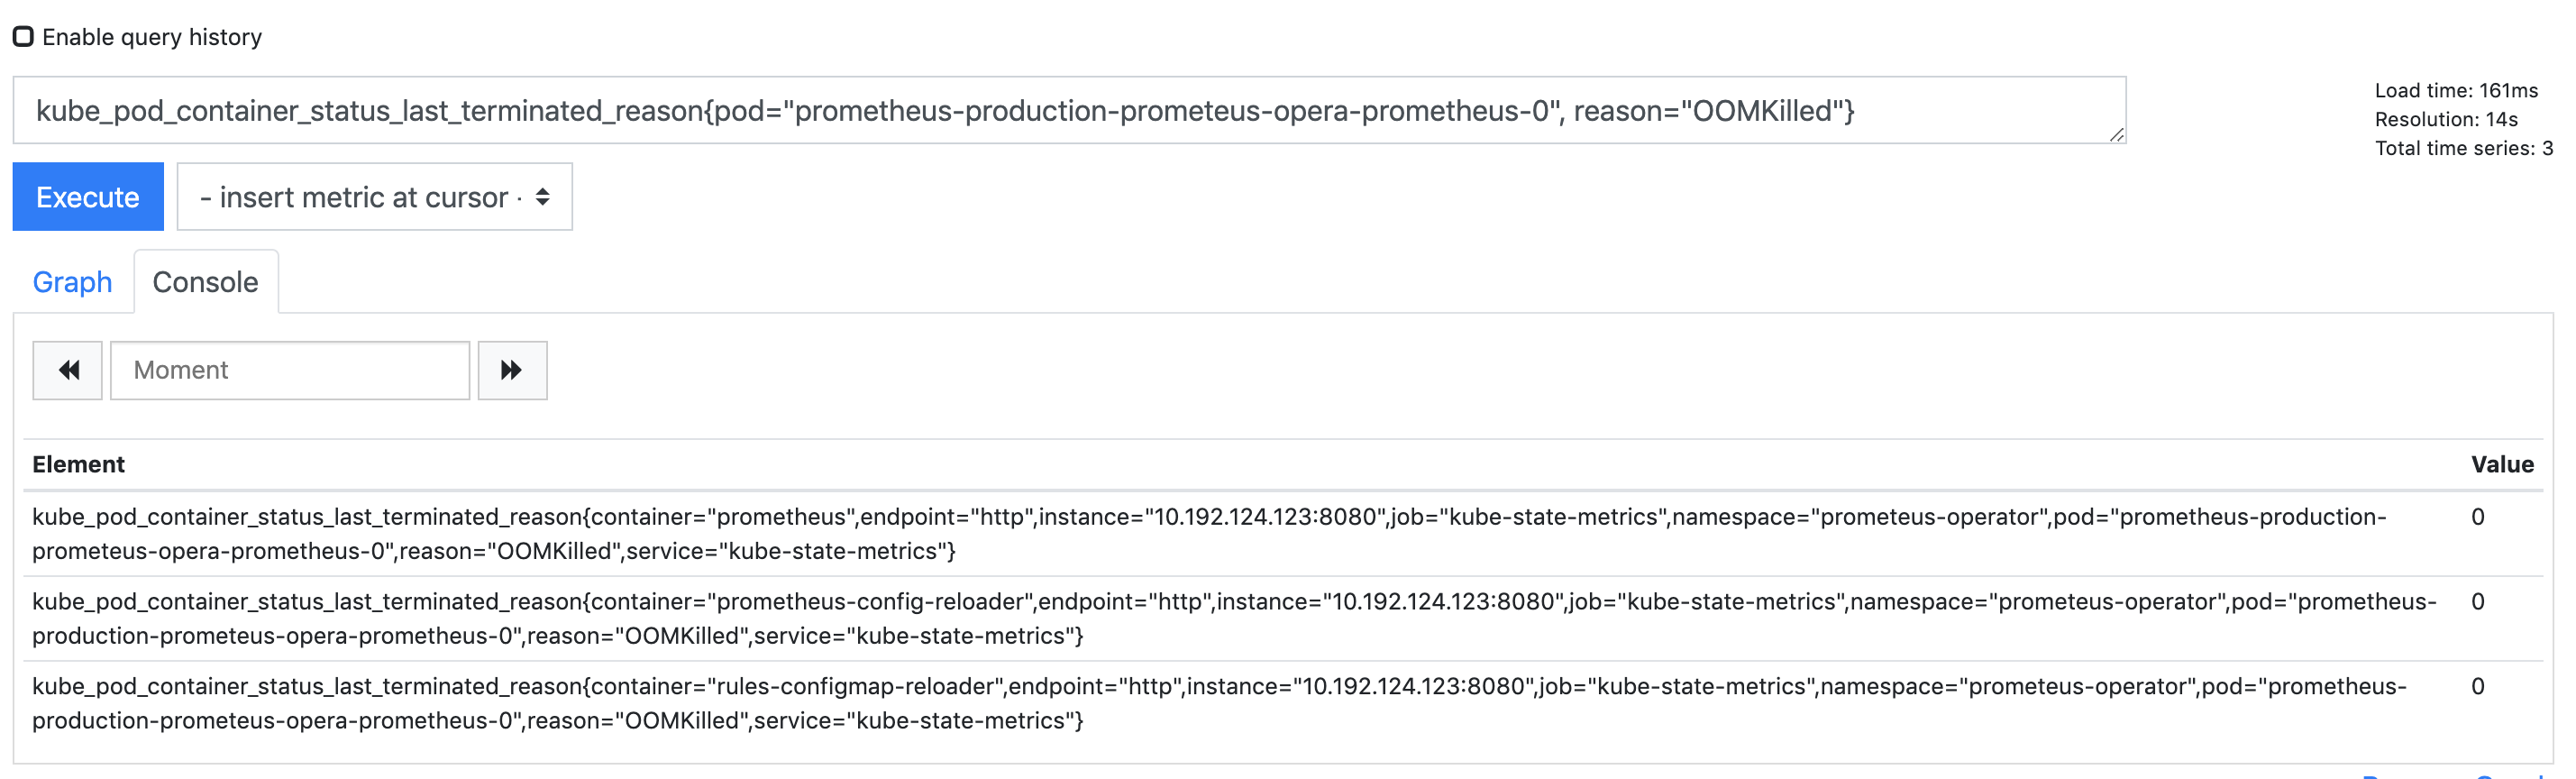
kube_pod_container_status_last_terminated_reason{container="prometheus",endpoint="http",instance="10.192.124.123:8080",job="kube-state-metrics",namespace="prometeus-operator",pod="prometheus-production-prometeus-opera-prometheus-0",reason="Error",service="kube-state-metrics"} - было
Victor
 Shamil
Здравствуйте, ребятушки! Хочу задействовать kubewatch, для отправки уведомлений о событиях в k8s. Не подскажите это самое оптимальное решение, или есть что-то получше?
https://github.com/bitnami-labs/kubewatch
Victor
Victor
к тому же он подглючивает и делает из 16-го мака раскаленную печь
 Solyar
товарищи, подскажите в filebeat можно отсеивать логи по лейблам на неймспейсе? может есть у кого example, не совсем профильный канал конечно, для данного вопроса
Может что-то такое попробовать?
- drop_event.when.regexp:
or:
- kubernetes.pod.label.app: "some label"
Sergei
да я вот тоже в эту сторону смотрю, проверю отпишусь
Shamil
Мне надо именно уведомления о перезапуске подов, выкатках и так далее. Alert-Manager тоже это может разве? Как там ловить события то?
George
Мне надо именно уведомления о перезапуске подов, выкатках и так далее. Alert-Manager тоже это может разве? Как там ловить события то?
тащи из CI/CD системы - из flux, например
Victor
Мне надо именно уведомления о перезапуске подов, выкатках и так далее. Alert-Manager тоже это может разве? Как там ловить события то?
у них развесистый helm чарт с примерами как такое накрутить
Отделение Bereke Bank
Мне надо именно уведомления о перезапуске подов, выкатках и так далее. Alert-Manager тоже это может разве? Как там ловить события то?
в проме есть метрики про рестарты, ContainerCreating и т.д. Можешь алертить по ним
George
Разверни, пожалуйста?
парни старались, делали
https://github.com/fluxcd/flux
https://github.com/weaveworks/flagger
Victor
А для чего тогда?
пардон, я с kubespy перепутал . но таки лучше использовать прометеус оператор, чтобы не плодить сущности
Victor
 Отделение Bereke Bank
у меня вообще reason-а OOMKilled нет 😑
Victor
у меня у некоторых namespace ловит, у некоторых нет
Shamil
парни старались, делали
https://github.com/fluxcd/flux
https://github.com/weaveworks/flagger
Что-то мне кажется, это too much...
Отделение Bereke Bank
у меня у некоторых namespace ловит, у некоторых нет
может там лимиты не выставлены?
 Artem
Отличная идея, попробуй спросить в @metrics_ru
Мне кажется по кубернетесовски будет написать контроллер, который вотчит терминацию подов и заглядывает в причину.
Artem
в принципе https://github.com/m-lab/prometheus-support/issues/213
Alexey
Коллеги, помогите, не могу понять, с какой стороны подступиться к проблеме.
Приложение на .net, docker 18.09, k8s 1.15. При попытке убить поды часть из них повисает в terminating, на воркер-ноде остаются запущенными контейнеры с самим прикладом.
В связи с тем, что pause-контейнеры успешно удаляются, docker exec в контейнеры с прикладом выполнить не удается. На docker stop/kill не реагируют, остаются в выводе docker ps даже после рестарта докер-демона (при остановленном кублете).
Воркер-ноды разные, в логах докера
failed to exit within 30 seconds of signal 15 - using the force,
failed to exit within 10 seconds of kill - trying direct SIGKILL
Предполагаю, что какая-то проблема в прикладе, если он так вешает контейнеры, но что-то нет идей, как дебажить.
Anonymous
ребятая переношу приложение из docker swarm с traefik там у меня был редирект все ошибки 502 перенаправлять на бекенд nginx с страничкой /maintenance.html
по сути выглядело вот так
traefik.frontend.errors.web.status: "502-599"
traefik.frontend.errors.web.backend: "error"
traefik.frontend.errors.web.query: "/maintenance.html"
теперь пытаюсь адаптрировать это под ингрессконтролер
но столкнулся с тем что для него можно указать только ошибку или диапазон и бекенд а страницу с ошибкой в документации найти не могу
как мне рулить ошибками для 502 идем на такуюто страницу на 503 идем на другую
в traefik рулится лехгко.
Anonymous
apiVersion: extensions/v1beta1
kind: Ingress
metadata:
annotations:
kubernetes.io/ingress.class: nginx
nginx.ingress.kubernetes.io/custom-http-errors: "502-599"
nginx.ingress.kubernetes.io/default-backend: {{ .Release.Name }}-maintenance
Anonymous
догадываюсь что в кубере это рулится конфигурацией бекенда в соотствиии с присланым хеадером X-Code
Oleh
догадываюсь что в кубере это рулится конфигурацией бекенда в соотствиии с присланым хеадером X-Code
https://kubernetes.github.io/ingress-nginx/user-guide/custom-errors/
Anonymous
https://kubernetes.github.io/ingress-nginx/user-guide/custom-errors/
какраз смотрю доку и вижу что логика работы отличается от traefik
X-Code мой вариант
Dmytro
400 values.yaml держать?
там можно же передать несколько values.yaml один за другим, и каждый следующий будет оверрайдить пересекающиеся ключи из предыдущего, чем это не подходит?
Oleh
какраз смотрю доку и вижу что логика работы отличается от traefik
X-Code мой вариант
вот пример кастомного бека https://github.com/kubernetes/ingress-nginx/tree/master/images/custom-error-pages
 Anonymous
Dmytro
Коллеги, помогите, не могу понять, с какой стороны подступиться к проблеме.
Приложение на .net, docker 18.09, k8s 1.15. При попытке убить поды часть из них повисает в terminating, на воркер-ноде остаются запущенными контейнеры с самим прикладом.
В связи с тем, что pause-контейнеры успешно удаляются, docker exec в контейнеры с прикладом выполнить не удается. На docker stop/kill не реагируют, остаются в выводе docker ps даже после рестарта докер-демона (при остановленном кублете).
Воркер-ноды разные, в логах докера
failed to exit within 30 seconds of signal 15 - using the force,
failed to exit within 10 seconds of kill - trying direct SIGKILL
Предполагаю, что какая-то проблема в прикладе, если он так вешает контейнеры, но что-то нет идей, как дебажить.
ваше приложение судя по всему игнорирует sigkill - может там баш вместо нормального инит процесса? Или как вариант есть detached zombie process внутри контейнера. Короче tiny или dumb-init должны поправить ситуацию
Dmytro
ребятая переношу приложение из docker swarm с traefik там у меня был редирект все ошибки 502 перенаправлять на бекенд nginx с страничкой /maintenance.html
по сути выглядело вот так
traefik.frontend.errors.web.status: "502-599"
traefik.frontend.errors.web.backend: "error"
traefik.frontend.errors.web.query: "/maintenance.html"
теперь пытаюсь адаптрировать это под ингрессконтролер
но столкнулся с тем что для него можно указать только ошибку или диапазон и бекенд а страницу с ошибкой в документации найти не могу
как мне рулить ошибками для 502 идем на такуюто страницу на 503 идем на другую
в traefik рулится лехгко.
нужно сделать кастомный образ с default backend и там все разрулить, в том числе хтмл страничку со своим дизайном вкрутить и т.д.
Anonymous
нужно сделать кастомный образ с default backend и там все разрулить, в том числе хтмл страничку со своим дизайном вкрутить и т.д.
да уже понял судя по доке, логика не такая как в traefik
Alexey
 Dmitry
Я пока думаю values.yaml вот этой тулой генерить, а подставлять стейджи и прочие глобальные параметры простым седом. смущает то,, что больно много надо промежуточных шагов
А у тебя там динамические стейджи? Можно же все стейджи в values.yaml описать, и через --set выбирать один из стейджов, и все параметры брать из нужного стейджа. В начале шаблона делаешь просто: {{ $params:= index .Values.stages .Values.stage }} и само название stage' а передаешь через --set, ну или несколько values файлов держать
 Igorь
А у тебя там динамические стейджи? Можно же все стейджи в values.yaml описать, и через --set выбирать один из стейджов, и все параметры брать из нужного стейджа. В начале шаблона делаешь просто: {{ $params:= index .Values.stages .Values.stage }} и само название stage' а передаешь через --set, ну или несколько values файлов держать
там не только стейджи. еще разные кластера.
Igorь
Желательно, чтобы не пришлось менять сам скрипт
Dmitry
там не только стейджи. еще разные кластера.
ну деплой в разные кластера с разными .kube/config конфигами, в чем проблема?
Igorь
та же, что и со стейджами. 3 стейджа, 20 кластеров = 60 вариантов паролей и адресов баз
Dmytro
та же, что и со стейджами. 3 стейджа, 20 кластеров = 60 вариантов паролей и адресов баз
а где пароли то хранятся?
Igorь
hashicorp vault
Dmitry
hashicorp vault
ну так передаешь через --set название стейджа и название кластера. А внутри values для каждого кластера и стейджа, описано откуда секреты брать. Два параметра получается