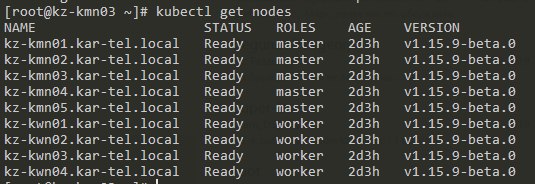
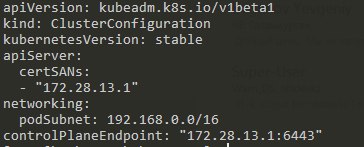
и ты скейл чего хочешь - все-таки подов или все-таки НОДЫ скейлить ? ну типо в обалке
вот кароч что сейчас
apiVersion: autoscaling/v1
kind: HorizontalPodAutoscaler
metadata:
name: canonical
spec:
maxReplicas: 10
minReplicas: 1
scaleTargetRef:
apiVersion: extensions/v1beta1
kind: Deployment
name: canonical
targetCPUUtilizationPercentage: 20
 Anonymous


 Solyar
скейл по деплойментам, если б мне нужны были ноды, то в авс настроила
А почему 20 процентов то?
Solyar
Solyar
https://kubernetes.io/docs/tasks/run-application/horizontal-pod-autoscale/#how-does-the-horizontal-pod-autoscaler-work
Solyar
Тут вроде всё ясно описано
Solyar
Ну и снизу алгоритм по которому он считает
 Slach
Всем привет, пытаюсь тут настроить
https://github.com/integr8ly/grafana-operator/
в логах оператора вижу
вот такое
'events "fly1egor-clickhouse-dashboard.15f03f1463fa99c3" is fo ││ rbidden: User "system:serviceaccount:grafana:grafana-operator" cannot patch resource "events" in API group "" in the namespace "grafana" ││ ' (will not retry!)
в какую сторону копать как править
https://github.com/integr8ly/grafana-operator/tree/master/deploy/cluster_roles ?
чтобы пофиксить ?
G72K
В каком чате SRE обсуждают ?
 Stas
В каком чате SRE обсуждают ?
им некогда - они пишут сложную автоматизацию для составления идеального расписания дежурств с ML и GPU
 George
им некогда - они пишут сложную автоматизацию для составления идеального расписания дежурств с ML и GPU
Слишком часто кластер ломается ? 😂
 Yurii
привет. подскажите использую EKS. несколько разных кластеров
из нутри они все одинаковые
Но мне нужно их как-то отличать их из нутри для подов.
как можно имя или какой-то lable задать? что бы это значение предавать в контейнер как env переменную?
George
привет. подскажите использую EKS. несколько разных кластеров
из нутри они все одинаковые
Но мне нужно их как-то отличать их из нутри для подов.
как можно имя или какой-то lable задать? что бы это значение предавать в контейнер как env переменную?
Пришивать к каждому деплоцменту через какой нибудь адмишн хук специальную переменную ?
George
Или ещё можно было использовать некие шаблонные переменные в деплойменте
Yurii
ну вот такая штука
env:
- name: NAMESPACE
valueFrom:
fieldRef:
fieldPath: metadata.namespace
по идеи же я так же могу читать какое-то значение которое уникально для данного кластер.
возможно aws tags доступны как-то внутри
George
да, примерно
George
https://stackoverflow.com/questions/52680807/how-to-assign-cluster-namespace-and-pod-name-in-kubernetes-yaml-files-environm
George
о черт. Стекоферфлоу. Великий и ужасный
Solyar
Ребят тут вроде проскакивала аутентификация через AD Microsoft. Кто с этим дело имел?
NM
FreeIPA или к LDAP. Поподробнее что хочешь
Solyar
В общем доступы в кластер разграничить надо только через AD
 Victor
Ребят тут вроде проскакивала аутентификация через AD Microsoft. Кто с этим дело имел?
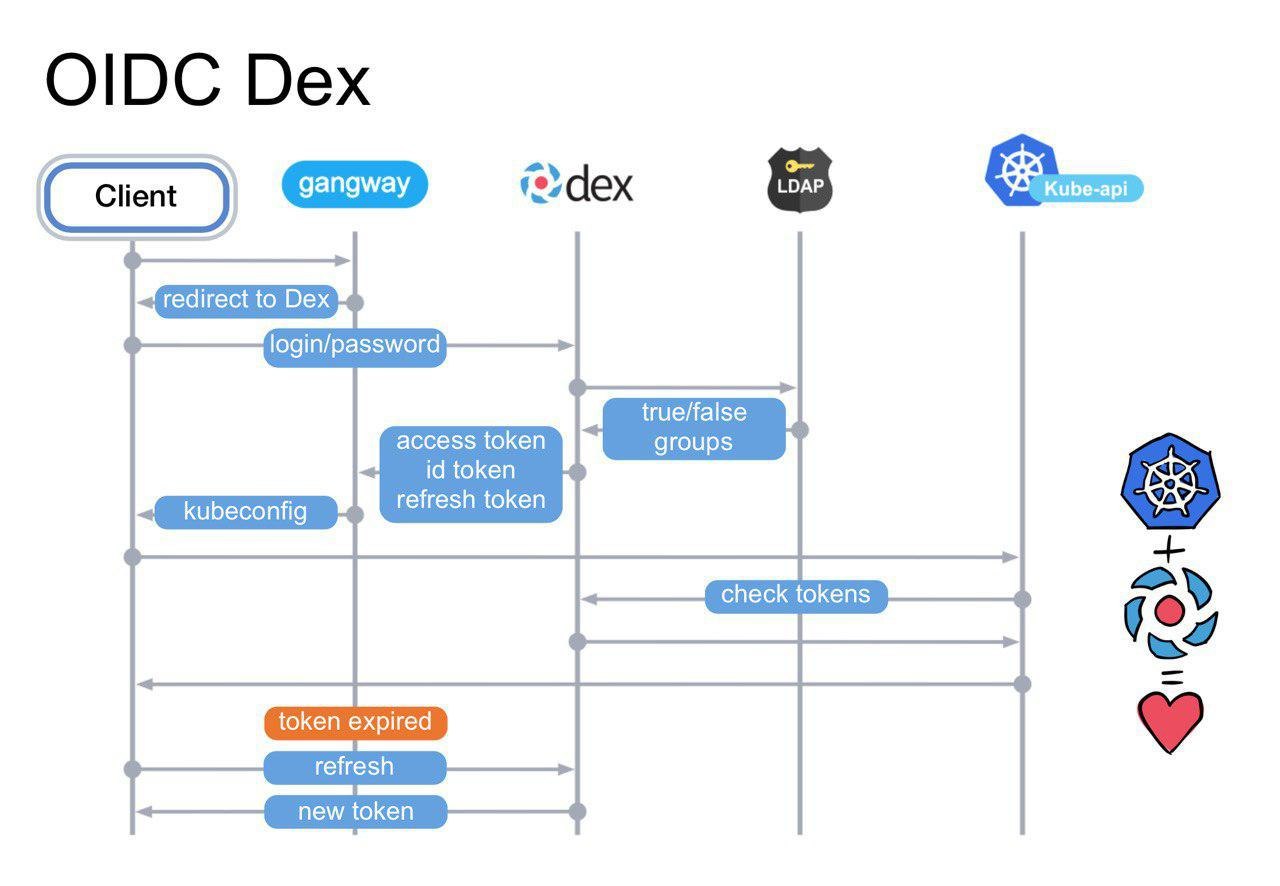
буквально сегодня было . Kong + DEX + OIDC + оператор для руления доступами в нэймспейсы
Solyar
Solyar
Ранчер не вариант
Solyar
Там... openshift (будет)
 Aleksei
 Alex
в openshift же из коробки ldap авторизация есть
 Stanislav
скажите, а какую сеть лучше использовать в кубере? в интернетах очень многие топят за flannel, но есть рекомендации и для calico и cilium
Aleksei
скажите, а какую сеть лучше использовать в кубере? в интернетах очень многие топят за flannel, но есть рекомендации и для calico и cilium
cilium норм, если вы рисковый парень
а так - калико стандарт
Stanislav
не, не рисковый 🙂
G72K
В общем доступы в кластер разграничить надо только через AD
Куб настроить на OIDC, OIDC взять в ажуре или keycloak
Solyar
Подробностей не знаю что будет
George
скажите, а какую сеть лучше использовать в кубере? в интернетах очень многие топят за flannel, но есть рекомендации и для calico и cilium
Во фланел нет Нетворк полиси. Это критикал
Solyar
На фланеле далеко не уедешь
Solyar
Если только у тебя кластер будет с личным доступом и за несколькими VPN, так как разграничивать сетевые доступы затруднительно на фланеле ну и калико соответствует бест практисис
G72K
Я пока морально подготавливаюсь
Не девопс что-ли . Девопсы никогда не готовятся, только реагируют
 Solyar
Настроить не проблема. Потом надо поддерживать а это другое.
Stanislav
Если только у тебя кластер будет с личным доступом и за несколькими VPN, так как разграничивать сетевые доступы затруднительно на фланеле ну и калико соответствует бест практисис
спасибо. это интересный момент в пользу калико
 𝚔𝚟𝚊𝚙𝚜
Victor
 Dmitry
скажите, а какую сеть лучше использовать в кубере? в интернетах очень многие топят за flannel, но есть рекомендации и для calico и cilium
если бесит куча iptables в calico, можно взять kube-router, там их чутка меньше (активно юзает ipset). NetworkPolicy тоже поддерживает
 Pavel
если бесит куча iptables в calico, можно взять kube-router, там их чутка меньше (активно юзает ipset). NetworkPolicy тоже поддерживает
kube-router для network policy не юзает iptables?
 M
Кто нибудь решал такую задачу собирать информацию использование gpu через prometheus на конкретного человека или группу?
 Alexandr
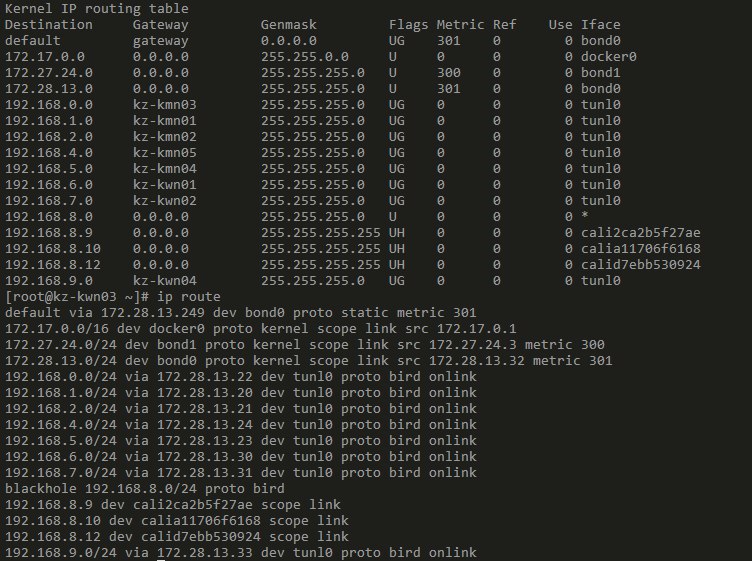
Всем привет, поднял кластер kubernetes , хранилищем сделал ceph. Сервера сефа имеют 2 сети cluster и public network, в кубе создал pvc и pv через провижинер, но тут появилась проблема, теперь при вызове kubectl exec -it -n git git bash выходит ошибка - Error from server: error dialing backend: dial tcp 172.27.24.3:10250: i/o timeout - мастер нода пытается обратиться к воркеру через кластерную сеть сефа, можно ли как то ограничить что бы куб не использовал ее ? или же придется заводить кластерную сеть и на мастер ноды?
Alex
посмотрите что с маршрутами на хостовых машинах. похоже что какая то путаница с сетями. посмотрите повнимательнее на сети хостов, докера и сеть кубера.
Alexandr
не совсем догоняю где косяк, 172.27.24.0/24 глухая сеть
George
Кто нибудь решал такую задачу собирать информацию использование gpu через prometheus на конкретного человека или группу?
Ты это не решишь по-простому, кмк
George
Можно свой экспортер написать, который хитро будет тянуть загрузку из nvidia-smi, брать список процессов с системы, аккуратно определять в каком это systemd slice запускается и считать общее
George
Ну, пара дней работы на голанге точно
Alexandr
 Niks
подскажите плиз- мне в новом ранчере кластерные фс недоступны - например ceph и glusterfs
Niks
тоесть в persistentstorage нет выбора этих кластерных фс
Niks
что я делаю не так?
Solyar
Всем привет, поднял кластер kubernetes , хранилищем сделал ceph. Сервера сефа имеют 2 сети cluster и public network, в кубе создал pvc и pv через провижинер, но тут появилась проблема, теперь при вызове kubectl exec -it -n git git bash выходит ошибка - Error from server: error dialing backend: dial tcp 172.27.24.3:10250: i/o timeout - мастер нода пытается обратиться к воркеру через кластерную сеть сефа, можно ли как то ограничить что бы куб не использовал ее ? или же придется заводить кластерную сеть и на мастер ноды?
Чем кубернетес накатывали? До добавления провижинера всё ок было?
Alexandr
Чем кубернетес накатывали? До добавления провижинера всё ок было?
Кубернетесис руками через init
Alexandr
Чем кубернетес накатывали? До добавления провижинера всё ок было?
До провиженера не посмотрел как себя ведёт
Alexandr
172.27.24.0/24 использую как кластер нетворк и она только на воркерах
Alexandr
Может быть кубу нужно как то сказать что бы не использовал эту сеть
Solyar
Надо было явно указать интерфейс если там несколько сетей
Solyar
kubectl get nodes что говорит?
Solyar
Ну и describe обеих желательно