Коллеги, мы ищем Dev/Ops специалиста в команду. #DevOps, #fulltime, #удаленка.
На рынке мы занимаемся лингвистическим сопровождением (www.e-cetera.ru) и в данный момент разрабатываем собственный продукт - облачный инструмент автоматизации переводов (СAT).
Условия работы: мы предлагаем работу с полной занятостью, удаленно и с гибким графиком, белую зарплату по итогам собеседования от 80 K и участие в уникальном инновационном проекте
Нам нужен специалист, который занимался настройкой и раскаткой Kubernetes, переездом текущих приложений в Kubernetes (Dev & Prod стенды), настройкой CI CD, а также проводил администрирование серверов компании и делал бэкапы.
Dev/Ops должен владеть Linux: устройство, дистрибутивы, настройка, пакетные менеджеры, обслуживание и уверенно пользоваться Bash, Iptables, Docker, Docker Compose, Docker Swarm, Git (на уровне пользователя).
Пишите, буду рада рассказать подробнее о вакансии и ответить на вопросы.
Обратите внимание на @devops_jobs
 Alexander


 Grisha
А сколько всего подов? Соединения долгоживущие?
5 шт, один умрирает и траф херачит на рандомный 1 под
конекты быстрые, логин
 Dmytro
%% Max message size is hard limited to 512 MiB.
%% If user configures a greater rabbit.max_message_size,
%% this value is used instead.
-define(MAX_MSG_SIZE, 536870912).
Там что прямо видео файлы в мессадж пихается?
Alexander
5 шт, один умрирает и траф херачит на рандомный 1 под
конекты быстрые, логин
Трафик через ингресс? Какой ингресс-контроллер? Шлет ли он траф через сервис или напрямую в поды? Если через сервис, то какой конфиг кубе-прокси (iptables или ipvs)?
 Tadeusz
Grisha
Alexander
svc, без ингреса, ipvs
Ну хз. Подозреваю, что проблема в ipvs. У нас kube-router тоже с ipvs, но такую проблему не замечали. Возможно, это баг в ядре. Или, вообще, в поведении хелсчеков подов.
Grisha
будем копать, мне пока эту инфу qa сбросили, думал может это какой-то известный баг
Dmytro
 Vadim
Эндпоинты не снимаются мгновенно, правила iptables тоже не удаляются сразу же. Повесьте слипчик в preStop hook
Dmytro
В энтрипойнте - джава, спринг-бут, да. Просто на старте много всего загружается в кэш.
В общем понял про лимиты, VPA... Напишу что получилось. Спасибо
Не знаю как там в спринге но в нормальных языках и фреймворках кеш обычно стоит отдельно один на все реплики (редис, мемкеш и тп). Или у вас там что-то типа карт где латенси в пару мс до редиса уже много?
Dmytro
будем копать, мне пока эту инфу qa сбросили, думал может это какой-то известный баг
А точно под есть в эндпоинтах сервиса? Может под not ready?
 George
Рабство отменили.
Salem
100k это в год или месяц?
 Lucky SB
руб в год это совсем грустно
 Dmitry
А джунам сколько не стыдно просить? Не флейма ради, просто интересуюсь
Fedor
А джунам сколько не стыдно просить? Не флейма ради, просто интересуюсь
Зависит от многих факторов
George
У них как раз оплачиваемая стажировка есть 😂
Fedor
В первую очередь от бекграунда
Fedor
Ну и города естесна
Dmitry
Ну типа, получается, джуну в @devops_jobs соваться смысла нет, там серьезные дяденьки сидят, правильно я понимаю?
Fedor
Fedor
там вакухи с границей ниже 100к банят
Работаю в спб к8с + хелм + женкинс (груви) меньше чем за 100 :(
Что-то явно со мной не так
 victor
Рабство отменили.
Только если ты коренной москвич или петербуржец (так же правильно говорить?)
Lucky SB
Работаю в спб к8с + хелм + женкинс (груви) меньше чем за 100 :(
Что-то явно со мной не так
могу скинуть ссылку на секретный чатик где обещают многа. и даже в питере
victor
Lucky SB
будешь получать как финтех
Fedor
могу скинуть ссылку на секретный чатик где обещают многа. и даже в питере
Который выше 5 раз мелькнул?)
NM
Ааа, Питер уважаю если что
victor
Не понел :с
Вроде не молодой, а мэм про 146% не знаете) даже у нас в замкадье, 750 км на запад за то, что перечислено платят 2500$ плюс
Fedor
Вроде не молодой, а мэм про 146% не знаете) даже у нас в замкадье, 750 км на запад за то, что перечислено платят 2500$ плюс
Про 146 знаю, но по контексту не понял. А откуда инфа что не молодой? :)
Fedor
Вроде не молодой, а мэм про 146% не знаете) даже у нас в замкадье, 750 км на запад за то, что перечислено платят 2500$ плюс
Эх, вот что-то в родных 1200 км на восток нет такого...
Как-бы намекаю что понаехал и работаю за еду
victor
Про 146 знаю, но по контексту не понял. А откуда инфа что не молодой? :)
По фото каля 30, яп сказал, миниум 25
Fedor
По фото каля 30, яп сказал, миниум 25
Так на фото-ж небезызвестный товарищ Епифанцев, а не я :)
victor
Так на фото-ж небезызвестный товарищ Епифанцев, а не я :)
Эк я оподливился( главное, чтобы с к8с также не вышло
Fedor
Эк я оподливился( главное, чтобы с к8с также не вышло
Это как раз таки часть проблемы. Надо на собесы ходить, чтобы трезво себя оценивать, это да
Fedor
Кстати про джунов за 100+ - валом идут такие, которые резидентную память от виртуальной не отличают, к слову об этом
NM
Ржу
NM
Lucky SB
Fedor
Был у вас на интенсивчике в Севастопольской :) Было неплохо, хорошо делаете
Fedor
А правда что у вас недавно правило появилось касающееся открытия баночек с кока-колой?))
 Yury
что за правило?
Lucky SB
вскрывать банки только в перерывах. чтобы на запись звуки выстрелов не попадали
Lucky SB
специально обученный тамада каждый раз показывал когда и как это надо делать
Fedor
Это правильно, я об этом ещё тогда подумал)
Dmitry
Lucky SB
Был у вас на интенсивчике в Севастопольской :) Было неплохо, хорошо делаете
хехе. я как раз в севастопольской :) завтра Devops2 с понедельника SRE ;) https://slurm.io
Fedor
хехе. я как раз в севастопольской :) завтра Devops2 с понедельника SRE ;) https://slurm.io
А работать-то когда?))
Yury
а чем это не работа? )
Fedor
Это да, ну то шутейка жеж.
G72K
Кстати про джунов за 100+ - валом идут такие, которые резидентную память от виртуальной не отличают, к слову об этом
Элементарно же, резидентная память платит налоги
Й
 Cholovik
100
* sum by(container_name, pod_name, namespace) (increase(container_cpu_cfs_throttled_periods_total{container_name!="", namespace=~".*$namespace.*"}[5m]))
/ sum by(container_name, pod_name, namespace) (increase(container_cpu_cfs_periods_total{namespace=~".*$namespace.*"}[5m]))
> 1
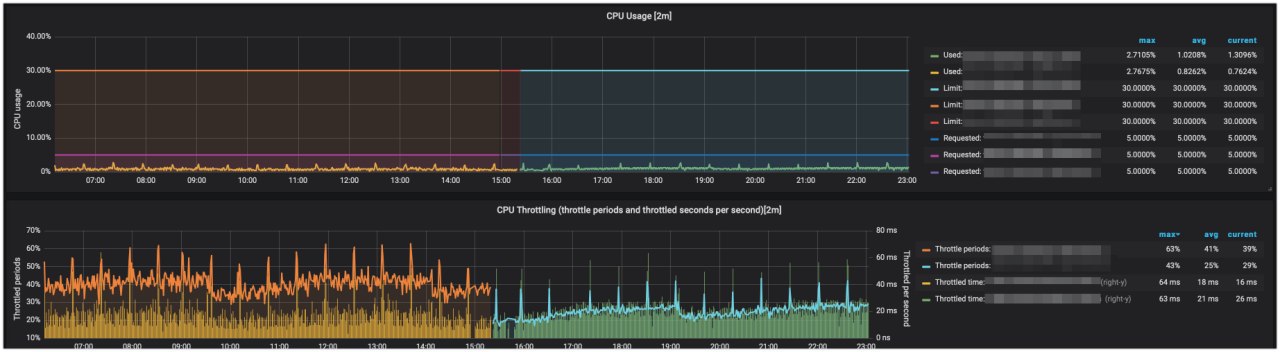
 Mikhail [azalio]
100
* sum by(container_name, pod_name, namespace) (increase(container_cpu_cfs_throttled_periods_total{container_name!="", namespace=~".*$namespace.*"}[5m]))
/ sum by(container_name, pod_name, namespace) (increase(container_cpu_cfs_periods_total{namespace=~".*$namespace.*"}[5m]))
> 1
С можете скинуть дашборду на pastebin например?
 Victor
 Dmitry
Господа, помогите советом\ссылкой, пожалуйста.
Хотел настроить автоматическое горизонтальное масштабирование в кубернетесе. И в целом получилось. Если утилизация cpu превышает 70%, автоматически создаётся новвый pod - всё здорово. К сожалению, в процессе старта нового poda (новой приложухи внутри него) утилизация cpu близка к 100%, в связи с чем создаётся ещё один новый pod и так далее, пока не упираюсь в лимит числа pod'ов.
Нашёл параметры, которые с виду могли бы помочь: horizontal-pod-autoscaler-*. Но мне видится, что эти параметры нельзя сконфигурировать для конкретного моего HPA объекта, а только для всего HPA-контроллера - https://kubernetes.io/docs/reference/command-line-tools-reference/kube-controller-manager/. А конкретно этот мой сервис характеризуется долгим временем старта (примерно 45 секунд).
Может быть, я просто упустил что-то в конфигурации? Может быть есть более лучшие способы настроить автоскейлинг? Не по нагрузке процессора, а по....числу входящих запросов в секунду или что-то такое альтернативное.
Заранее спасибо
Очень странный кейс. У вас такая долгая инициализация, что HPA успевает заскейлить еще подов во время инициализации? Сколько по времени?
Он же ждет около 3-5 минут после машстабирования, стабилизации метрик. И только потом начинает масштабировать дальше.
У меня тоже есть приложение, которое жрет сильно много при старте, но это происходит около 20-30 секунд, и HPA не начинает дальше масштабировать.
> В энтрипойнте - джава, спринг-бут, да. Просто на старте много всего загружается в кэш.
Может этап инициализации засунуть в init контейнер, который бы эти кэши складывал в redis например, как cloud-native завещал, а потом при старте контейнера основного, уже будет все готово для него. В любом случае что-то делать с приложением надо.
Пока не отработает init контейнер, по идее HPA не должен пытаться понять учитывать этот под .
 krakazyabra
народ, всем привет! Скажите, как правильно прописать лимиты:
есть деплоймент, он описывает простое приложение. хочу, чтобы при потреблении подом более 2гб памяти, создавался новый под и запросы шли уже в него. как это правильно сделать?
krakazyabra
приложение горизонтально скелится очень легко
Andrey
Господа, помогите советом\ссылкой, пожалуйста.
Хотел настроить автоматическое горизонтальное масштабирование в кубернетесе. И в целом получилось. Если утилизация cpu превышает 70%, автоматически создаётся новвый pod - всё здорово. К сожалению, в процессе старта нового poda (новой приложухи внутри него) утилизация cpu близка к 100%, в связи с чем создаётся ещё один новый pod и так далее, пока не упираюсь в лимит числа pod'ов.
Нашёл параметры, которые с виду могли бы помочь: horizontal-pod-autoscaler-*. Но мне видится, что эти параметры нельзя сконфигурировать для конкретного моего HPA объекта, а только для всего HPA-контроллера - https://kubernetes.io/docs/reference/command-line-tools-reference/kube-controller-manager/. А конкретно этот мой сервис характеризуется долгим временем старта (примерно 45 секунд).
Может быть, я просто упустил что-то в конфигурации? Может быть есть более лучшие способы настроить автоскейлинг? Не по нагрузке процессора, а по....числу входящих запросов в секунду или что-то такое альтернативное.
Заранее спасибо
readiness check уже посоветовали выставить?
https://kubernetes.io/docs/tasks/run-application/horizontal-pod-autoscale/
_When scaling on CPU, if any pod has yet to become ready (i.e. it’s still initializing) or the most recent metric point for the pod was before it became ready, that pod is set aside_
Andrey
народ, всем привет! Скажите, как правильно прописать лимиты:
есть деплоймент, он описывает простое приложение. хочу, чтобы при потреблении подом более 2гб памяти, создавался новый под и запросы шли уже в него. как это правильно сделать?
https://kubernetes.io/docs/tasks/run-application/horizontal-pod-autoscale/
 Антон
Ребят, может что-то посоветуете, голову уже сломал
Короче пилю EFK чарт, с сабчартами - elasticsearch и kibana (официальные чарты от эластика). Чтобы можно было весь комбаин разворачивать одинм движением. По непонятным для меня причинам, ни эластик ни кибана не создают своих секретов с логин-паолем, но зато ожидают переменных с этими данными. Для этого у них есть extraEnvs. В общем задача выглядит так: создаем секрет в родительском чарте, генерируя имя из релиза, неймспейса и т.д. и пароль внутри секрета, и линкуем переменные в сабчарты, через extraEnvs.
План вроде неплох, но одно "но": как передать имя секрета в сабчарты, если на момент запуска оно еще не известно? Немного кода для пояснения
шаблон секрета:
kind: Secret
apiVersion: v1
type: Opaque
metadata:
name: {{ include "efk.fullname" . }}-secret
annotations:
"helm.sh/hook": "pre-install"
"helm.sh/hook-delete-policy": "before-hook-creation"
data:
ELASTIC_USERNAME: ZWxhc3RpYw==
ELASTIC_PASSWORD: {{ randAlphaNum 12 | b64enc }}
кусок values.yaml родительского чарта:
elasticsearch:
# Values reference: https://github.com/elastic/helm-charts/tree/master/elasticsearch
replicas: 1
esConfig:
elasticsearch.yml: |
xpack.monitoring.collection.enabled: true
xpack.security.enabled: true
xpack.security.authc.reserved_realm.enabled: true
xpack.security.http.ssl.enabled: false
xpack.security.transport.ssl.enabled: false
extraEnvs:
- name: ELASTIC_PASSWORD
valueFrom:
secretKeyRef:
name: ЗДЕСЬ ДОЛЖНО БЫТЬ ИМЯ СЕКРЕТА
key: ELASTIC_PASSWORD
- name: ELASTIC_USERNAME
valueFrom:
secretKeyRef:
name: ЗДЕСЬ ДОЛЖНО БЫТЬ ИМЯ СЕКРЕТА
key: ELASTIC_USERNAME
Andrey
Ребят, может что-то посоветуете, голову уже сломал
Короче пилю EFK чарт, с сабчартами - elasticsearch и kibana (официальные чарты от эластика). Чтобы можно было весь комбаин разворачивать одинм движением. По непонятным для меня причинам, ни эластик ни кибана не создают своих секретов с логин-паолем, но зато ожидают переменных с этими данными. Для этого у них есть extraEnvs. В общем задача выглядит так: создаем секрет в родительском чарте, генерируя имя из релиза, неймспейса и т.д. и пароль внутри секрета, и линкуем переменные в сабчарты, через extraEnvs.
План вроде неплох, но одно "но": как передать имя секрета в сабчарты, если на момент запуска оно еще не известно? Немного кода для пояснения
шаблон секрета:
kind: Secret
apiVersion: v1
type: Opaque
metadata:
name: {{ include "efk.fullname" . }}-secret
annotations:
"helm.sh/hook": "pre-install"
"helm.sh/hook-delete-policy": "before-hook-creation"
data:
ELASTIC_USERNAME: ZWxhc3RpYw==
ELASTIC_PASSWORD: {{ randAlphaNum 12 | b64enc }}
кусок values.yaml родительского чарта:
elasticsearch:
# Values reference: https://github.com/elastic/helm-charts/tree/master/elasticsearch
replicas: 1
esConfig:
elasticsearch.yml: |
xpack.monitoring.collection.enabled: true
xpack.security.enabled: true
xpack.security.authc.reserved_realm.enabled: true
xpack.security.http.ssl.enabled: false
xpack.security.transport.ssl.enabled: false
extraEnvs:
- name: ELASTIC_PASSWORD
valueFrom:
secretKeyRef:
name: ЗДЕСЬ ДОЛЖНО БЫТЬ ИМЯ СЕКРЕТА
key: ELASTIC_PASSWORD
- name: ELASTIC_USERNAME
valueFrom:
secretKeyRef:
name: ЗДЕСЬ ДОЛЖНО БЫТЬ ИМЯ СЕКРЕТА
key: ELASTIC_USERNAME
передать имя секрета нельзя, в values поддерживаются только литералы. Вообще вся эта ерунда с сабчартами работает только в очень простых случаях, какие-то сложные зависимости надо ставить руками.
Антон
ну я собственно говоря уже пришел к такому выводу, но была надежда... мда. спс