Алексей


посмотрел iscsi
codes.Unimplemented, "", в половине вызовов
hostpath
ну типа демо, смотрите как мы можем
или весь csi это flex для себя напилил и на этом все закончилось?
Алексей
Собственно откуда вопрос:
стоит provisioner iscsi, через targetd он спокойно создает создает удаляет диски, ну и в общем работает, но
функционала по ресайзу дисков нет, а хочется.
смотрю что можно с этим сделать, в targetd впилить функционал проблем особых нет, там пара часов работы
но придется еще править сам провизионер а это уже сильно дольше там уже придется добавлять ds для релоада iscsi таргетов и ресайза файлухи, в общем временные затраты сильно подскакивают
может я какието варианты упустил по незнанию?
Алексей
csi вроде выглядит логично, и типа этот вариант предполагается в будующем как основной
но чет по коду плагинов все совсем печально.
 Евгений
Не слышал, чтобы кто-нибудь iscsi использовал всерьёз
 NM
Не слышал, чтобы кто-нибудь iscsi использовал всерьёз
Я использую и использовал. Достаточно надежное решение в отличие от СХД в виде подключаемых PV в качестве тома
NM
Не забывайте что это еще и кластер - отказоустройчивые тома которые можно в случае необходимости переключить на другие ноды
Антон
Не забывайте что это еще и кластер - отказоустройчивые тома которые можно в случае необходимости переключить на другие ноды
А еще не забываем, что это сеть, и у нее потеря пакетов - это норма... ну и еще куча мелких подводных камней
NM
А еще не забываем, что это сеть, и у нее потеря пакетов - это норма... ну и еще куча мелких подводных камней
Это меньшее зло чем с полочками.
Антон
Это меньшее зло чем с полочками.
Не согласен. Все зависит от задачи. Если у меня на бд будут теряться пакеты при записи в журнал транзакций - никакие плюсы iscsi не перевесят :)
Алексей
если у вас потери пакетов между нодами, то любое сетевое хранилище накрывается медным тазом, да и в принципе сам кластер тогда довольно смутное понятие
ceph это минимум 5 нод + желательно иметь человека который его умеет готовить, в общем решение не для маленьких кластеров
linstor наверно имеет смысл
но в моем кэйсе у меня есть вполне себе надежное хранилище и 6 гигабит от него до нод
Алексей
iscsi очень старое, и протестированное решение
ну и собственно почему бы его не использовать если оно подходит
Egor
кто шарит в PV и d PVС, оч нужно пояснение по взаиможействию с statefulsets
 Solyar
Persistent Volume Claims ушел в Pending, в деталях пусто просто
Stateful Sets - 0\3
Какой провижинер используете?
Solyar
Или это локальные волюмы?
Egor
может я лось =) но чет не взлетает =(
Solyar
локальные, без коннекта куда либо.
Тогда тут два варианта. Либо у вас провижинер локальный не работает и надо ручками создавать PV / PVC или неправильный сторажкласс используете
Solyar
А если еще из хельм чарта поставили то 90% проблема в этом
Egor
А если еще из хельм чарта поставили то 90% проблема в этом
ставил вот от сюда —> https://github.com/kelseyhightower/consul-on-kubernetes
Egor
там PV и PVC не были прописаны.
Egor
мудрил сам, скорее всего из за этого =)
Solyar
ставил вот от сюда —> https://github.com/kelseyhightower/consul-on-kubernetes
В SS прописан claim template
Solyar
в общем создайте руками PV с подходящей конфигурацией и задеплойте стейтфулсет
Solyar
Всё будет работать
Egor
в общем создайте руками PV с подходящей конфигурацией и задеплойте стейтфулсет
а можно поподробнее пожалуйста, что значит с подходящей конфигурацией?:)
Solyar
а можно поподробнее пожалуйста, что значит с подходящей конфигурацией?:)
тип ReadWriteOnce
размер 10Gi
 Konstantin
Я использую и использовал. Достаточно надежное решение в отличие от СХД в виде подключаемых PV в качестве тома
А потом приходит омномном и сносит iscsid
Solyar
Если использовать провижинер, клейм делает запрос, получает место и монтирует PV. А провижинера нет, так что придется ручками создать PV чтобы он его зацепил
Алексей
@shinkei ну отключи oom для iscsid, и пусть тогда он хоть заприходится
Konstantin
Вы видимо уже это делаете :) Доброго утра всем.
Алексей
ну и даже если он будет прибит
что дальше произойдет?
NM
Не согласен. Все зависит от задачи. Если у меня на бд будут теряться пакеты при записи в журнал транзакций - никакие плюсы iscsi не перевесят :)
У меня лет 10 ничего не теряется как перешел в облаках на использование ISCSI
NM
Но конечно же если ZFS то это полочка это понятно под локальную молотилку под DB2/Oracle - (AIX/OS400 и тому подобное) - но это и не облака а локальный ЦОД
NM
ну и даже если он будет прибит
что дальше произойдет?
Ничего страшного - будет работать на втором адресе
Алексей
протоколу > 20 лет
первая реализация была по моему в 1998 году
есть очень большое подозрение, что раньше сдохнет etcd вместе с кубером чем я увижу какието фатальные проблемы с iscsi
@corsars77 ну собственно да ))
вопрос был к @shinkei
NM
протоколу > 20 лет
первая реализация была по моему в 1998 году
есть очень большое подозрение, что раньше сдохнет etcd вместе с кубером чем я увижу какието фатальные проблемы с iscsi
@corsars77 ну собственно да ))
вопрос был к @shinkei
Да вот кстати - тема бэкапа etcd встает остро и загона его в кластер
Алексей
а в чем проблема загона в кластер?
Алексей
сейчас как внешний, а хочется загнать в control plane?
NM
да никаких пока не было - даже демон работает вместе с соседом в поде etcD нормально. Там только вопрос включения и выключения в схеме когда нода умерла
NM
именно момент выбора политики включения еще одного после падения ноды (третьего то есть) - кто будет включать и как поднимать второй узел через cloudInit вместо упавшего узла - но это детали
NM
сейчас как внешний, а хочется загнать в control plane?
и это тоже через -experimental-control-plane
Алексей
конкретизируй примером
не очень понятно
типа
был кластер etcd из 3 нод
одна нода сдохла (вернее сами выключили)
выкинули эту ноду из кластера, добавили новый хост, ввели его в кластер
 Валентин
конкретизируй примером
не очень понятно
типа
был кластер etcd из 3 нод
одна нода сдохла (вернее сами выключили)
выкинули эту ноду из кластера, добавили новый хост, ввели его в кластер
ну видимо хочется чтоб если сдохла - то не руками дальше, а скриптом новую ноду поднять с etcd. Я так из его сообщения понял
Egor
Если использовать провижинер, клейм делает запрос, получает место и монтирует PV. А провижинера нет, так что придется ручками создать PV чтобы он его зацепил
сейчас картина вот такая
Events - (pod has unbound immediate PersistentVolumeClaims (repeated 6 times))
Stateful Sets - тоже самое.
хотя Access Modes прописан ReadWriteOnce
а PV
Persistent Volumes
name - consul
Capacity - 10Gi
Access Modes - ReadWriteOnce
Reclaim Policy - Retain
Status - Available
Storage Class - manual
Solyar
сейчас картина вот такая
Events - (pod has unbound immediate PersistentVolumeClaims (repeated 6 times))
Stateful Sets - тоже самое.
хотя Access Modes прописан ReadWriteOnce
а PV
Persistent Volumes
name - consul
Capacity - 10Gi
Access Modes - ReadWriteOnce
Reclaim Policy - Retain
Status - Available
Storage Class - manual
Я думаю нужно просто почитать про работу PV / PVC. Я просто устану обьяснять :)
Алексей
@es1vanov ну почитай уж доки
Алексей
там логика на уровне 1 класа
Egor
пошел грызть , всем спс. =)
NM
конкретизируй примером
не очень понятно
типа
был кластер etcd из 3 нод
одна нода сдохла (вернее сами выключили)
выкинули эту ноду из кластера, добавили новый хост, ввели его в кластер
ну все проще 2 мастера + 10-15 нод условно говоря. С нодами не так страшно (workers) - если упадут то там реплика будет работать. А вот с мастером если узел один падает - надо поднимать второй уже. Вот тут момент переключения (shceduler в том числе) и интересен - чтобы не платить за третий узел поднимать его когда падает один из мастеров например.
NM
сейчас картина вот такая
Events - (pod has unbound immediate PersistentVolumeClaims (repeated 6 times))
Stateful Sets - тоже самое.
хотя Access Modes прописан ReadWriteOnce
а PV
Persistent Volumes
name - consul
Capacity - 10Gi
Access Modes - ReadWriteOnce
Reclaim Policy - Retain
Status - Available
Storage Class - manual
PV + CLAIM + StorageCLass - по трем сущностям пройтись согласно доке - выше уже написали все просто
Алексей
2 мастера ))
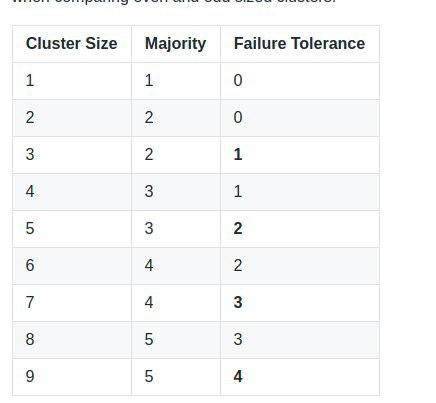
https://github.com/etcd-io/etcd/blob/master/Documentation/v2/admin_guide.md
Fault Tolerance Table
посмотри
Алексей
если совсем денег жалко, ставь вообще 1 ноду и бэкапь etcd
либо ставь 3
Валентин
ну все проще 2 мастера + 10-15 нод условно говоря. С нодами не так страшно (workers) - если упадут то там реплика будет работать. А вот с мастером если узел один падает - надо поднимать второй уже. Вот тут момент переключения (shceduler в том числе) и интересен - чтобы не платить за третий узел поднимать его когда падает один из мастеров например.
с двумя всегда есть риск сплитбрейна, так что не выйдет не платить за 3
NM
2 мастера ))
https://github.com/etcd-io/etcd/blob/master/Documentation/v2/admin_guide.md
Fault Tolerance Table
посмотри
Дык это понятно 😉 А вот упал один - надо поднять третий - вот тут через ansible и нужно разлить третий вместо второго. Пока в строй ввести его непросто так чтобы в случае ложных тригеров не ввыводить потом
 Tuntsov
А в двух мастерах etcd переходит в ro?
NM
с двумя всегда есть риск сплитбрейна, так что не выйдет не платить за 3
Да можно вообще тогда API + etcD ограничитьcя в рамках виртуалки и поднимать
Алексей
ну и вообще
малое кроилово ведет к боьшому попадалову
NM
А в двух мастерах etcd переходит в ro?
если нода одного мастера будет недоступна по дискаверу то да будет RO 😉 смотрю поэтому https://github.com/etcd-io/discovery.etcd.io
Алексей
ладно, тут весело, но похоже с ресайзом для iscsi все глухо
и нужно либо самому допилить то что есть
либо закостылить башем и забить
NM
Ну там же командочка была - если инициатор не получил команду то resize не пройдет. У тебя GKE там или AWS ?
Алексей
Железо
Алексей
сам провизионер iscsi не понимает ресайз, в нем этой реализации нет
и в targetd тоже
для того чтоб отрезайзить, нужно в targetd сделать lvextend
далее на той ноде куда примонтирован блоб сделать релоад таргета и отресайзить файлуху
ну и собственно либо поправить targetd + поправить провизионер + добавить ds который при изменении pvc будет релоадить таргет на нужной ноде и ресайзить файлуху
либо дописать эту реализацию в iscsi csi плагине
ну можно впринципе, но я потрачу на это от пары дней до недели
время = деньги, а за это мне явно не заплатят.
NM
давайте снинемся и все заплатим Алексей ?
NM
 Алексей
забавно ))
думаю это лучше предложить студентам вузов в качестве дипломного проекта
будет и полезно для прокачки скилов, и бонус в виде кода который можно показать будующим работодателем
думаю тот же redhat вполне заинтересуется таким студентом.
Алексей
golang
grpc
kubernetes
iscsi
csi
тут перечня технологий более чем достаточно для неплохого резюме
NM
кхе кхе 😉
Solyar
Solyar
grpc тоже
 George
Там рафт
George
У тебя тупо при отказе одного кластер выход из строя
George
При 3 - один отказал - два осталось. Два больше половины - все ок
Solyar