а вот по хард-вею было бы неплохо, тащемта
А что кроме хардвея то?
 Михаил


 Anton
 Andrey
А какие были? Я просто не очень понял проблему
Просто хрень полезная https://kubernetes.io/docs/reference/access-authn-authz/extensible-admission-controllers/
 Riv
Доброго дня.
Есть такая проблема, имеется кластер в AWS запущенный когда-то давно с помощью kops.
В текущий момент версия сервер v1.11.9
Есть поды которые подключаются к AWS EFS.
С недавних пор начала происходить такая фигня, при создании новых подов (обычно деплое приложения), получаются вот такие ошибки о том что не получается подключиться новые разделы.
Никаких особых предпосылок я к этому не вижу, особенно при том что в этот момент на той же ноде работают остальные поды подключённые к тому же EFS эндпоинту.
kubelet[2158]: E1210 09:01:27.456248 2158 kubelet.go:1612] Unable to mount volumes for pod "app-5997bb4d58-h7dck_production(0374778a-1b2b-11ea-9113-0ab9d5d544b8)": timeout expired waiting for volumes to attach or mount for pod "production"/"app-5997bb4d58-h7dck". list of unmounted volumes=[logs data-backup]. list of unattached volumes=[logs data-backup default-token-nfjkj]; skipping pod
kubelet[2158]: E1210 09:01:27.456327 2158 pod_workers.go:186] Error syncing pod 0374778a-1b2b-11ea-9113-0ab9d5d544b8 ("app-5997bb4d58-h7dck_production(0374778a-1b2b-11ea-9113-0ab9d5d544b8)"), skipping: timeout expired waiting for volumes to attach or mount for pod "production"/"app-5997bb4d58-h7dck". list of unmounted volumes=[logs data-backup]. list of unattached volumes=[logs data-backup default-token-nfjkj]
Riv
После этих ошибок вываливается stacktrace от mount.nfs, но и с его помощью не получается раскопать истинную причину.
kernel: [16068718.482673] mount.nfs D 0 22247 22246 0x00000000
kernel: [16068718.484113] ffff8f651c77b800 0000000000000000 ffff8f689507e280 ffff8f6922718980
kernel: [16068718.486088] ffff8f68fe836340 ffffb06e054a39c8 ffffffffb5e0fed9 ffff8f69229fbcc0
kernel: [16068718.488086] 0000000200000000 ffff8f6922718980 c31fe880c9142772 ffff8f689507e280
kernel: [16068718.490082] Call Trace:
kernel: [16068718.490752] [<ffffffffb5e0fed9>] ? __schedule+0x239/0x6f0
kernel: [16068718.492179] [<ffffffffb5e103c2>] ? schedule+0x32/0x80
kernel: [16068718.493499] [<ffffffffb5e1066a>] ? schedule_preempt_disabled+0xa/0x10
kernel: [16068718.495144] [<ffffffffb5e120c4>] ? __mutex_lock_slowpath+0xb4/0x130
kernel: [16068718.496720] [<ffffffffb5e1215b>] ? mutex_lock+0x1b/0x30
kernel: [16068718.498055] [<ffffffffc0690a44>] ? nfs4_discover_server_trunking+0x44/0x2a0 [nfsv4]
kernel: [16068718.499961] [<ffffffffc06946b2>] ? nfs_callback_up+0x182/0x470 [nfsv4]
kernel: [16068718.501608] [<ffffffffc0698bf0>] ? nfs4_init_client+0x120/0x2a0 [nfsv4]
kernel: [16068718.503284] [<ffffffffc0571361>] ? __fscache_acquire_cookie+0x61/0x150 [fscache]
kernel: [16068718.505121] [<ffffffffc03bc2fb>] ? __rpc_init_priority_wait_queue+0x7b/0xb0 [sunrpc]
kernel: [16068718.507065] [<ffffffffc0698964>] ? nfs4_alloc_client+0x1b4/0x1c0 [nfsv4]
kernel: [16068718.508752] [<ffffffffc05db5c5>] ? nfs_get_client+0x2c5/0x3b0 [nfs]
kernel: [16068718.510341] [<ffffffffc06981d1>] ? nfs4_set_client+0xb1/0x140 [nfsv4]
kernel: [16068718.511971] [<ffffffffb59a61df>] ? wb_init+0x18f/0x220
kernel: [16068718.513281] [<ffffffffc06996da>] ? nfs4_create_server+0x12a/0x360 [nfsv4]
kernel: [16068718.514983] [<ffffffffc06913f8>] ? nfs4_remote_mount+0x28/0x50 [nfsv4]
kernel: [16068718.516613] [<ffffffffb5a0badb>] ? mount_fs+0x3b/0x160
kernel: [16068718.517924] [<ffffffffb5a293c2>] ? vfs_kern_mount+0x62/0x100
kernel: [16068718.519374] [<ffffffffc069132f>] ? nfs_do_root_mount+0x7f/0xc0 [nfsv4]
kernel: [16068718.520988] [<ffffffffc06916df>] ? nfs4_try_mount+0x3f/0xc0 [nfsv4]
kernel: [16068718.522563] [<ffffffffc05dc2f1>] ? get_nfs_version+0x21/0x80 [nfs]
kernel: [16068718.524125] [<ffffffffc05e8f77>] ? nfs_fs_mount+0x6f7/0xd60 [nfs]
kernel: [16068718.525669] [<ffffffffc05e86d0>] ? nfs_clone_super+0x120/0x120 [nfs]
kernel: [16068718.527262] [<ffffffffc05e7160>] ? param_set_portnr+0x70/0x70 [nfs]
kernel: [16068718.528831] [<ffffffffb5a0badb>] ? mount_fs+0x3b/0x160
kernel: [16068718.530135] [<ffffffffb5a293c2>] ? vfs_kern_mount+0x62/0x100
kernel: [16068718.531578] [<ffffffffb5a2b87f>] ? do_mount+0x1cf/0xc60
kernel: [16068718.532897] [<ffffffffb5a09a01>] ? __fput+0xc1/0x220
kernel: [16068718.534160] [<ffffffffb5a2c63e>] ? SyS_mount+0x7e/0xd0
kernel: [16068718.535491] [<ffffffffb5803b7d>] ? do_syscall_64+0x8d/0xf0
kernel: [16068718.536897] [<ffffffffb5e14c4e>] ? entry_SYSCALL_64_after_swapgs+0x58/0xc6
Может кто-то встречал подобное раньше и может подсказать решение?
 Andrey
 Дмитрий Харитонов
почему flanneld может собирать логи только с одной поды?
Антон
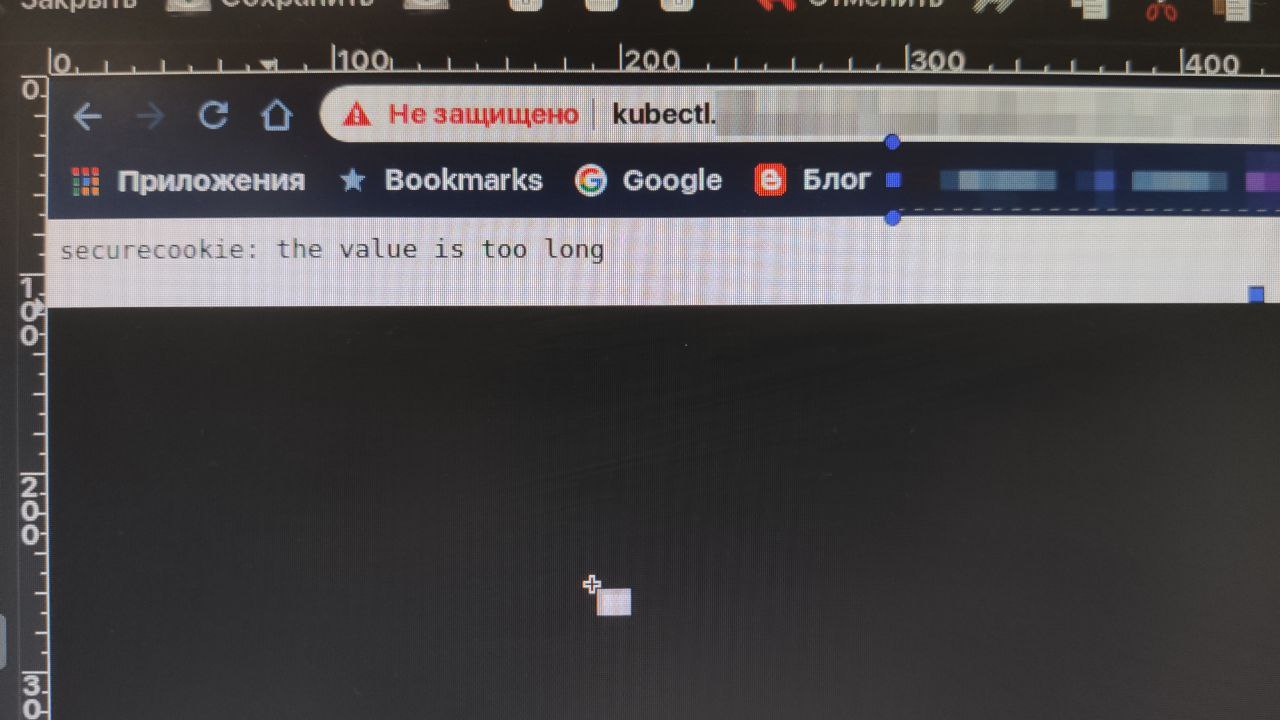
Поднимаю dex+ganway, делал по инструкции + видео (слерм-мега). Авторизация проходит, но конфиг (следующий шаг после авторизации в ldap) для подключения к кластеру не выдает, после ввода логина ошибка: securecookie: the value is too long
Антон
 Антон
Что-то забыл?
 Igor
Думаю группе может быть интересно: коротко о проекте Армада (разворачивание множества кластеров в облаке) и что мы использовали для создания IBM Managed Kubernetes https://habr.com/ru/company/ibm/blog/479664/
 Dmitry
Появилась уже какая-то статистика по этому поводу?
Или никто так и не ответил?
🤷♂️. Вроде кто-то юзает, но при каких rps и сколько это все кушает не говорят. @Sn00p ты вроде писал, что istio используешь в проде. Можешь поделиться инфой? Сколько там rps/трафика на приложения, сколько istio кушает памяти и cpu по всему кластеру? Как проблему с увеличением latency решал и т.д.
Михаил
Просто хрень полезная https://kubernetes.io/docs/reference/access-authn-authz/extensible-admission-controllers/
Думаешь в это надо уметь всем?
Andrey
Думаешь в это надо уметь всем?
Я знаю, что упоротый, но все-таки скажу, что да - в кастомизабельности и есть основной плюс кубеней
Sn00part
🤷♂️. Вроде кто-то юзает, но при каких rps и сколько это все кушает не говорят. @Sn00p ты вроде писал, что istio используешь в проде. Можешь поделиться инфой? Сколько там rps/трафика на приложения, сколько istio кушает памяти и cpu по всему кластеру? Как проблему с увеличением latency решал и т.д.
инет гавно, я в дороге, завтра напомни плз
Andrey
Думаешь в это надо уметь всем?
Ну и честно - статей "как взять в руки кубеадм и зафигачить кубеня" на хабре как конь наеб, да и не только там. А вот хард-вей и кастомизация - тут инфы маловато
 George
 Fedor
Ребят подскажите, сделал много сервисов где деплой происходит по образу с тэгом develop (сам тэг не меняется). Imagepullpolicy работал для делоймента, а для стейтфулсета не работает. Как быть?
Fedor
Не выкачивает новое образы на воркерах
Fedor
Костыли лепить не хочу в обход, думаю решение уже есть
 Mikhail
Использовать уникальный тэг?
 Igor
у кого-то бывало что при установке докера как здесь (https://kubernetes.io/docs/setup/production-environment/container-runtimes/#docker) с apparmor (он по-умолчанию ставится в этой установке). Apparmor начинал мешать kubelet работать с контейнерами ?
Fedor
Использовать уникальный тэг?
Тэги как по мне нужны для продакшн, а для стейджей препрода нужно название веток
Mikhail
Тэги как по мне нужны для продакшн, а для стейджей препрода нужно название веток
Ветки в СКВ, а мы вроде про контейнеры?
 Игорь
Тэги как по мне нужны для продакшн, а для стейджей препрода нужно название веток
название ветки можно и в аннотацию запихать
Fedor
Хмм, крч. Я собираю образы в гитлабе пушу в регистери из пайплайна, механизм сборки для прода отличается от сборки под стейджи
Mikhail
В гитлабе, в качестве тэга можно использовать CI_COMMIT_SHORT_SHA для дев контейнеров
Sn00part
поправка! SHIT_SHA ))
Fedor
Знаю, ты предлагаешь вариант при котором у меня регистери задохнётся через неделю из за большого кол-во имеджей
 Alexander
сайт minikube лежит.... может, потому, что у них новый релиз вышел...
https://minikube.sigs.k8s.io/docs/start/linux/
наверно, это - показательно... не держат нагрузку, хотя сами типа профи в кубернейтесе
Anatoly
Не лежит
Mikhail
Знаю, ты предлагаешь вариант при котором у меня регистери задохнётся через неделю из за большого кол-во имеджей
А зачем вы так много билдите?
Игорь
сайт minikube лежит.... может, потому, что у них новый релиз вышел...
https://minikube.sigs.k8s.io/docs/start/linux/
наверно, это - показательно... не держат нагрузку, хотя сами типа профи в кубернейтесе
нет, просто IP плохой попался: https://isitblockedinrussia.com/?host=minikube.sigs.k8s.io
 Victor
Только сегодня написал скрипт для чистки регистри от старых тэгов)
Mikhail
Разработка должна вестись локально, а если разработка идёт в парадигме кубика, то можно использовать локальный реджестри
Fedor
А зачем вы так много билдите?
Хмм, хороший вопрос. Окружений становится все больше и больше из за этого различные версии должны быть
Fedor
Под версии как раз подходят бранчи
Victor
На основе чего?
Придумал нумерацию в своей репе в виде ${SHORT_SHA}_v${num}. И удаляю все тэги кроме 5 последних через registry api v2. Bash + curl + jq
Mikhail
Придумал нумерацию в своей репе в виде ${SHORT_SHA}_v${num}. И удаляю все тэги кроме 5 последних через registry api v2. Bash + curl + jq
А по апи на основе даты, есть вариант? Чтоб без нумерации
Victor
Потом для nexus запилю по времени добавления (его апиха может рассказать). 5 последних по времени
Victor
У нексуса апиха может вернуть время изменения и последнего скачивания. Отсюда можно плясать
NM
Fedor
Я придумал хак тупее, можно в мету добавлять время деплоя каждый раз будет ходить и пулить и не меняя тэг
Igor
Раньше это бывало - сносить его надо.
ее, вот и я чет психанул и снес. Но я не понял почему в дефолтной раскатке такое произошло. И почему в инструкциях у кубера ничего про это не было
Fedor
Ещё не пробовал, но думаю сойдёт
NM
ее, вот и я чет психанул и снес. Но я не понял почему в дефолтной раскатке такое произошло. И почему в инструкциях у кубера ничего про это не было
Ее надо правильно сносить - еще политики где то остаются в /etc/
NM
Я придумал хак тупее, можно в мету добавлять время деплоя каждый раз будет ходить и пулить и не меняя тэг
Там еще же можно label играть не только по горизонтали но и по вертикали - улавливаешь ? то есть теггировать еще и по среде (ландшафту)
Igor
Ее надо правильно сносить - еще политики где то остаются в /etc/
ansible victim -i hosts.yaml -m shell -a "/etc/init.d/apparmor stop" --become
ansible victim -i hosts.yaml -m shell -a "/etc/init.d/apparmor teardown" --become
NM
update-rc.d -f apparmor remove
NM
rm -Rf /etc/apparmor /etc/apparmor.d/
NM
apt-get remove apparmor -y
NM
update-rc.d -f apparmor remove
NM
на всякий
 Виктор
post-install Executes after all resources are loaded into Kubernetes
Виктор
из доки хелма, не очень понятно что имеют ввиду
Виктор
когда все ямлы по апи передадутся?
 Anton
Sn00part
а настроить же можно !
Sn00part
Telling some customers to disable SELinux is like a 16-year-old asking their parents to buy them beer. They understand why you want them to do it, but they might not listen, and they probably trust you a little less just for asking
Sn00part
а там не селинукс а аппармор отключают, это можно!
Sn00part
селинукс можно настроить, надо прогнать в пермиссив моде и нагенерить audit2allow
Sn00part
просто имейте в виду, если все сетапилось при включенном селинуксе, то просто так выключить его вы уже не сможете. наоборот тоже справедливо, правда в меньшей степени. Про аппармор не знаю, это я сам всегда выключаю.
Sn00part
скорее всего все контейнеры скажут ДОСВИДОС и больше не запустятся
 Dmitry
Ребят подскажите, сделал много сервисов где деплой происходит по образу с тэгом develop (сам тэг не меняется). Imagepullpolicy работал для делоймента, а для стейтфулсета не работает. Как быть?
ImagePullPolicy не будет работать и для деплоя. Если у тебя в в спеке template для пода не поменялся.
В annotations можно image id образа засовывать + always pull policy, то
он будет обновляться только когда он изменился. В итоге получили тот же функционал, что и если бы мы делали теги из коммитов или номера билда, но даже лучше, так как не всегда новый коммит или сборка меняют образ. И при этом мы не спамим в registry миллионом тегов.
Это конечно лучше не делать на проде, но в дев среде вполне можно так жить, проблем с этим не испытывал.
Fedor
Вышло вот так)
- name: Hack Patch for force pull image
shell: >
kubectl patch statefulset -n {{os_project_name}} {{app_name}} -p
"{\"spec\":{\"template\":{\"metadata\":{\"labels\":{\"date\":\"{{ ansible_date_time.epoch }}\"}}}}}"