Неа, пока еще руки не доходят уже как несколько месяцев
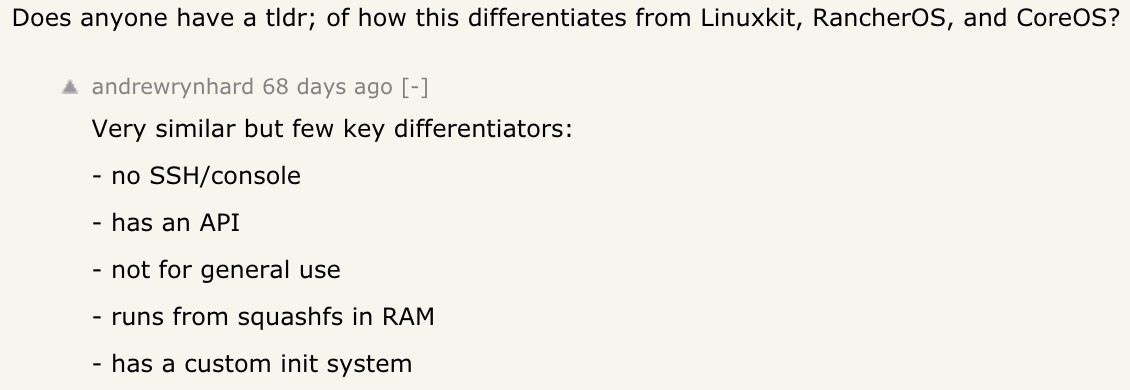
Вот кстать обсуждение этой ОС был на Hacker News, если интересно
https://news.ycombinator.com/item?id=21065272
если мне не изменяет память, эти ребята собирают POWER9 железки )
 Tadeusz


 Denis
если мне не изменяет память, эти ребята собирают POWER9 железки )
А вот чего не знаю, того не знаю)
 Denis
а может просто совпадение https://raptorcs.com/TALOSII/
Скорее всего врятли. Они типа как отдельный старт-ап работают
 Oleh
Привет, кто как делить ресурсы control plaine ноды между etcd и kubelet (бинд процессоров средствами systemd, слайсы например ) ?
 George
В смысле кьюблет ест столько сколько ест. Зачем его ещё как-то зажимать ?
Oleh
не хочу чтобы на etcd страдал
George
А с чего он будет страдать. Ты не деплой на мастер и все будет ок 🤷♂
Oleh
логично, но разное бывает с кубелетом
Oleh
все предидущие кластера я делал без распределения, сейчас делаю новый вот и задамулся о таком извращении
Oleh
значит никто этим особо не заморачиваться? а например такое кто-то практикует
Nice=-10
IOSchedulingClass=best-effort
IOSchedulingPriority=2
Denis
логично, но разное бывает с кубелетом
Нормально кубелет работает, несмотря на то что в него cadvisor встроили. Выделяйте достаточное кол-во ресурсов на все системные компоненты и будет вам счастье. Дока говорит 2ядра и 4 гига памяти и быстрые диски под etc. Подтвержадаю, что все работает нормально и не кто не страдает.
Oleh
тогда и я не буду заморачиваться ))
NM
 Vladimir
Всем привет, а как трафик попадает в ингресс?
У меня похоже проблема до ингресса, так как если я выплевывают порт-форард сервис ингреса то все ок, а на прямую 502 ловлю
 Sergei
Oleg https://kubernetes.io/docs/tasks/administer-cluster/reserve-compute-resources/
best-effort это низкий приоритет, их убьет первыми, если ресурсов не достаточно
Oleh
спасибо, у меня все это настроено, мне было интересно по поводу выдиления etcd конкретных ядер для максимальной производительности
Oleh
я уже понял что по сути все это упирается в диск
George
спасибо, у меня все это настроено, мне было интересно по поводу выдиления etcd конкретных ядер для максимальной производительности
Я тебе более скажу. Не обязательно етсд внутри кубера...
Oleh
он посути не внутри, я использую для него systemd, но ноды теже
Oleh
etcd внутри кубера это не про меня ))
Sergei
--system-reserved= как раз про это
Sergei
тогда kubelet в них не полезет
Petr
Ну вообще мне показалось изи. В последних версиях kubeadm multimaster кластер легко развертывается. Воркеры в кластер добавлять всегда была не сложная процедура.
Я сегодня столкнулся с тем что после добавления новой ноды кубер неожиданно захотел перевезти на неё прометеус, для которого подключен рбд. В итоге возник даунтайм прометеуса больше минуты. Есть ли какой-то бэстпрактис как лучше такое не допускать: приколачивать всё гвоздями к конкретным нодам или ещё как-нибудь?
 𝚔𝚟𝚊𝚙𝚜
Я сегодня столкнулся с тем что после добавления новой ноды кубер неожиданно захотел перевезти на неё прометеус, для которого подключен рбд. В итоге возник даунтайм прометеуса больше минуты. Есть ли какой-то бэстпрактис как лучше такое не допускать: приколачивать всё гвоздями к конкретным нодам или ещё как-нибудь?
Не держать преметеус на rbd для начала?)
Petr
Тут прометеус просто ради примера. А такое может случиться с любым стейтфул.
Denis
Я сегодня столкнулся с тем что после добавления новой ноды кубер неожиданно захотел перевезти на неё прометеус, для которого подключен рбд. В итоге возник даунтайм прометеуса больше минуты. Есть ли какой-то бэстпрактис как лучше такое не допускать: приколачивать всё гвоздями к конкретным нодам или ещё как-нибудь?
Toleration и NodeSelector в помощь к примеру. Я не совсем понял что такое рбд? Это типа блочного устройства в Ceph?
George
А причем тут рбд вообще ?
George
Ну, переехал и переехал
Petr
Как вообще в кубере держат простые стейтфул?
𝚔𝚟𝚊𝚙𝚜
Тут прометеус просто ради примера. А такое может случиться с любым стейтфул.
Как вариант можно настроить eviction policy https://kubernetes.io/docs/tasks/administer-cluster/out-of-resource/#eviction-policy
George
И вообще ты ссзб, что у тебя прометеус в единственном инстансе
George
Даже Чертов оператор ставит прометеуса в трехнодовой конфигурации
𝚔𝚟𝚊𝚙𝚜
То есть вообще ничего на рбд не держать?
Нет, держать на рбд можно и нужно, но рбд для прометеуса, имхо, это оверкилл
Petr
И вообще ты ссзб, что у тебя прометеус в единственном инстансе
Т.е. поднять несколько независимых реплик прометеуса с разными хранилищами? А как потом сливать всё в пром, который вне кластера или через remote write?
George
George
Отказоустойчивость или дедупликацию данных ?
𝚔𝚟𝚊𝚙𝚜
Как вообще в кубере держат простые стейтфул?
В идеальном мире все стейтфулсеты пишутся так чтобы их можно было запускать в нескольких экземплярах и смерть или временная приостановка одного из инстансов не влияет на общую доступность приложения
George
И, да, ты преувеличиваешь проблему с дедупликацией
𝚔𝚟𝚊𝚙𝚜
Т.е. поднять несколько независимых реплик прометеуса с разными хранилищами? А как потом сливать всё в пром, который вне кластера или через remote write?
Как вариант можете Victoria Metrics заюзать
Petr
Отказоустойчивость или дедупликацию данных ?
Мне так, как это принято делать. Чем в целом бесит ИТ-отрасль - так это отсутствием единых стандартов.
George
Мне так, как это принято делать. Чем в целом бесит ИТ-отрасль - так это отсутствием единых стандартов.
Какие стандарты, ты о чем ?
George
Для начала - у всех задачи разные
George
Это раз. Два - ты ж понимаешь, как рубить бабло, когда есть СТАНДАРТ? Надо, чтобы был хаос. Не расстраивайся, а просто прими
George
Не обязательно, кстати, лить в Викторию. Можешь лить в графит. Опять же - отсюда непонятны ограничения твои
𝚔𝚟𝚊𝚙𝚜
Мне так, как это принято делать. Чем в целом бесит ИТ-отрасль - так это отсутствием единых стандартов.
Kubernetes призван решить эту проблему, предоставляя единый интерфейс
George
Kubernetes призван решить эту проблему, предоставляя единый интерфейс
Я более скажу, что в ближайшие 10 лет кубернетес усилит свои позиции как стандарт. Как стандартная операционная среда для кластеров и дц 😭
George
Это не плохо и не хорошо, просто данность
Petr
Я более скажу, что в ближайшие 10 лет кубернетес усилит свои позиции как стандарт. Как стандартная операционная среда для кластеров и дц 😭
Ага, вот это и пугает. Так как очень много очевидных вещей, которых нет в свежеустановленном кластере приходится допиливать.
George
Дефолты говно
George
Нормального дистриба нет и не будет
George
И, да, это заговор облаков . Точно
Petr
Нормального дистриба нет и не будет
Я немного глянул на опеншифт - там вроде многое уже по дефолту настроено
George
Я немного глянул на опеншифт - там вроде многое уже по дефолту настроено
Только одна проблема.
George
Опеншифт догоняющий по многим параметрам
George
И они переобуваются на ходу.
George
Посмотри ту же историю с ингресс. Пока весь мир уже на ингрессе, в опеншифте все route. И только-только завозят ингресс
 Trurl
а чего такого по дефорту надо (ну кроме метрик)? Ну и ингрес.
𝚔𝚟𝚊𝚙𝚜
Я более скажу, что в ближайшие 10 лет кубернетес усилит свои позиции как стандарт. Как стандартная операционная среда для кластеров и дц 😭
Интересно, никто не пробовал приспособить кубернетес для запуска десктопных приложений, эдакий аналог snap, только более дкларативный
George
Можно голосом ? Например, в личку, если здесь не ок
George
George
Наркоманить - так по полной
Trurl
на винде пока не пойдет )
George
Delo vremeni