Ну если вы говорите, что отдельный namespace не нужен, то вы предполагаете что ваш под с базой, будет использовать limitrange текущего namespace. Соотвесвтенно, вам в текущем namespace придется повысить максимальное количество памяти. Был например раньше у вас max = 1GiB, вам придется сделать max = вся память ноды, куда деплоется база.
+
 George


 G72K
у меня сценарий, когда хост с нодой умирает. надо прочухать как можно быстрее и трафик на умершие контейнеры не роутить
Тут была дискуссия пару недель назад,что абстракция Service/endoints полна проблем, как раз отъехавшую ноду разбирали. Вобщем все плохо, без L3/L7 балансировки и чеков с клиента ничего не выйдет , нужен какой-никакой service mesh
 Nurlan
Andrey
конкретнее, откуда, каким иинструментом, с каким url
NM
дергаю метод для healthcheck, метод отрабатывает
А я дергаю докер и crio на внезапный останов мастера. И получается что с CRIO из 10 ребутов система восстанавливается в 10 случаях с CRIO - docker в этом плане не помнит состояния в 8 случаях чтобы вернуться в рабочий запуск...
G72K
Не вижу смысла давать лишних разрешений, особенно которые влияют на стабильность всей системы. И мой аргумент в том, что запускать БД прибитую к ноде, не во всех случаях дело нескольких строк. И есть случаи когда это требует большего обслуживания, чем бд которая деплоется обычным образом.
Давать лишние разрешения конечно плохо, но если у вас разрешения (psp) уже и так ограничиваются , то добавить systctl элементарно, а если не ограничиваются, то как то странно требовать этих ограничений от деплоя базы, когда деплой приложения может делать все что угодно
 Dmitry
Я не понял мысль про limitrange. Независимо от того, в каком неймспейсе у вас база, если у вас уже есть limitrange, то заранее известно, что надо прибавить к лимитам и реквестам фиксированное значение - размер ноды к которой прибиваем базу. Если limitrange до этого не было , то опять же это сравнение разных фич. В любом случае, модификация всех этих ямлов это несравнимо меньше "кода", чем писать плейбуки ансибла для управления хостами с базами.
"В любом случае, модификация всех этих ямлов это несравнимо меньше "кода", чем писать плейбуки ансибла для управления хостами с базами"
Ну если у вас это так, то какие проблемы то, это прекрасно. Просто я так понял вы утверждаете, что это всегда так. Но например у меня это не так =). IaС управляет не только установкой и инициалицией базы, но и управлением, доступы, конфигурация параметров которые меняются на лету т.д. А для этих задач в куб уже будем оператор тащить например для mysql (или даже писать самому, вменяемых для mysql я не знаю). Я не спорю с утверждением что базы в кубе нельзя/невозможно. Я говорю, что это не во всех случаях проще и лучше, а в некоторых случаях даже может быть больше затрат на обслуживание
G72K
Ну если вы говорите, что отдельный namespace не нужен, то вы предполагаете что ваш под с базой, будет использовать limitrange текущего namespace. Соотвесвтенно, вам в текущем namespace придется повысить максимальное количество памяти. Был например раньше у вас max = 1GiB, вам придется сделать max = вся память ноды, куда деплоется база.
Понял, согласен. Перепутал с resource quota , которая КМК более практичная штука. Но да, если хочется limitrange, наверное придется другой неймспейс. но опять же, судя по вопросам и подходу, вам и так и так приходится нарезать кластер на мелкие namespace , так что процесс готовки скорее всего налажен
Dmitry
Понял, согласен. Перепутал с resource quota , которая КМК более практичная штука. Но да, если хочется limitrange, наверное придется другой неймспейс. но опять же, судя по вопросам и подходу, вам и так и так приходится нарезать кластер на мелкие namespace , так что процесс готовки скорее всего налажен
в resource quota тоже же есть общие лимиты. limits.memory, requests.memory их тоже придется увеличивать на весь namespace. Но там можно разрулить через PriorityClass.
G72K
в resource quota тоже же есть общие лимиты. limits.memory, requests.memory их тоже придется увеличивать на весь namespace. Но там можно разрулить через PriorityClass.
Да придется, но на заранее известное значение и оно потом сразу займётся подом с базой, так что для остальных подов ничего не изменится, как было доступно Х , так и останется . Ну за исключением гонки, когда под с базой пересоздают и обычные поды успевают вклиниться :)
G72K
"В любом случае, модификация всех этих ямлов это несравнимо меньше "кода", чем писать плейбуки ансибла для управления хостами с базами"
Ну если у вас это так, то какие проблемы то, это прекрасно. Просто я так понял вы утверждаете, что это всегда так. Но например у меня это не так =). IaС управляет не только установкой и инициалицией базы, но и управлением, доступы, конфигурация параметров которые меняются на лету т.д. А для этих задач в куб уже будем оператор тащить например для mysql (или даже писать самому, вменяемых для mysql я не знаю). Я не спорю с утверждением что базы в кубе нельзя/невозможно. Я говорю, что это не во всех случаях проще и лучше, а в некоторых случаях даже может быть больше затрат на обслуживание
Бонус куба в том, что большое количество нишевых знаний "закодировано" в логике операторов . Я взглянул в код pg_upgrade.py в postgres-operator, да ни в жизнь я б не учел всех этих нюансов сам :)
George
George
но вся эта атстракция ломается, если те пацантре, которые писали оператор или хельм, накосячили
 Отделение Bereke Bank
Продолжаем срачь про бд в кубере?
Отделение Bereke Bank
 George
и разобраться становится.... чуть более, чем невозможно, т.к. надо тащить знания из кучи разных сфер деятельности
George
Да придется, но на заранее известное значение и оно потом сразу займётся подом с базой, так что для остальных подов ничего не изменится, как было доступно Х , так и останется . Ну за исключением гонки, когда под с базой пересоздают и обычные поды успевают вклиниться :)
правильно говоришь, но зачем такое допускать?
Sergii
Столяров по-моему уже на этот счёт (о БД в кубере) говорил правильные вещи - «можно, но зачем?»
 Solyar
Кто файлбитом в кубере пользуется
Solyar
Есть вопросы
 V 🏴☠️
Ну блдж, задай сразу вопрос
Solyar
Можно ли на каждый деплоймент в выбранном мне неймспейсе создавать индекс, а не запихивать всё в filebeat ?
V 🏴☠️
Да
V 🏴☠️
Через процессоры
V 🏴☠️
Или через autodiscover
Solyar
Читал, но видимо очень плохо. Так и не понял как это реализовать
V 🏴☠️
Зависит от того, кто у тебя контейнеры крутит
V 🏴☠️
Если CRI, то через процессоры, если докер, то можно в автодискавере разрулить
 Andrey Zakharov 🐝
всем привет , есть сервис redis-metrics
есть для него endpoint redis-metrics
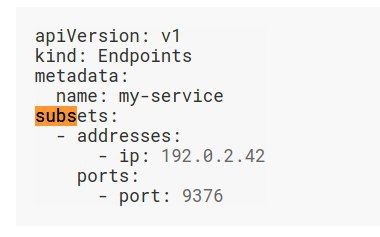
в endpoint'е в subsets указаны 3 subset'а
при обращении к service (через ингресс например) получаю данные от первого subset который указан в endpoint
подскажите плз по какому принципу service выбирает к какому subset в endpoint обращаться ?
в доке найти не смог примеров с несколькоми subset в одном endpoint (возможно плохо смотрел)
George
что такое сабсет?
Andrey Zakharov 🐝
 George
ты имеешь в виду, что там сервис раундробином в бекенды ходит?
Andrey Zakharov 🐝
ага
Andrey Zakharov 🐝
я вобщем использую от bitnami редис хелм чарт
вот он как раз создает 3 пода :
мастер редис
слейв 1 редис
слейв 2 редис
в каждом поде по 2 контейнера - сам редис инстанс и экспортер для него
в итоге получаю один service и один endpoint в котором указаны 3 subset , которые на поды по сути ссылаются
Andrey Zakharov 🐝
оно значит раундробином ходит ?
Andrey Zakharov 🐝
https://github.com/helm/charts/tree/master/stable/redis
Andrey Zakharov 🐝
они там servicemonitor конечно создают ещё
Andrey Zakharov 🐝
но мне надо пока без servicemonitor'а понять как обращаться ко всем
Andrey Zakharov 🐝
т.к у меня прометеус вне кубера
George
сделай прометеус внутри куба и сделай в нем remote_write во внешний
Andrey Zakharov 🐝
сделай прометеус внутри куба и сделай в нем remote_write во внешний
спс , ну вот была как раз такая идея тоже
Terry
то что нужно
Solyar
Не забываем руками репортить за спам :)
Iwan
@kvaps
 Михаил
fxd
 Aleksey
Ребзя, а есть где-то развёрнутый ответ чем бекап спеками хуже бекапа etcd? Чот на первый взгляд экспорт спек это на уровень абстракции выше, а значит и безопаснее (или опаснее).
UPD: мож я что очевидное упускаю? Укажите плиз
Отделение Bereke Bank
Можно ли на каждый деплоймент в выбранном мне неймспейсе создавать индекс, а не запихивать всё в filebeat ?
скорее всего можно в логсташе, но я не пробовал
Типа
index => "%{[kubernetes][namespace]}-%{+YYYY.MM.dd}"
V 🏴☠️
скорее всего можно в логсташе, но я не пробовал
Типа
index => "%{[kubernetes][namespace]}-%{+YYYY.MM.dd}"
Да в файлбите без проблем отбрасывается лишнее
 Rokker
Есть способ быстро просмотреть логи с группы подов с определённой меткой например?
Аля что-то вот такого?
pod1 log-record-1
pod1 log-record-2
pod2 log-record-1
pod3 log-record-1
etc
Чисто для отладки
 Bsod
kubectl logs -l metka=zna4enie?
Rokker
Огонь, этого вполне достаточно
 Lucky SB
Ребзя, а есть где-то развёрнутый ответ чем бекап спеками хуже бекапа etcd? Чот на первый взгляд экспорт спек это на уровень абстракции выше, а значит и безопаснее (или опаснее).
UPD: мож я что очевидное упускаю? Укажите плиз
проведи эксперимент на себе. возьми снепшот etcd И попробуй восстановить кластер на новой площадке
Sn00part
почему нельзя бекапить и так, и так ?
Sn00part
снапшотим етцд а какойнить katafygio все объекты?
Aleksey
проведи эксперимент на себе. возьми снепшот etcd И попробуй восстановить кластер на новой площадке
Со спеками я так уже делал. Но каждый первый гайд советует именно етцд бекапить
Lucky SB
интересно посмотреть на эти хайды
Aleksey
Ну то есть я считаю, что раз сумел без боли мигрировать из гугла в мыло, то это хороший бекап
George
почему нельзя бекапить и так, и так ?
потому что у тебя всякие шифты и ранчеры кучу говна дописывают в твои манифесты
George
ты потом хрен восстановишь
George
просто если у тебя есть норм инфраструктурное репо + бекапы данных - ты легко мигрируешь
George
а со снапшотом...ну, это как сердце на ходу пересаживать
Sn00part
да ну это все решаемо однострочниками на sed
Sn00part
зачем миллион?)
Lucky SB
на каждую проблему по однострочнику
Solyar
Aleksey
просто если у тебя есть норм инфраструктурное репо + бекапы данных - ты легко мигрируешь
Вот да. У меня для всего есть спеки as is. Как показывает опыт — применить их на новое место вообще без проблем. Зачем же тогда бекпить целый сервис?
George
Вот да. У меня для всего есть спеки as is. Как показывает опыт — применить их на новое место вообще без проблем. Зачем же тогда бекпить целый сервис?
потому что у тебя может быть важен порядок
George
например
George
ты юзаешь прометеус сервис монитор
George
а для него в кластере должен быть оператор
Sn00part
так надо вдумчиво применять
Sn00part
kubectl apply -f /*