 George


Который надувает маленькие пузырьки вокруг себя
 Artyom
Я у мамы стеклодув
George
Да
 Отделение Bereke Bank
Вово :) мир стал лучше, когда все сошлись на git, станет ещё лучше когда куб победит ретроградов и станет де-факто платформой для запуска всего
через года 2-3 все эти кубурнетесы будут никому нафиг не нужны 😒 ибо выйдет очередная хайповая залупа
George
А пока хайпим на том, чем можем - раз
George
И через три года кубер будет лингва франка между разрабами и опсами
 Yurii
через года 2-3 все эти кубурнетесы будут никому нафиг не нужны 😒 ибо выйдет очередная хайповая залупа
Или через 20 - 30 как с java ;)
Отделение Bereke Bank
А есть у кого-нибудь хороший дашборд для ETCD метрик?
 Dmitry
тут опять эти споры про базы в кубе. Я лично для себя решил , если тебе приходится прибивать под с базой к ноде через афинити, выставлять максимальный лимит по памяти чтобы его oom не убил, прописывать tollerations, чтобы на эту ноду не залетали другие поды, прокидывать локальные разделы, держать специальные настройки sysctl для этой ноды (кстати чем? , получается тоже костылями через init контейнеры + hostPath и какие нибудь админ capability для ядра , если мы договорились кроме куба ничего не юзать), делать какие-то исключения в psp, а значит ещё и держать это все в отдельном неймспейсе. То на фиг оно мне вообще сдалось. Ну а если ты можешь поднять базу в кубе, и она будет соответствовать всем требованиям и тебе это удобно, то вперёд, почему и нет
Отделение Bereke Bank
Графана?)
она самая) те что на сайте графаны какието скудные. Может у кого есть самодельный с большим кол-вом информации
Отделение Bereke Bank
Суть проблемы - в одном кластере за 1 день набралось 260 max(etcd_server_leader_changes_seen_total)
Для сравнения - в соседнем за 1 год набралось 10. И те видимо из-за ребутов после апдейтов ядра
Не могу найти причину проблемы. У ETCD куча метрик, а вот как понять, визуализировать их в человекопонятный вид - не знаю 😒
George
Реально чего то дохера действий, чтоб затащить базу в куб. Вот и подумаешь - а надо ли оно тебе
++++
 Solyar
Всегда говорю что БД в кубе страшно
George
А бигдата не страшно ? Помнишь knight capital ?
 Leo
Это стейдж, и это не твой прод)
 Dmitry
Это пиздец, сорри
Да, я поэтому и описал что бы потребовалось лично мне, если бы начал тащить базу одного из проектов в куб. @yamlcoder говорит ему удобно и классно, а смысл спорить с ним, если мы не знаем его кейс. Мне такое точно не подходит. А вот у @kvaps, у него отлично базы живут, но у него свой дц, со своими нодами, на нодах есть несколько сетевок, одна из них как минимум 10gbit. Да и вообще полный контроль над сетью,железом и т.д.
George
Да, я поэтому и описал что бы потребовалось лично мне, если бы начал тащить базу одного из проектов в куб. @yamlcoder говорит ему удобно и классно, а смысл спорить с ним, если мы не знаем его кейс. Мне такое точно не подходит. А вот у @kvaps, у него отлично базы живут, но у него свой дц, со своими нодами, на нодах есть несколько сетевок, одна из них как минимум 10gbit. Да и вообще полный контроль над сетью,железом и т.д.
А потом условный @kvaps переезжает в гуголь или амазон
George
И оказывается, что там базы можно взять менеджед
George
И не надо травмировать себя с кубером
George
@SinTeZoiD
 𝚔𝚟𝚊𝚙𝚜
И оказывается, что там базы можно взять менеджед
А где уверенность что cloud provider базы в кубе не запускает?
Как по мне отличный кейс для cloud-provider'а вообще
George
А где уверенность что cloud provider базы в кубе не запускает?
Как по мне отличный кейс для cloud-provider'а вообще
Тебя это не волнует, как клиента
Dmitry
И оказывается, что там базы можно взять менеджед
ну и берёшь managed, в кубе же вроде есть возможность к его апи подключать апи всяких провайдеров, ты в куб отправляешь манифест, а куб трансформирует это в апи вызовы к провайдеру, и бац у тебя настроен условный rds с сервисом и секретами к нему
𝚔𝚟𝚊𝚙𝚜
Dmitry
да, я уже подзабыл.
Отделение Bereke Bank
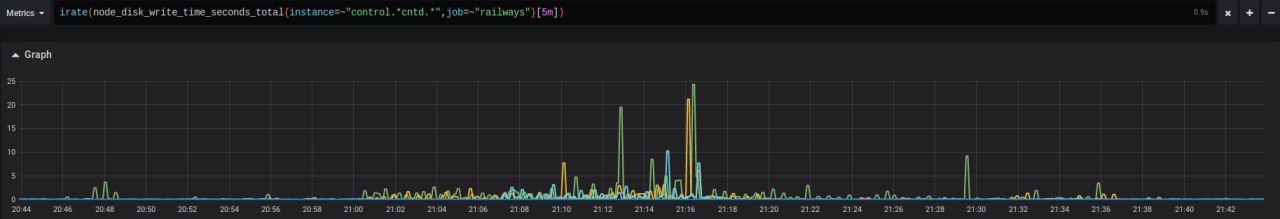
Суть проблемы - в одном кластере за 1 день набралось 260 max(etcd_server_leader_changes_seen_total)
Для сравнения - в соседнем за 1 год набралось 10. И те видимо из-за ребутов после апдейтов ядра
Не могу найти причину проблемы. У ETCD куча метрик, а вот как понять, визуализировать их в человекопонятный вид - не знаю 😒
похоже диски 😑 DO с каждым днем становится все хуже
Отделение Bereke Bank
 Михаил
Я занят
Отделение Bereke Bank
Бухич в воскресенье? 😂
Отделение Bereke Bank
из похожих есть linode и vultr
В такие моменты хочешь свое железо. Теперь доказывать хостеру что ты не даун. Эхх
 Nikita
G72K
И оказывается, что там базы можно взять менеджед
Да амазон не скажу, но CloudSQL в GCP кладет базы на поспать очень регулярно.
 bama^boy
А где уверенность что cloud provider базы в кубе не запускает?
Как по мне отличный кейс для cloud-provider'а вообще
Aws Aurora serverless как раз в каком-нить fargate крутится
G72K
тут опять эти споры про базы в кубе. Я лично для себя решил , если тебе приходится прибивать под с базой к ноде через афинити, выставлять максимальный лимит по памяти чтобы его oom не убил, прописывать tollerations, чтобы на эту ноду не залетали другие поды, прокидывать локальные разделы, держать специальные настройки sysctl для этой ноды (кстати чем? , получается тоже костылями через init контейнеры + hostPath и какие нибудь админ capability для ядра , если мы договорились кроме куба ничего не юзать), делать какие-то исключения в psp, а значит ещё и держать это все в отдельном неймспейсе. То на фиг оно мне вообще сдалось. Ну а если ты можешь поднять базу в кубе, и она будет соответствовать всем требованиям и тебе это удобно, то вперёд, почему и нет
Это выглядит, как много страшных действий для непосвящённых, но мы же знаем,что все это выливается в буквально в десяток строк ямла там сям.
George
Дефайн говно
Говно дефолты означают, что они либо катастрофически неоптимальны, или подготавливают почву для факапа
George
Михаил
bama^boy
 Egor
Так чем там спор кончился на счёт БД в кубернетесе? Кто победил индейцы или ковбои?
Egor
Я вот смотрел презентацию проспонсированную Redhat по поводу БД в kubernetes. Так там была озвучена идея что этот процесс нужно сделать максимально скучным. А вот тут всякие идеи, типо накрутить кучу всего на случай того, что если что-то пойдёт не так, мне кажется это не kubernetes style.
Ну и по поводу контейнеризации это волков бояться в лес не ходить.
Sn00part
работает бд в кубернетесе. но иногда не работает, как и все сервисы, дело такое.
Sn00part
https://cloud.google.com/blog/products/databases/to-run-or-not-to-run-a-database-on-kubernetes-what-to-consider
Отделение Bereke Bank
Мне както достался swarm кластер, в который засунули еще и несколько относительно жирных БД. Рестарты контейнеров приводили к innodb corruption. После этого я решил что в кубере бд у меня не будет 😑
George
ты доклады видел, как все рвется по самому слабому месту и как случаются каскадные отказы?
George
вот сейчас с хайлоада смотрю про аутедж в амазоне
George
Sn00part
ну там статья такая, для девочек )
 Just a baka
спасиб, погляжу
Капитанская обтекаемая статья про базенки без мяса и жести. Чтобы взяли менеджед, наверное 😂
Sn00part
угу
Egor
Мне както достался swarm кластер, в который засунули еще и несколько относительно жирных БД. Рестарты контейнеров приводили к innodb corruption. После этого я решил что в кубере бд у меня не будет 😑
Кто же это всё заставлял рестартить в swarm? И как это связано с kubernetes? И таймаут на выключение БД внутри контейнера не выставляли?
George
я уже теку ))) как девчонка
George
кубернетес .... гугл... хайлоад..... прям оргазм, да?
Dmitry
Это выглядит, как много страшных действий для непосвящённых, но мы же знаем,что все это выливается в буквально в десяток строк ямла там сям.
Но мы же знаем что это не десяток строк ямла. Я рассматривал конкретно свой кейс, и прикинул примерный минимум. Ну если говорите там 10 строк ямла, давайте прикинем, что еще примерно надо будет сделать.
Как я говорил базу придется деплоить в отдельный namespace из-за исключений в psp, к котрому могут иметь доступ только админы кластера, иначе если мы разрешаем hostPath и даем доступ кому попало, то это минимум мы даем рутовый котроль ноды и при должной сноровке можно получить админа кластера, а так как мы тру админы, мы такого позволить себе не можем.
То есть мы имеем отдельные yaml namespace'а, serviceAccount для деплоя, psp, limirange, resourceQuota, netpol, + если деплоем через helm тут еще нужен отдельный tiller со своими ключами, и двумя сертификатами. Не забываем про affinity, tollerations, hostPath, лимиты памяти на всю ноду (ну все что я писал до этого). Что-то я уже чувствую в 10 ямлов не улкадываемся.
Далее, где хранить код этого? Если храним в репе проэкта = те кто имеют доступ к этому проэктому имеют рута ноды (или даже админа кластера, ибо про hostPath не забываем). То есть храним в отдельной репе от проэкта со своим отдельным CI/CD.
Далее в шаблонах yaml'ах куба для этого проекта, будет куча ифов, например: если это прод, то ищи сервис базы вообще в другом неймспейсе, если это прод не создавай сервис для базы и sts для нее, и так далее.
И опять вопрос, а это мне вообще зачем? Чем это лучше обычного выкатвания через ansible/salt/puppet? Я не для таких костылей в куб пришел.
George
если их КТО-ТО до тебя написал - выбор версии
George
а если в них баги (а они точно будут)?