 Etki


унизили вы короче меня своим знанием тервера, пойду плакать
 G72K
1+P1+P2-P1*P2
Скажем вероятность 0.5 в год. С какой вероятностью любая из двух нод вылетит? 1 + 0.5 + 0.5 - 0.25 все равно больше 1 :)
 Евгений
Ээ, 1-0.5-0.5+0.25
Евгений
Это 0.25, оно меньше 1
Etki
(там намекают на то, что P предполагается положительным)
Евгений
????
Евгений
P от 0 до 1
 Dmitry
Полет хотябы одной ноды - это 3 варианта. А полетела, а Б нет. Б полетела, а А нет. Обе полетели. Вот и выходит 2P(1-P)+P^2
Евгений
И 1-P1-P2+P1*P2 всегда будет от нуля от единицы
Dmitry
Оно же -P^2+2P. Таки перевернутая парабола
G72K
И 1-P1-P2+P1*P2 всегда будет от нуля от единицы
У вас написание формулы меняется каждый раз , а раскрывать скобки в уме даже на уровне школы, чтобы увидеть что она одна и так же, я уже не умею. Возьмём вот эту. Она уменьшает вероятность отказа, что не вяжется с интуицией.
Взяли плохие сервера, каждый отказывает с вероятностью 0.5, тогда по вашей формуле суммарная вероятность отказа системы из двух нод будет 0.25, т.е. надёжность улучшилась! Как так? :)
G72K
Какие нафиг 2P? Если P=0.9, то 2P=1.8 Не бывает так в тервере
Когда найдем настоящую формулу, что то мне подсказывает что для маленьких P (которые и встречаются на практике), вероятность будет 2P
Dmitry
Оно же -P^2+2P. Таки перевернутая парабола
При маленьких P P^2 можно пренебречь например, получается чуть меньше, чем 2 P
Марат
тут одни гуманитарии?))
отказы дисков в массивах и прочими штуками никогда не занимались)
Марат
инсайд - формула Бернулли
Марат
если ответ на все вопросы, то 42 ))
Andrey
ударились в тервер?
Dmitry
Это котенок по клавиатуре потоптался =))
Etki
ща я опять поднял ветхие воспоминания о том универе, из которого меня выгнали, и - разве бернулли здесь вообще имеет отношение?
Andrey
вероятность отказа в промежуток времени равна сумме условных вероятностей отказа всех групп нод, которые могут вызвать отказ.
Alexander
Пособеседовался по скайпу.
- Сможете обойти дерево?
- Думаю да
- как будете обходить?
- справа
Hankey
Пособеседовался по скайпу.
- Сможете обойти дерево?
- Думаю да
- как будете обходить?
- справа
интересно, а это где такие вопросы задают?
Anonymous
Etki
Марат
ведущего старославянских обрядов
Etki
 Andrey
Если вероятность отказа одной ноды p, то вероятность отказа кластера из двух нод P = p(1-p) + (1-p)p + pp = 2p - p^2, где p(1-p) - вероятность отказа первой ноды при условии, что вторая работает, (1-p)p - условная вероятность отказа второй ноды, p*p - вероятность отказа двух нод.
Andrey
так что начальный вариант 2p недалёк от правды при малых p
Anonymous
Вся ваша теория ломается от Васяна с коэфициентом в 1 лицо
Andrey
любая теория ломается если построена на предпосылках, не учитывающих фактор Васяна
 Tadeusz
/report
 Fidelina
Ребята, как вы документируете helm-chart ? https://helm.sh/docs/related/
вроде бы должен быть плагин, но не могу его найти
 Andrey
Yaroslav
А имеет ли вообще документировать IaC, использовать какой-нибудь Swagger?
 Evgenii
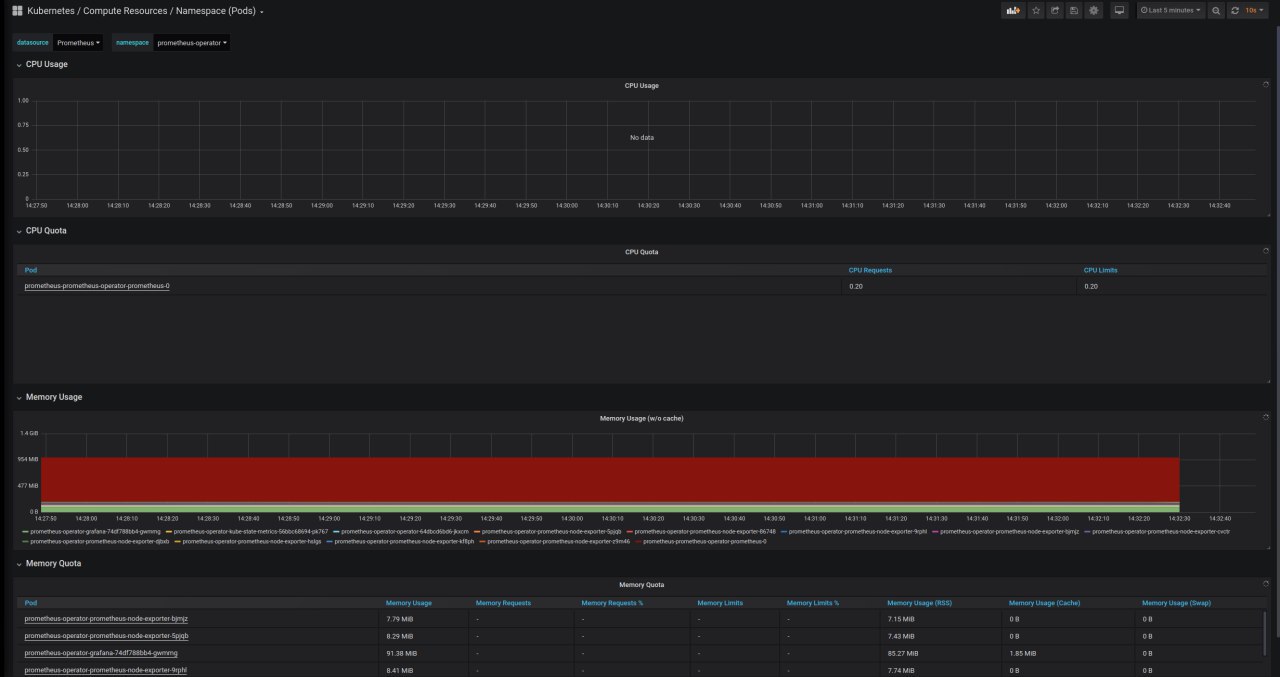
хай всем. Подскажите годные борды для графаны по мониторингу куба
Evgenii
я поставил тут
https://hub.helm.sh/charts/stable/prometheus-operator
там с собой гравфана с предустановленными бордами идёт и чёт они как то не очень работают
Evgenii
 Solyar
И работают все отлично
Й
А для КлаудВотч? Там дефолтные конечно есть, но хоца еще
Может есть у кого?
Alexey
Коллеги, не могу понять, в чем проблема: после перезагрузки ноды kubelet не стартует static-поды, из-за чего не может достучаться до мастера (сыпет ошибками dial tcp 127.0.0.1:6443: connect: connection refused) и зарегистрировать ноду.
Подскажите, пожалуйста, в какую сторону смотреть?
v1.15.3, kubespray. firewall/selinux отключены, манифест nginx-proxy.yml на месте, докер работает.
Solyar
мастер-воркер нода?
Solyar
1 машина?
G72K
Коллеги, не могу понять, в чем проблема: после перезагрузки ноды kubelet не стартует static-поды, из-за чего не может достучаться до мастера (сыпет ошибками dial tcp 127.0.0.1:6443: connect: connection refused) и зарегистрировать ноду.
Подскажите, пожалуйста, в какую сторону смотреть?
v1.15.3, kubespray. firewall/selinux отключены, манифест nginx-proxy.yml на месте, докер работает.
В файле указанном в --bootstrap-config кублета не используйте локальный лоад балансер, пропишите туда один из аписерверов напрямую
Alexey
Нашел проблему: kubelet ругнулся из-за увеличения числа cpu на ВМ после перезагрузки при установленном --cpu-manager-policy=static
policy_static.go:111] [cpumanager] static policy invalid state: current set of available CPUs "0-11" doesn't match with CPUs in state "0-1"
runtime.go:71] Observed a panic: [cpumanager] - please drain node and remove policy state file
Удалил файл стейта - после запустилось.
rm /var/lib/kubelet/cpu_manager_state
Dmitry
Коллеги, а есть способ указать для traefik, который используется в качестве Ingress Controller уже существующий NLB из AWS.
Пробовал добавлять в аннотации "service.beta.kubernetes.io/aws-load-balancer-type: nlb", но контроллер создаёт новый NLB.
Интернеты не дают необходимых знаний.
Alexander
Коллеги, а есть способ указать для traefik, который используется в качестве Ingress Controller уже существующий NLB из AWS.
Пробовал добавлять в аннотации "service.beta.kubernetes.io/aws-load-balancer-type: nlb", но контроллер создаёт новый NLB.
Интернеты не дают необходимых знаний.
Да вроде такой фичи нет и не в Traefik дело, а вообще так реализован Service type=LoadBalancer что к существующим балансировщикам не привязать
Dmitry
Да вроде такой фичи нет и не в Traefik дело, а вообще так реализован Service type=LoadBalancer что к существующим балансировщикам не привязать
Спасибо. Попробую через nodePort в сервисе traefik и указанием этих портов в качестве таргета в лисенерах существующего NLB.
 Aleksey
Кто-нибудь в курсе почему kustomize при наложении патча типа patchesJson6902 и использовании op:add при обновлении массива затирает все элементы массива оставляя только последний добавленный элемент
 Tuntsov
Привет, ребятки. В куберовском мане сказано, что можно добавить мастер ноду с помощью аргумента —control-plane. Но в таком варианте, без LB (типА, хапрокси) не обойтись, видимо. Так ли это?
Tuntsov
https://kubernetes.io/docs/setup/production-environment/tools/kubeadm/ha-topology/
 Roman
Привет, ребятки. В куберовском мане сказано, что можно добавить мастер ноду с помощью аргумента —control-plane. Но в таком варианте, без LB (типА, хапрокси) не обойтись, видимо. Так ли это?
В мане кубере же написано, что можно dns round robin заюзать
 Алексей
есть какой нибудь механизм ограничить скорость с которой плодятся eviction поды или OutOfcpu ?
 Игорь
Привет, ребятки. В куберовском мане сказано, что можно добавить мастер ноду с помощью аргумента —control-plane. Но в таком варианте, без LB (типА, хапрокси) не обойтись, видимо. Так ли это?
если внешнего лб нет, можно на каждую ноду поставить haproxy/nginx и сказать --control-plane-endpoint localhost:6443 (кубспрей так и делает)
Алексей
есть нода 4 cpu
есть другие ноды с большим количеством
делаем деплой с request: 4
прибиваем его на ноду с 4 cpu, он гарантированно не влезает ( служебные тоже кушают)
kubectl apply -> плодаятся OutOfcpu, очень быстро -> имеем проблемы
cpu можно заменить на любой другой preasure (диск проверял, память лениво)
поведение одинаковое на 13 15 16 версиях
какие идеи?
Алексей
ок
нода, впихнуто впихуемое, ночью что то взорвалось пошел диск preasure, под пошел эвиктится, время 1 ночи, через 3 часа ктото понял что что то не в порядке
контрол плэйн лег ( в etcd улутело пара тройка сотен тысяч записей )
такой сценарий?
Алексей
сценарий одинаковый и на cpu и на disk preasure
Алексей
просто на cpu его проще воспроизвести
 Sasha
Насколько обязательно отправлять образ в репозиторий docker, и нельзя ли его хранить где-то локально?
 George
не стоит хранить локально. Опасно. Очень много возможностей выстрелить себе в ногу
Dmitry
Места на все образы не хватит =))
Tuntsov
Насколько обязательно отправлять образ в репозиторий docker, и нельзя ли его хранить где-то локально?
в локальном репозитории)))))))0000
Sasha
не стоит хранить локально. Опасно. Очень много возможностей выстрелить себе в ногу
просто и в гайдах и в книге "Кубернетис в действии" все образы хранятся на docker hub. В проде ведь всё должно быть как-то иначе
Tuntsov
Обычно это Гитлаб реджистри
George
просто и в гайдах и в книге "Кубернетис в действии" все образы хранятся на docker hub. В проде ведь всё должно быть как-то иначе
регистри поднимаешь. Причем максимально близко (физически) к кубернетес кластеру
George
чтоб у тебя не дай Бог от скорости интернета случайно работоспособность кластера не зависела
Alexey
Использовать emptydir для хранения логов - это очень долгий процесс простреливания себе колена. все логи должны идти в стдаут
А можно в двух словах почему это простреливание? Сейчас планируем миграцию на кубер и как переходный вариант как раз emptydir для логов и sidecar с fluentbit.
Но хочется понять что нас ждёт на этот переходный период :)
NM
Насколько обязательно отправлять образ в репозиторий docker, и нельзя ли его хранить где-то локально?
можно. если работать правильно через podman а не докер.
NM
просто и в гайдах и в книге "Кубернетис в действии" все образы хранятся на docker hub. В проде ведь всё должно быть как-то иначе
ну это понятно да. но лучше читать правильную книгу от Марко Лукша несмотря на трудности перевода.
NM
чтоб у тебя не дай Бог от скорости интернета случайно работоспособность кластера не зависела
Вот поэтому я все лоально и храню, раньше в регистру - года 3 назад хранил а теперь как год уже podman позволяет хранить и загружать в контейнеры - а точнее пока через crictl - но это уже на любителя кто любит ынтерпразные решения dockerless 😉
Игорь