 Sergey V


Друзья, все уже создано. через kubectl нужный доступ есть уже
Sergey V
мне нужен токен в дашборд. именно для юзера
 Solyar
А, я видимо не так понял
Sergey V
если токен для юзера невозможно , то буду думать дальше
 Lucky SB
каким образом кубконтрол в API сервер авторизуется ?
Sergey V
))
 A
тебе нужно создать юзера как минимум с правами cluster-admin
 Vadim
если токен для юзера невозможно , то буду думать дальше
зависит от способа аутентификации юзера
Sergey V
стоп стоп.
Sergey V
токен для юзера
A
https://github.com/kubernetes/dashboard/wiki/Creating-sample-user
A
Вот это нужно почитать
A
(я сам страдал из-за этого пару дней назад:))
Sergey V
тут сервис акаунт создается
Vadim
токен для юзера
https://kubernetes.io/docs/reference/access-authn-authz/authentication/#authentication-strategies
Sergey V
у меня есть админский доступ в дашбоард
Sergey V
, мне нужен ограниченный доступ в тот же дашбоард
Vadim
и давайте завязывать с этим смс-стилем, скроллить невозможно
Sergey V
похоже простому юзеру нельзя в токены, нужен сервис аккаунт
https://stackoverflow.com/questions/48022748/is-there-a-way-to-create-a-token-for-a-normal-user-in-kubernetes
Lucky SB
сервис аккаунт и его креды доступа (токен) хранятся в кубе.
для аутентификации юзеров используются внешние средства, юзеры в кубе не хранятся - токенов куба у них нет.
 Fedor
сервис аккаунт и его креды доступа (токен) хранятся в кубе.
для аутентификации юзеров используются внешние средства, юзеры в кубе не хранятся - токенов куба у них нет.
Вроде юзеру можно выписать токен на 24 часа, или это только в шифте?
Sergey V
Вроде юзеру можно выписать токен на 24 часа, или это только в шифте?
а можно подробнее?
( @vrutkovs сорян я не знаю что такое смс-стиль )
Lucky SB
Вроде юзеру можно выписать токен на 24 часа, или это только в шифте?
я не знаю. на ум приходят только bootstrap токены, но они тут врядли подходят
Vadim
Вроде юзеру можно выписать токен на 24 часа, или это только в шифте?
в шифте свой oauth-сервер, да, потому там у юзера гарантированно есть токен. В чистом кубе - зависит от метода аутентификации
Fedor
Sergey V
G72K
Да и сейчас это выглядит отлично и меня, как перфекциониста, все более чем устраивает
Как вы проверяете что скажем одно и то же имя хоста в разных ingress для разных приложений не используется случайно?
 Andrei
Как вы проверяете что скажем одно и то же имя хоста в разных ingress для разных приложений не используется случайно?
Никак. Зачем вообще это нужно? Я знаю где что, дубль точно не вкачу. На крупных проектах спец микросервис выдает все нужные домены при выкатки, так что все в порядке
G72K
Никак. Зачем вообще это нужно? Я знаю где что, дубль точно не вкачу. На крупных проектах спец микросервис выдает все нужные домены при выкатки, так что все в порядке
А,так у вас разрабы только номер образа менять могут? У нас селф сервис,что хотят то творят :) что за микросервис? Как работает?
 Григорий
звучит как meister в одном it агенстве)
Vadim
Микросервис вида Mechanical Turk, с функцией "я знаю где что"
Andrei
А,так у вас разрабы только номер образа менять могут? У нас селф сервис,что хотят то творят :) что за микросервис? Как работает?
image & tag проставляются в CI, зачем их трогать? Просто микросервис который отдает yaml с доменами. Но это актуально только для одного крупого проекта. Все выкатки все равно проходят через меня/коллегу, домены никто менять не будет
Solyar
А у нас банально servicename-version-commit id
Bear
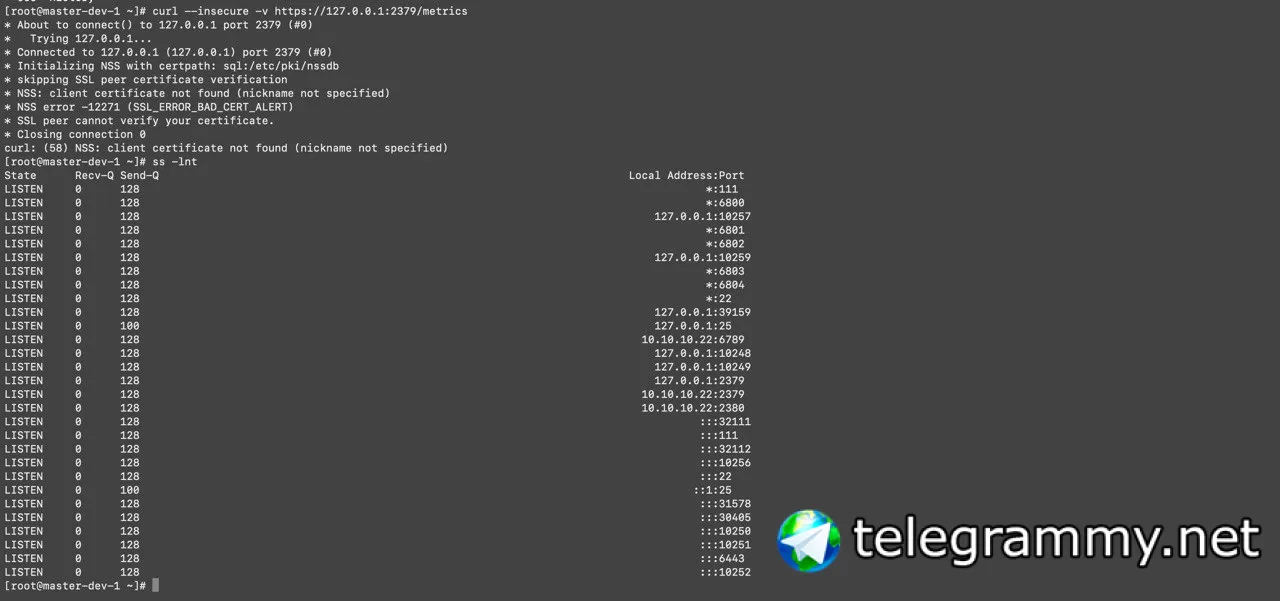
Товарищи добрый день! Помогите вкрутить мониторинг на etcd в кластере.
curl http[s]://127.0.0.1:2379/metrics возращает ошибку, хотя тот же запрос к тестовому etcd в docker'e отрабатывает наура. Что я делаю не так?
Bear
 Just a baka
Товарищи добрый день! Помогите вкрутить мониторинг на etcd в кластере.
curl http[s]://127.0.0.1:2379/metrics возращает ошибку, хотя тот же запрос к тестовому etcd в docker'e отрабатывает наура. Что я делаю не так?
Клиентский сертификат нужен, не все двери открываются по --insecure
Bear
спасибо!
 Slach
А как кубер можно запустить самый примитивный уровень типа бинарниками есть инструкция где-то?
https://github.com/kinvolk/kubernetes-the-hard-way-vagrant
Alexey
Коллеги, столкнулся с проблемой - две ноды (72 cpu) перманентно переходят с состояние NotReady с ошибкой PLEG is not healthy. Происходит это при 200+ запущенных подах на ноде.
Штука в том, что до недавнего времени подобная ошибка не наблюдалась при аналогичном числе подов. Подскажите, в какую сторону смотреть?
 Perfect
Context switches
Perfect
Эта схема не жизнеспособна из за этого)
Perfect
LA в такой момент уходит в космос
Perfect
И cpu system/interrupts
Perfect
Более 90 контецнеров на ноду - жди проблем
Perfect
Надо вместо 2х больших нод 5 маленьких)
Alexey
Мучает вопрос, как оно работало раньше
Just a baka
на жирную ноду можно и квм вхреначить, так-то если. и уплотняться сколько влезет (?)
Perfect
Мучает вопрос, как оно работало раньше
Было меньше активности процессов.
Вообще оно так бывает когда верхний предел не учтен: работало-работало пока не сдохло)
Perfect
на жирную ноду можно и квм вхреначить, так-то если. и уплотняться сколько влезет (?)
Да. Тут выбор виртуализации кто что умеет
Perfect
Упирание количества контейреров не в железо, а в ядро Linux
Perfect
Много виртуалок - разные ядра и всё зашевелится
Vadim
Надо тюнить ядро и container runtime, да. Мы до 250 контейнеров на ноде поддерживаем
Perfect
Путь тюнинга тоже имеет лимиты. И дешевле и проще масштабироватся)
 Евгений
Надо тюнить ядро и container runtime, да. Мы до 250 контейнеров на ноде поддерживаем
А что вы крутите, если не секрет?
Alexey
Vadim
А что вы крутите, если не секрет?
https://docs.openshift.com/container-platform/3.11/scaling_performance/host_practices.html
G72K
Коллеги, столкнулся с проблемой - две ноды (72 cpu) перманентно переходят с состояние NotReady с ошибкой PLEG is not healthy. Происходит это при 200+ запущенных подах на ноде.
Штука в том, что до недавнего времени подобная ошибка не наблюдалась при аналогичном числе подов. Подскажите, в какую сторону смотреть?
У кублета дефолтный лимит 110 подов, вы когда его подкручивали в бесконечность с каким коментом коммит сделали интересно :)
Roman
привет, направьте плиз в правильное направление, как вы создаете тестовые окружения и как потом удаляете?
G72K
привет, направьте плиз в правильное направление, как вы создаете тестовые окружения и как потом удаляете?
Генерируются имена с префиксом, у всех ямлов из деплоя есть один и тот же prune-key в labels , потом удаляется все kubectl delete -l prune-key=...
G72K
Но лучше отдельный нейсмпейс на каждую пару (приложение, окружение) заводить
Solyar
Roman
а как разделять лучше, на сервисы или сервисами
Roman
ну вот у меня разрабы просят чтобы было типа так: ololo.kek/branch-name
Solyar
1 приложение 1 неймспейс
Solyar
ну вот у меня разрабы просят чтобы было типа так: ololo.kek/branch-name
ingress который будет ссылаться на сервис branch-name
Solyar
ну вот у меня разрабы просят чтобы было типа так: ololo.kek/branch-name
https://youtu.be/CgCLPYJRxbU?t=2104
Solyar
Вот тут прям четко описано то что вам нужно)
Solyar
Время привязал
Roman
спасибо посмотрю
Roman
благодарю за сосветы!
 Валентин
ну вот у меня разрабы просят чтобы было типа так: ololo.kek/branch-name
Лучше че-то типа jira-123.projectname.local делать. На проде ж у проекта свой домен - вот и так будет тоже всегда свой.
Roman
Лучше че-то типа jira-123.projectname.local делать. На проде ж у проекта свой домен - вот и так будет тоже всегда свой.
тогда еще нужно будет как то с named интегрироваться...
 Artem
Подскажите, плиз, есть ли плагин для яндекс танка по мониторингу ресурсов кубера? По ssh не получится, так как неизвестно, на какой ноде стартует сервис
Валентин
тогда еще нужно будет как то с named интегрироваться...
Если проектов не тысяча, то *.projectname.local завести по каждому проекту и все. Они ж наверняка все на 1 ингресс сходятся в итоге?