 Gleb


у нас не deep learning, у нас рекомендательный движок. там 400 метров pickle или что-то такое
 Andrei
в одном ingress можно указать несколько поддоменов?
 Artyom
День добрый, коллеги! А может кто-то подсказать, как в кубере настраивается период ожидания, перед тем, как перезапустить поды на новой ноде, если текущая померла. У меня сейчас поды пересоздаются спустя 5 минут. Можно ли как-то это значение уменьшить?
 Отделение Bereke Bank
Artyom
Спасибо!
 Pavel
только есть обрантная стоорна. если у вас гденто что-то на сетвом уровне случится (нода не будет видить контроллера) на время которое вы оптимизировали, можн ополучить флап
Sergey
Ну это везде так, подобрать оптимальное значение между скоростью реакции и ложными срабатываниями
Салтыдык
смотри сгенерированный конфиг для ингресс-бэкенда
Отделение Bereke Bank
только есть обрантная стоорна. если у вас гденто что-то на сетвом уровне случится (нода не будет видить контроллера) на время которое вы оптимизировали, можн ополучить флап
кстати да. меня эти дефолтные 5 мин конкретно спасли, когда из-за неудачного апдейта я чуть не положил прод 😅 за 5 мин успел откатить kubelet и основные сервисы
 𝚔𝚟𝚊𝚙𝚜
По умолчанию за 30 секунд нода переходит в NotReady и 5 минут когда поды помечаются Unknown
𝚔𝚟𝚊𝚙𝚜
Обычно через 30 секунд (сразу после того как нода перешла в NotReady) запускается fencing который убивает ноду и все workload на ней
Artyom
Значения поменял, на описанные в статье, но по прежнему 5 минут(
Artyom
Edouard
у нас не deep learning, у нас рекомендательный движок. там 400 метров pickle или что-то такое
Скачиваем. Просто curl`ом с артифактори, и затем как всегда pkl_file = open
Обратно аналогично pickle.dump вроде. В-целом, процесс в докере выстроен как, например, здесь
https://github.com/jupyter/docker-stacks/blob/master/scipy-notebook/Dockerfile
Pavel
у кото либо завелся kubespray+ipvs+ingress? или это я криворукий
 Андрей А
у кото либо завелся kubespray+ipvs+ingress? или это я криворукий
Не с первой попытки, но завелся
Pavel
там какето шаманство или что-то еще?
Андрей А
сам кубер штука непростая, в этом проблема
Андрей А
там какето шаманство или что-то еще?
Основной момент, это необходимость в балансировщике, если свое железо используешь
Андрей А
у кото либо завелся kubespray+ipvs+ingress? или это я криворукий
Чтобы ответить более конкретно нужно больше информации
Pavel
я не мног оне про то
у меня ingress-controller постоянно рестартится
Neither --kubeconfig nor --master was specified. Using the inClusterConfig. This might not work
Андрей А
я не мног оне про то
у меня ingress-controller постоянно рестартится
Neither --kubeconfig nor --master was specified. Using the inClusterConfig. This might not work
Похоже проблемы при конфигурации кубспрея, у меня такого не было
Андрей А
Андрей А
Может поможет, кубспрей по умолчанию предполагает наличие внутренней сети у кластера
Артур
Всем привет. Подскажите кто то ELK ставил в кубере? постоянно прихожу к одной ошибке
Kibana server is not ready yet
 Dmitrii
А логи кибаны смотрел?
 Pavel
я не мног оне про то
у меня ingress-controller постоянно рестартится
Neither --kubeconfig nor --master was specified. Using the inClusterConfig. This might not work
Похоже, что не может до апи-сервера достучаться
invokeme
Всем привет. Подскажите кто то ELK ставил в кубере? постоянно прихожу к одной ошибке
Kibana server is not ready yet
Проверь те ли версии Еластика и Кибаны: там есть compability matrix, и посмотри значение kibana.index в когфигах кибаны.
 Solyar
Проверь elastic и кибану
Solyar
правильно ли они друг на друга смотрят
Pavel
да. осталось понять почему при iptables работает а при ipvs нет. на старых версиях (1.9-1.10) были проблемы. я четно надеялся что к 1.14 починили
Solyar
у меня это была проблема с деплоем эластика
Igor
curl к эластику сделай
Igor
он заведется
Артур
создать типа индекс через апи?
Igor
нет
Solyar
просто дернуть curl elasticsearch-service-ip:9200
Igor
просто курл к 9200
Igor
да
 Nik
А никто не знает, умеет ли плагин для всферы фенсить ноды в случае их отвала?
Pavel
да. осталось понять почему при iptables работает а при ipvs нет. на старых версиях (1.9-1.10) были проблемы. я четно надеялся что к 1.14 починили
Надо проверить доступен ли апи-сервер по сервисному адресу для начала. Можно попробовать на ноде, где падающий ингресс под пытается запуститься
 The
Pavel
А никто не знает, умеет ли плагин для всферы фенсить ноды в случае их отвала?
Плагин для всферы это vSphere Cloud Provider? По-моему, он исключительно про сторадж и больше ничего не умеет
Nik
Мб есть другие методы?
Vadim
Подскажите пожалуйста, как наименьшими затратами - добавить для ingress-nginx еще один порт
те сейчас он слушает на 80 и 443 а мне бы добавить еще например 8443
проблема в том что я сетапил с помощью kubespray,
ingress_nginx_enabled: true
ingress_nginx_host_network: true
И сейчас боюсь сломать если залью неправильный yaml, подскажите плиз в какую сторону смотреть ?
Vadim
Или может быть еще один ingress-nginx добавить только на 8443 порту
Igor
Или может быть еще один ingress-nginx добавить только на 8443 порту
https://kubernetes.github.io/ingress-nginx/user-guide/exposing-tcp-udp-services/
Vadim
там по 8443 будет тот же http
Vadim
А как бы мне не сломать то что сделал kubespray ? 🙂
Solyar
А как бы мне не сломать то что сделал kubespray ? 🙂
kubectl edit service <nameofservice> -n <namespace>
Solyar
И поправить файлик
Vadim
спасибо большое
 Валентин
Интересно - ingress-nginx обновили деплой у себя, под kustomize переделали. Поставил на чистый 1.14 кластер... и словил проблемы с rbac oO
 Andrey
Кто нибудь знает можно ли редактировать clusterrole admin? Пытаюсь добать права на crd, вроде редактируется успешно, но сбрасывается на дефолтные настройки
 Puma
а ни у кого не крутится гитлаб раннер в кубере , гоняю там тесты rspec , внутри они параллелятся knapsack, при каждом прогоне всегда один или два теста прыгают до 100-130 секунд на выполнение
Puma
При том что кубер крутиться на 5 нодах по 4 ядра и 8 гигов оперативы и ресурсов хватает , тесты делятся +- параллельно раннером , на локалькой тачке тесты гоняются без таких прлоблем там максимум на тест 28 секунд
Puma
причем время выполнения вырастает всегда в разных тестах , какой то логики в этом нет
Eugeny
Всем привет!
Прикрутил к дженкинсу через кубернетес плагин - кубернетес.
Запускаю джобу, которая должна выдать результат команды mvn -v
Но вместо этого вижу только:
Still waiting to schedule task
All nodes of label ‘jenkins-jnlp-build-env-rhel7-22-ae77ced8’ are offline
на мастере
29m Normal Scheduled pod/jenkins-slave-qfp9m-zh3pm Successfully assigned default/jenkins-slave-qfp9m-zh3pm to test-k8s-slave01.ap.int.zone
29m Normal Pulled pod/jenkins-slave-qfp9m-zh3pm Container image "sandbox.com/centos:1.0" already present on machine
29m Normal Created pod/jenkins-slave-qfp9m-zh3pm Created container build-env-rhel7
29m Normal Started pod/jenkins-slave-qfp9m-zh3pm Started container build-env-rhel7
29m Normal Pulled pod/jenkins-slave-qfp9m-zh3pm Container image "jenkins/jnlp-slave:alpine" already present on machine
29m Normal Created pod/jenkins-slave-qfp9m-zh3pm Created container jnlp
29m Normal Started pod/jenkins-slave-qfp9m-zh3pm Started container jnlp
29m Normal Killing pod/jenkins-slave-qfp9m-zh3pm Stopping container jnlp
 Vadim
>29m Normal Started pod/jenkins-slave-qfp9m-zh3pm Started container jnlp
29m Normal Killing pod/jenkins-slave-qfp9m-zh3pm Stopping container jnlp
jnlp под умер сразу же
Eugeny
да, и вопрос собственно как понять отчего он помер
The
Как заставить CoreDNS резолвить из /etc/hosts с ноды? Что надо запихнуть в cm?
 Andor
Валентин
Как заставить CoreDNS резолвить из /etc/hosts с ноды? Что надо запихнуть в cm?
По-моем он такое принципиально не умеет
Валентин
Как заставить CoreDNS резолвить из /etc/hosts с ноды? Что надо запихнуть в cm?
Зачем это делать так, если можно завести сервис просто? Ну или если куб свежий - там /etc/hosts пода настраивается уже
 Pavel
Solyar
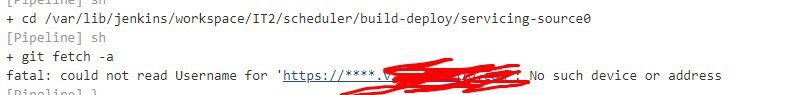
Ребзи вопрос по дженкинсу.
Почему он не хочет выполнять комманду git fetch -a и git checkout branch ?
Solyar
Во время выполнения пайплайна само собой
 George
Solyar
 Solyar
Хотя креденшиналы правильные