ну можно поставить imagePullPolicy: Always и удалить поды по лейблу
Только так сам и придумал
 Alexander

 Alexander
Значит всё-таки придётся пойти другим путём. Понял.
Благодарю
Andrew
#whois
Сразу не представился, исправляюсь
▫️Какой у вас проект или где работаете?
Я работаю в MetService New Zealand - это местный гидрометцентр, я работаю в океанологической команде, занимаемся моделированием мирового океана, 24/7/365 гоняем модели и обновляем данные. У меня позиция Senior scientific system engineer. Наш основной фронтенд www.metoceaview.com (старая версия, в продакшн)
▫️В чём вы специалист?
Опыт системного инженера лет 15 примерно (Linux), до этого девелопмент. Опыт Docker в продакшн с версии 0.9.
▫️Чем можете быть интересны или полезны сообществу?
Могу делиться своим опытом по поводу Linux, сетей, system engineering
Могу рассказать про переезд и работу в Новой Зеландии 😊
▫️Чем интересно сообщество вам?
Мы сейчас тестируем Кубернетес чтобы гонять на нем наши модели и API-сервисы доступа к данным
▫️Откуда вы?
Сейчас - Raglan, New Zealand
Исходно из Москвы
▫️Как узнали про группу?
Был на MegaSlurm в конце октября прошлого года, узнал из их канала в Телеграме
 The
Подскажите плиз, если к8 кластер на виртуалках был инициализирован с 2vCPU а потом добавили ещё 2 на кпжлую ноду, то это как то отрицательно влияет на производительность?
 𝚔𝚟𝚊𝚙𝚜
Кто знает какой самый простой способ разрезолвить docker image в sha256?
у докера появилась комманда
docker manifest inspect
𝚔𝚟𝚊𝚙𝚜
правда как показывает практика .config.digest не совпадает с тем, что показывает skopeo, а во многих манифестах его может просто не быть
𝚔𝚟𝚊𝚙𝚜
Подскажите плиз, если к8 кластер на виртуалках был инициализирован с 2vCPU а потом добавили ещё 2 на кпжлую ноду, то это как то отрицательно влияет на производительность?
а почему это должно как-то отрицатильно повлиять на производительность?
 Vadim
Подскажите плиз, если к8 кластер на виртуалках был инициализирован с 2vCPU а потом добавили ещё 2 на кпжлую ноду, то это как то отрицательно влияет на производительность?
Не повлияет никак - кубелет только при создании ноды читает сколько ядер доступно
Vadim
правда как показывает практика .config.digest не совпадает с тем, что показывает skopeo, а во многих манифестах его может просто не быть
manifest inspect показывает сам json манифеста?
Vadim
Тогда digest будет sha256 от этого жсона - должно совпасть с показаниями скопео
The
а почему это должно как-то отрицатильно повлиять на производительность?
Ну, настораживает то, что он считает ядра на initе.
𝚔𝚟𝚊𝚙𝚜
Тогда digest будет sha256 от этого жсона - должно совпасть с показаниями скопео
неа
$ skopeo inspect docker://ubuntu:bionic | jq -r .Digest
sha256:d26d529daa4d8567167181d9d569f2a85da3c5ecaf539cace2c6223355d69981
$ docker manifest inspect ubuntu:bionic | sha256sum
e78c32e8f317846757d99210cd056aa3d9dd4e9c83f3ee49e579effe65e4841c -
Vadim
Хмм, совсем я забыл магию docker schema v2 значит
 Dmitry
Не повлияет никак - кубелет только при создании ноды читает сколько ядер доступно
А как ему рассказать, что капасити выросло? Удалять объект ноды, чтобы заново создался? Дашборд по крайней мере сразу начинает видеть увеличение процессоров
𝚔𝚟𝚊𝚙𝚜
Идея фикс:
Mutating Admission Webhook для резолвинга всех имаджей в кластере.
𝚔𝚟𝚊𝚙𝚜
применяешь новый манифест, а он тебе все images в digest'ы переводит по умолчанию
Vadim
Vadim
неа
$ skopeo inspect docker://ubuntu:bionic | jq -r .Digest
sha256:d26d529daa4d8567167181d9d569f2a85da3c5ecaf539cace2c6223355d69981
$ docker manifest inspect ubuntu:bionic | sha256sum
e78c32e8f317846757d99210cd056aa3d9dd4e9c83f3ee49e579effe65e4841c -
ааа, ну да, это manifest list же, для каждой архитектуры
𝚔𝚟𝚊𝚙𝚜
применяешь новый манифест, а он тебе все images в digest'ы переводит по умолчанию
или даже лучше по аннотации:
docker-images-resolver/resolve-image: "true"
Vadim
или даже лучше по аннотации:
docker-images-resolver/resolve-image: "true"
или даже отдельный CRD объект с тегами которые привязываются к диджестам и имеют ивенты, синк и так далее - ImageStream в опеншифте
𝚔𝚟𝚊𝚙𝚜
Vadim
а оно именно по apply стреляет?
да, меняешь тег imagestream и оно меняет диджест внутри - и триггерит новый деплоймент если нужно
𝚔𝚟𝚊𝚙𝚜
да, меняешь тег imagestream и оно меняет диджест внутри - и триггерит новый деплоймент если нужно
коротый создает новый репликасет, короый генерит новые поды :)
𝚔𝚟𝚊𝚙𝚜
в доме который построил джек
Vadim
поды, которые генерят новый контейнеры, которые генерят новые cgroups
𝚔𝚟𝚊𝚙𝚜
Вот ядро
Которое построил Линус.
А это системный процесс,
Который работает без умолку,
В ядре,
Которое построил Линус.
А это суровый cgroup,
Который изолирует системный процесс,
Который работает без умолку,
В ядре,
Которое построил Линус.
Вот контейнер,
Который генерит суровый cgroup,
Который изолирует системный процесс,
Который работает без умолку,
В ядре,
Которое построил Линус.
Вот под,
Что часто пинает контейнер,
Который генерит суровый cgroup,
Который изолирует системный процесс,
Который работает без умолку,
В ядре,
Которое построил Линус.
А это container engine,
Который тот под создает,
Что часто пинает контейнер,
Который генерит суровый cgroup,
Который изолирует системный процесс,
Который работает без умолку,
В ядре,
Которое построил Линус.
А это непрестрастнный CI,
Который управляет container engine,
Который тот под создает,
Что часто пинает контейнер,
Который генерит суровый cgroup,
Который изолирует системный процесс,
Который работает без умолку,
В ядре,
Которое построил Линус.
А это ленивый и толстый DevOps-инженер,
Который нacтраивает непрестрастнный CI,
Который управляет container engine,
Который тот под создает,
Что часто пинает контейнер,
Который генерит суровый cgroup,
Который изолирует системный процесс,
Который работает без умолку,
В ядре,
Которое построил Линус.
Вот два алерта,
Которые будят того DevOps-инженера,
Который нacтраивает непрестрастнный CI,
Который управляет container engine,
Который тот под создает,
Что часто пинает контейнер,
Который генерит суровый cgroup,
Который изолирует системный процесс,
Который работает без умолку,
В ядре,
Которое построил Линус.
Vadim
s/В ядре/С ядром/g
𝚔𝚟𝚊𝚙𝚜
там много нестыковок получилось, но не суть)
Vadim
тема прометея и шедулера не раскрыта, но годно
Antlar
аффтар пеши ещо
Vadim
describe node xxx показывает актуальное количество цпу или это ничего не значит?
хмм, я был уверен что это фундаментальный косяк cAdvisor'а, но видимо пофиксили
Alexey
Коллеги, подскажите: создал pv и pvc, монтирую к поду - получаю ошибку persistentvolumeclaim not found.
При этом pvc с указанным именем в выводе kubectl get pvc присутствует. В чем может быть проблема?
 Mikhail
не тот namespace ?
 Solyar
Коллеги, подскажите: создал pv и pvc, монтирую к поду - получаю ошибку persistentvolumeclaim not found.
При этом pvc с указанным именем в выводе kubectl get pvc присутствует. В чем может быть проблема?
Как вариант Namespace не был указан и по умолчанию Claim создался в ns default
Alexey
Ага, похоже на то. Сейчас проверяю
Solyar
kubectl get pvc --namespace=<namespace>
Alexey
Да, забыл указать ns при создании. Благодарю за опертивные подсказки) Теперь ошибка при монтировании mount: wrong fs type, bad option, bad superblock on %%, missing codepage or helper program, or other error.
Solyar
Solyar
Локальный, Облако?
Alexey
nfs c соседней машины. Локальный, видимо)
Alexey
Да, забыл указать ns при создании. Благодарю за опертивные подсказки) Теперь ошибка при монтировании mount: wrong fs type, bad option, bad superblock on %%, missing codepage or helper program, or other error.
Проблема была в отсутствии nfs-utils на конкретной ноде, куда лег под. :)
Petrukhin
коллеги, а кто то может подсказать как дебажить проблемы с сетью в k8s(flannel). Есть база(cql), вне куреба, в нее не долетают запросы из пода.
Petrukhin
хотя бы какой подход, кроме tcpdump
Petrukhin
коллеги, а кто то может подсказать как дебажить проблемы с сетью в k8s(flannel). Есть база(cql), вне куреба, в нее не долетают запросы из пода.
не долетает часть запросов, примерно 1-1,5%
Sergey
рисуйте, для начала, топологию сети
Sergey
flannel - vxlan илм host-gw
Petrukhin
vxlan
Sergey
с самих воркер нод на ноды с базой есть доступ?
Sergey
нет ли воркер ноды, отдкуда нет доступна к базе?
Sergey
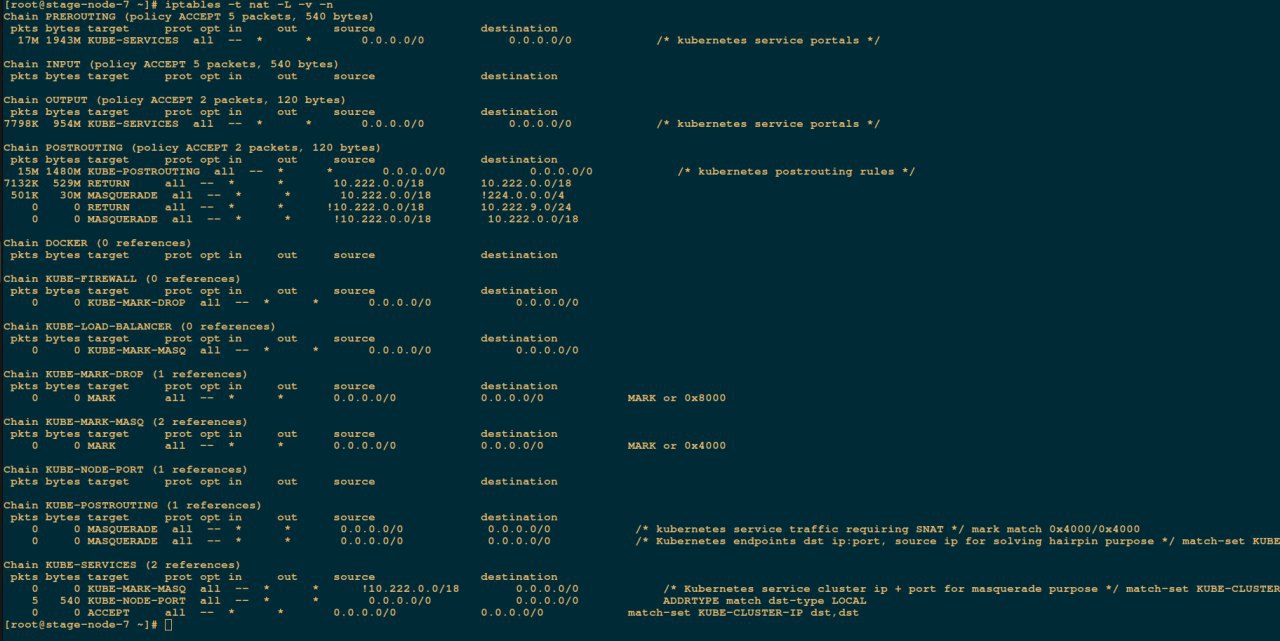
смотреть iptables -L -vn & iptables -t nat -L -vn
Sergey
возможно, на какой-то воркер ноде, есть проблемы с правилами
Petrukhin
хотя я тебя обманул(поднимал спреем) 8: flannel.1: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1450 qdisc noqueue state UNKNOWN group default
link/ether 42:f7:40:6a:88:80 brd ff:ff:ff:ff:ff:ff
inet 10.222.9.0/32 scope global flannel.1
valid_lft forever preferred_lft forever
inet6 fe80::40f7:40ff:fe6a:8880/64 scope link
valid_lft forever preferred_lft forever
9: cni0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1450 qdisc noqueue state UP group default qlen 1000
link/ether 0a:58:0a:de:09:01 brd ff:ff:ff:ff:ff:ff
inet 10.222.9.1/24 scope global cni0
или я не понимаю разницу, но на каждой ноде есть 10.221.X.1/24 то видимо host-gw
Sergey
начти от простого к сложному
 Andrey
коллеги, а кто то может подсказать как дебажить проблемы с сетью в k8s(flannel). Есть база(cql), вне куреба, в нее не долетают запросы из пода.
Вываливать в приложении причины неустановления коннекта. Через логгинг или что-то типа Sentry. Packet loss не ответит на вопрос, почему у тебя запросы (не пакеты) падают.
Sergey
сначала проверь есть ли с кубер воркер нод доступ на базу данных и уже постепенно поднимайся вверх
Petrukhin
@oZZyTOP 1- вездее есть. 2- нет
Sergey
так что с правилами iptables - хотя там такой ад будет, что сразу и не разберешься
Petrukhin
так что с правилами iptables - хотя там такой ад будет, что сразу и не разберешься
предполагаю, пошел в магаз за водкой
Petrukhin
это же амерекосовское подели - бренди надо
нашего русского человека этими заморскими пойлами не возьмешь, могз без водки не работает, проверено 3ех палыми фрезеровщиками с завода
Sergey
нашего русского человека этими заморскими пойлами не возьмешь, могз без водки не работает, проверено 3ех палыми фрезеровщиками с завода
я не за русского человека переживаю, а за амереканское поделие)
Sergey
 Petrukhin
 Sergey
это ты не видел iptables с ретурнами до появления ipset
Petrukhin
не довелось
 Tadeusz
Petrukhin
возможно, на какой-то воркер ноде, есть проблемы с правилами
там под жирный, примерно так 40-100 гб памяти потребляет. Примерно 1000 r\s в cassandra шлет, но какие то теряются и из-за этого не верно выстраивается логика приклада.
Sergey
 Lucky SB
поэтому так мало iptables
Petrukhin
ipvs detected
спрей(от centos-admin) так ставит ( и да его можно поменять, но в чем это хплохо?
Lucky SB
Petrukhin
уже подзно ;)