 Andor


с переводом строки
Andor
но я честно говоря не уверен что делать это терраформом - удобно и просто
Andor
и это наверняка не будет работать с CRD без патченья провайдера
 Grisha
"secrets.env" = "${file("file")}" вот так работает
Andor
ага
Grisha
спасибо
 Andrei
Всем привет. Кто-нибудь сталкивался с проблемой, что системные поды стартуют сильно позже, нежели системные? Куб 1.12.3, речь о calico. Статус pending. С кластером ничего не делали, ноды в Ready
 Dmytro
А что в логах шедулера, ивентах и тд?
 Vadim
>системные поды стартуют сильно позже, нежели системные
надо экзорциста звать
Dmytro
экзокубениста
 Etki
эксгибинетес
Andor
эксгедонитес
Etki
астанавитес
 Grigorii
Привет, а есть у кого gpu(nvidia) ноды в Кубе?
Grigorii
у меня, только на gce
А что за карточки там?
Если kubectl describe node node-name написать, какое кол-во gpu ресурсов показывает?
У меня показывает "nvidia.com/gpu 1" и не получается запустить более одного требующего gpu сервиса на одном серваке, а надо
R2
 blkmrkt
А что за карточки там?
Если kubectl describe node node-name написать, какое кол-во gpu ресурсов показывает?
У меня показывает "nvidia.com/gpu 1" и не получается запустить более одного требующего gpu сервиса на одном серваке, а надо
V100 и еще подешевле какие-то. Там всегда столько гпу на ноде сколько ты задашь
blkmrkt
R2
а 1080 вроде ж двухголовые ?
R2
единичка по идее к-во процессоров\ядер на физ видяхе
R2
у мя были 1080 на мезос кластере, там было вроде по 2 ядра на карту
соотв. на хосте можно было запустить по 1 контейнеру на 1 гпу ядро
Grigorii
у мя были 1080 на мезос кластере, там было вроде по 2 ядра на карту
соотв. на хосте можно было запустить по 1 контейнеру на 1 гпу ядро
Вот это плохо, что только 1 контейнер. Голым nvidia-docker я могу запускать более одного сервиса на одном серваке
R2
если на хосте 4 видяшки по 2 ядра, то счталось, что есть 8 гпушек
R2
тоесть 8 контейнеров по 1 гпу, или 4 по 2, и т.д.
R2
R2
нвида-докер, как раз забирает гпу ресурсы ядрамы видяхи
R2
емнип, раньше так было.
Grigorii
если на хосте 4 видяшки по 2 ядра, то счталось, что есть 8 гпушек
что ещё за ядра? cuda ядер у него 2560) а каких-то других ядер в спеке у этой карточки не значится
R2
физ процессоры
Alexey
Господа, необходимо запускать более 250 подов на ноде.
Кластер развернут через kubeadm с опцией --pod-network-cidr=10.244.0.0/16, сеть - flannel. Подскажите, что нужно сделать, чтобы корректно сменить маску?
В гугле никаких вразумительных ответов не нашел.
 Andrey
Alexey
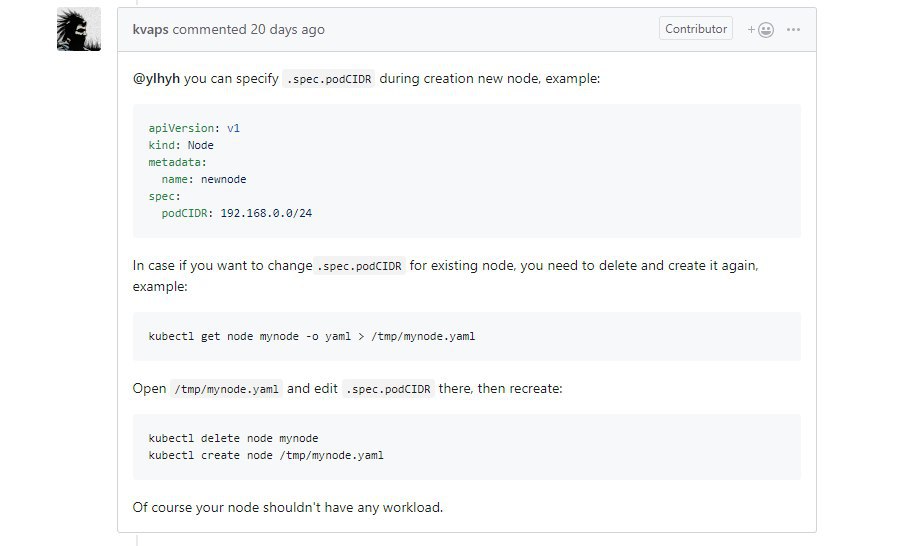
А если delete node сделать просто? kubelet перерегистрируется в API сразу же, при создании Node object'а IPAM контроллер в controller-manager бинарнике выдаст уже /23.
Это тестовый кластер из двух нод (мастер+воркер), в прицнипе, потерять что-то не страшно)
Предлагаешь выполнить kubectl delete master , после чего он сам перерегистрируется в кластере?
Andrey
Проблем не будет в любом случае.
Andrey
Вопрос в том, сработает ли моя теория про CIDR.
Andrey
Это тестовый кластер из двух нод (мастер+воркер), в прицнипе, потерять что-то не страшно)
Предлагаешь выполнить kubectl delete master , после чего он сам перерегистрируется в кластере?
systemctl restart kubelet сделай только после удаления. Он не детектит это, вроде.
Alexey
systemctl restart kubelet сделай только после удаления. Он не детектит это, вроде.
Сработало, благодарю
Alexey
 Dmytro
Да, GeForce® GTX 1080. Не понял пока что данная единица отображает
а откуда 1080 взялась, в доке гугла другие карты https://cloud.google.com/kubernetes-engine/docs/how-to/gpus
Grigorii
Andrey
Andrey
Сработало, но не до конца. В свойствах мастер-ноды Pod CIDR: 10.244.0.0/23, однако cni0 все равно 10.244.0.1/24.
Остановил kubelet и docker, поменял маску cni01 на /23, запустил сервисы - маска опять /24. Что-то еще надо править, похоже.
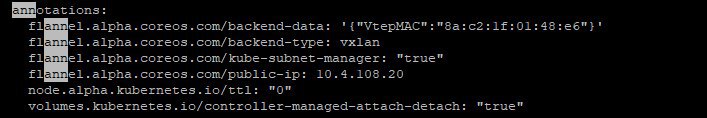
kubectl get node master -o yaml и annotations. Там CNI любят интересные вещи писать.
Andrey
Сработало, но не до конца. В свойствах мастер-ноды Pod CIDR: 10.244.0.0/23, однако cni0 все равно 10.244.0.1/24.
Остановил kubelet и docker, поменял маску cni01 на /23, запустил сервисы - маска опять /24. Что-то еще надо править, похоже.
Возможно, достаточно просто удалить pod с CNI. Тот же flannel, например, чтобы он из API Node объекта подгрузил новые параметры PodCIDR.
Alexey
Andrey
 Andrey
На мастере.
Andrey
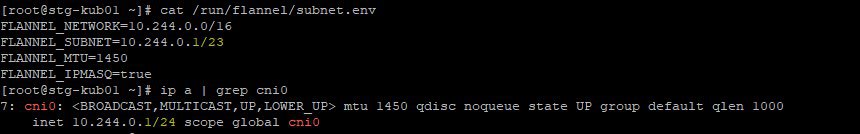 Andrey
Это тянет на issue, как мне кажется.
Andrey
Там нет логики изменения на лету, видимо. Только при создании первоначальном всех Linux'овых примитивов.
Dmytro
может надо ноду ребутнуть? если там iptables то старые правила остались и т.д.
Andrey
Это самое лучшее. Все Linux примитивы херанутся как раз.
Dmytro
У меня Хетзнер
т.е. на той же ноде nvidia-docker показывает 2 gpu а куб видит только 1?
а что говорят nvidia-smi -q и ls -l /dev/nvidia*
 Valentin
Привет,
подскажите плз, куда копать: кубер поднят по kubernetes-hard-way, обновлен до 1.13.4 (CNI Container Networking).
Развернут последний helm-chart stable/nginx-ingress как Daemonset с externalTrafficPolicy = Local, в externalIPs сервиса указаны IP-адреса нод, use-proxy-protocol=false.
Нужно получить реальный IP юзера в поде, но в текущей конфигурации в прилетающем от nginx-ingres-а запросе в под в заголовке x-forwarded-for получаем адрес cnio0 ноды.
Valentin
судя по iptables, пакет, прилетающий на nginx-ingress, маскарадится
Valentin
что и видно в его логах, в общем-то
Alexey
может надо ноду ребутнуть? если там iptables то старые правила остались и т.д.
 Grigorii
т.е. на той же ноде nvidia-docker показывает 2 gpu а куб видит только 1?
а что говорят nvidia-smi -q и ls -l /dev/nvidia*
Не, одно физ ядро
/dev/nvidia0
просто nvidia-docker на одном ядре может запускать много процессов из разных контейнеров, а Куб нет из-за ограничений device plugin и невозможности мониторить этот ресурс
https://github.com/kubernetes/kubernetes/issues/52757
Incognito
привет. вопрос знатокам. у меня есть Ingress в namespace default, можно ли ему получить доступ к service в других namespace, например, test ? если да, то как ?
Valentin
привет. вопрос знатокам. у меня есть Ingress в namespace default, можно ли ему получить доступ к service в других namespace, например, test ? если да, то как ?
spec:
rules:
- host: ...
http:
paths:
- backend:
serviceName: yoursvc.test ?
 Rainbow
он по-умолчанию на все смотрит
Andrey
Можно, через другой сервис
Andrey
Valentin
чорт...
Andrey
Напрямую нельзя
Incognito
я пока нашел в гугле через externalname, но еще не пробовал
Incognito
https://akomljen.com/kubernetes-tips-part-1/
 Andrey
привет. вопрос знатокам. у меня есть Ingress в namespace default, можно ли ему получить доступ к service в других namespace, например, test ? если да, то как ?
зависит от ингресс-контроллера, но вообще тебе просто нужно создать ингресс-ресурс с тем же доменом в другом неймспейсе
Andrey
У меня кажется через него сделано
Incognito
apiVersion: extensions/v1beta1
kind: Ingress
metadata:
name: ingress-nginx
annotations:
kubernetes.io/ingress.class: "nginx"
certmanager.k8s.io/issuer: "${local.tls_clusterissuer_staging}"
certmanager.k8s.io/acme-challenge-type: http01
spec:
tls:
- hosts:
- ${module.echo1.hostname}
secretName: ${local.tls_privateKeySecretRef_staging}
rules:
- host: ${module.echo1.hostname}
http:
paths:
- backend:
serviceName: api-test
servicePort: http
path: /api/v1/call
сейчас создаю вот так
Andrey
До компа доберусь напишу
Andrey
не, у меня в свое время с nginx-ingress не катило. зато работает как я написал. тем более, cert-manager при создании копии ресурса certificate не будет лишний раз дергать letsencrypt, а просто копирнет серт
Vadim
https://github.com/tektoncd/pipeline
гугол тут вознамерился всем CI переписать