 Alex


vagrant@k8s-master:~$ kubectl get all --selector=name=tiller --namespace kube-system
NAME READY STATUS RESTARTS AGE
pod/tiller-deploy-c48485567-75pxf 1/1 Running 0 34m
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE
service/tiller-deploy ClusterIP 10.100.90.57 <none> 44134/TCP 34m
NAME READY UP-TO-DATE AVAILABLE AGE
deployment.apps/tiller-deploy 1/1 1 1 34m
NAME DESIRED CURRENT READY AGE
replicaset.apps/tiller-deploy-c48485567 1 1 1 34m
vagrant@k8s-master:~$
vagrant@k8s-master:~$ helm version
Client: &version.Version{SemVer:"v2.13.1", GitCommit:"618447cbf203d147601b4b9bd7f8c37a5d39fbb4", GitTreeState:"clean"}
Error: forwarding ports: error upgrading connection: unable to upgrade connection: pod does not exist
vagrant@k8s-master:~$
 Denis
Всем привет. Возникла такая трудность с пром оператором.
Хочется сделать такой serviceMonitor который будет собирать эндпойнты во все сервисы по лейблу в любых неймспейсах. аля scrape-metrics: true
И бывают такие моменты что POD листует 2 порта, и соотвественно имеет 2 эндпойнта, и они оба появляются как targets, но метрики не могут быть собраны.
Как то можно исключить таргеты определенные ? или типа сказать чтобы брал только те энпойнты на которые указывает сервис.
 Andor
Всем привет. Возникла такая трудность с пром оператором.
Хочется сделать такой serviceMonitor который будет собирать эндпойнты во все сервисы по лейблу в любых неймспейсах. аля scrape-metrics: true
И бывают такие моменты что POD листует 2 порта, и соотвественно имеет 2 эндпойнта, и они оба появляются как targets, но метрики не могут быть собраны.
Как то можно исключить таргеты определенные ? или типа сказать чтобы брал только те энпойнты на которые указывает сервис.
Ну ты всегда можешь дополнительный релейбелинг сделать и там пофильтровать
Denis
Ну ты всегда можешь дополнительный релейбелинг сделать и там пофильтровать
эмс. а разве я могу таргеты фильтровать релейблингом ?
Andor
Конечно, там же просто джоба в прометее создаётся
Andor
Можешь сделать такой релейбелинг какой хочешь
 Артем
Добрый день. Настроил deploy в kubernetes приложения с помощью helm, при повторном запуске helm install ... пишет ошибку, что под уже существует, что нужно сделать чтобы он работал как apply?
 Roman
Добрый день, есть ли аналоги makisu, умеющие в мультистейдж докерфайлы?
Andor
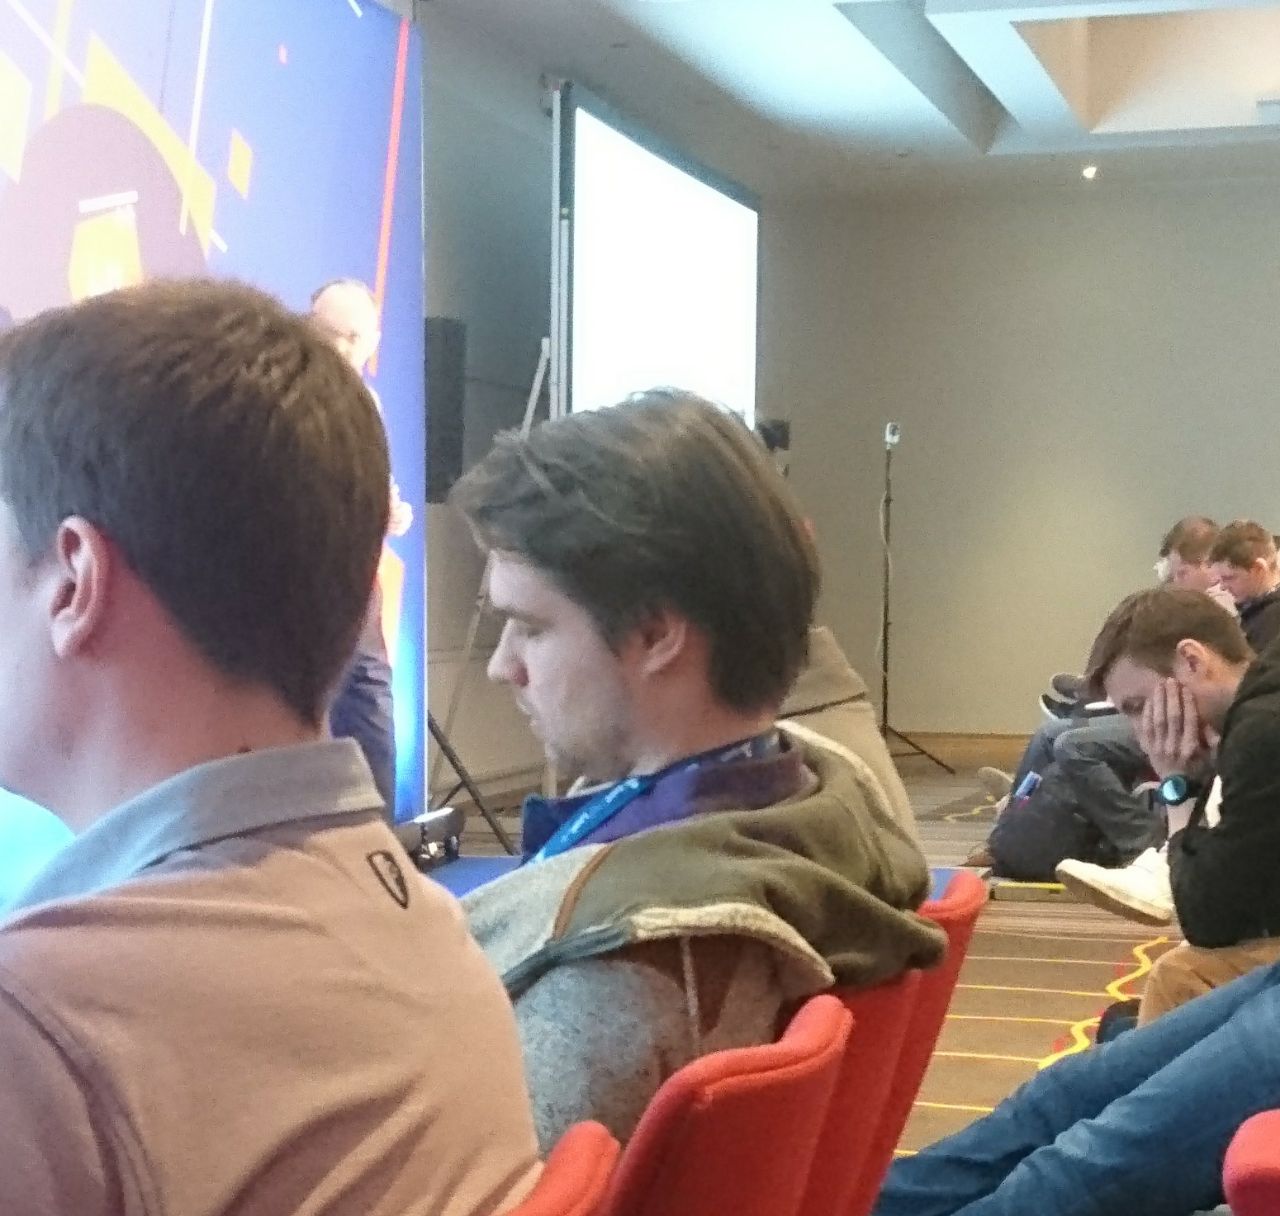 Andor
Интересный доклад про kubernetes csi настолько что @zuzzas уснул
 Stefan

 𝚔𝚟𝚊𝚙𝚜
𝚔𝚟𝚊𝚙𝚜
> Просмотр доступен для авторизованных участников, которые купили данную услугу
𝚔𝚟𝚊𝚙𝚜
ну и ладно
 Sergey
так это хайлоад чтоль начался
Eugene

 Artem
Не подскажете, как по-хорошему после апдейта сертификата в секрете (серт-менеджером) можно затригерить апдейт деплойментов, его использующих (допустим после автоматического обновления)
 Sergei
некоторые вот это используют: https://github.com/xing/kubernetes-deployment-restart-controller
Sergei
я не пробовал честно говоря 🙂
Anton
Не подскажете, как по-хорошему после апдейта сертификата в секрете (серт-менеджером) можно затригерить апдейт деплойментов, его использующих (допустим после автоматического обновления)
у тебя сертификат монтируется в файлы для использования в приложении?
если ты переживаешь за ingress resources, то там обновление секрета отслеживается
Artem
В отдельное приложение, не в ингресс
Artem
 Vladimir
Господа, а кто нить desheduler использовал?
 Nata
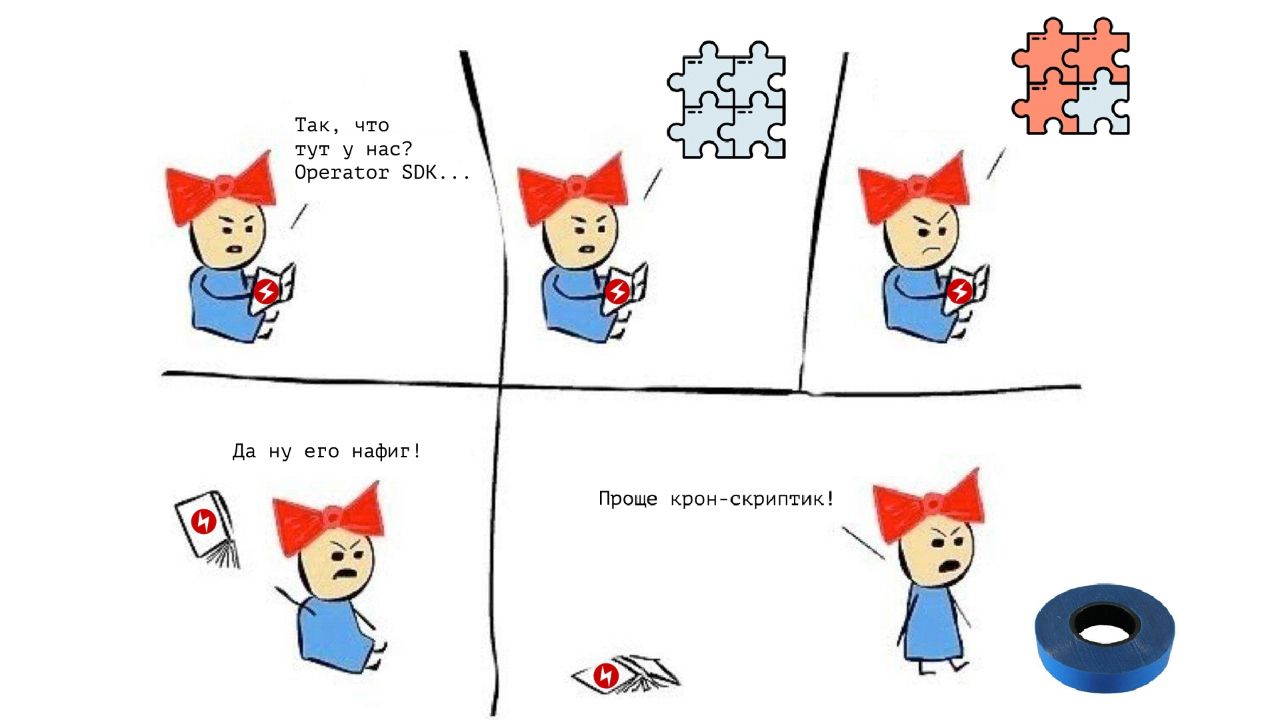
Фотку про крон и девочку успел сделать?
Andor
Нет
Nata
Жаль
 Вадим
@SinTeZoiD эт спамер
 Andrey
 Nata
Спасибо 🥺
 Grisha
Ребзя, хел, почему так? я выключа 1 мастер, а core-dns уебывается везде coredns-fb8b8dccf-9qtpx 0/1 CrashLoopBackOff 40 12d
coredns-fb8b8dccf-h5r7w 0/1 Error 38 12d
coredns-fb8b8dccf-xj28p 0/1 CrashLoopBackOff 35 6d2h
 Denis
Grisha
[root@5051k8s-master ~]# kubectl logs -f coredns-fb8b8dccf-9qtpx -n kube-system
E0408 16:11:32.973833 1 reflector.go:134] github.com/coredns/coredns/plugin/kubernetes/controller.go:315: Failed to list *v1.Service: Get https://10.96.0.1:443/api/v1/services?limit=500&resourceVersion=0: dial tcp 10.96.0.1:443: connect: connection refused
E0408 16:11:32.973833 1 reflector.go:134] github.com/coredns/coredns/plugin/kubernetes/controller.go:315: Failed to list *v1.Service: Get https://10.96.0.1:443/api/v1/services?limit=500&resourceVersion=0: dial tcp 10.96.0.1:443: connect: connection refused
log: exiting because of error: log: cannot create log: open /tmp/coredns.coredns-fb8b8dccf-9qtpx.unknownuser.log.ERROR.20190408-161132.1: no such file or directory
Denis
[root@5051k8s-master ~]# kubectl logs -f coredns-fb8b8dccf-9qtpx -n kube-system
E0408 16:11:32.973833 1 reflector.go:134] github.com/coredns/coredns/plugin/kubernetes/controller.go:315: Failed to list *v1.Service: Get https://10.96.0.1:443/api/v1/services?limit=500&resourceVersion=0: dial tcp 10.96.0.1:443: connect: connection refused
E0408 16:11:32.973833 1 reflector.go:134] github.com/coredns/coredns/plugin/kubernetes/controller.go:315: Failed to list *v1.Service: Get https://10.96.0.1:443/api/v1/services?limit=500&resourceVersion=0: dial tcp 10.96.0.1:443: connect: connection refused
log: exiting because of error: log: cannot create log: open /tmp/coredns.coredns-fb8b8dccf-9qtpx.unknownuser.log.ERROR.20190408-161132.1: no such file or directory
Не может до apiserver достучатся, поэтому падает. Сколько мастеров в кластере? Что показывает при этом команда kubectl get cs ?
Grisha
[root@5051k8s-master ~]# kubectl get pods -n kube-system | grep core
coredns-fb8b8dccf-9qtpx 0/1 CrashLoopBackOff 44 12d
coredns-fb8b8dccf-h5r7w 0/1 Error 42 12d
coredns-fb8b8dccf-xj28p 0/1 CrashLoopBackOff 39 6d2h
[root@5051k8s-master ~]# kubectl get cs
NAME STATUS MESSAGE ERROR
controller-manager Healthy ok
scheduler Healthy ok
etcd-1 Healthy {"health":"true"}
etcd-2 Healthy {"health":"true"}
etcd-0 Healthy {"health":"true»}
Grisha
при это важно какой именно мастер уронить, если уронить другой мастер, все ок
Grisha
а именно 5051 master ругается
 Vadim
тем временем CRI-O официально стал проектом CNCF - https://github.com/cncf/toc/pull/177#issuecomment-480881475
Denis
при это важно какой именно мастер уронить, если уронить другой мастер, все ок
Что в логах плагина CNI?
 Lucky SB
[root@5051k8s-master ~]# kubectl logs -f coredns-fb8b8dccf-9qtpx -n kube-system
E0408 16:11:32.973833 1 reflector.go:134] github.com/coredns/coredns/plugin/kubernetes/controller.go:315: Failed to list *v1.Service: Get https://10.96.0.1:443/api/v1/services?limit=500&resourceVersion=0: dial tcp 10.96.0.1:443: connect: connection refused
E0408 16:11:32.973833 1 reflector.go:134] github.com/coredns/coredns/plugin/kubernetes/controller.go:315: Failed to list *v1.Service: Get https://10.96.0.1:443/api/v1/services?limit=500&resourceVersion=0: dial tcp 10.96.0.1:443: connect: connection refused
log: exiting because of error: log: cannot create log: open /tmp/coredns.coredns-fb8b8dccf-9qtpx.unknownuser.log.ERROR.20190408-161132.1: no such file or directory
А что за адрес 10.96.0.1 ?
Если это адрес сервиса kubernetes - то смотреть
kubectl get ep kubernetes
если там нету ip адреса выключенного мастера - тогда смтреть в логи куб-прокси на том узле где корднс падает.
но в общем случае это все говорит о том, что у тебя не настроен HA-setup кластера.
а скорее всего нету прокси-балансировщика между кублетами и kube-proxy и API-серверами.
Grisha
А что за адрес 10.96.0.1 ?
Если это адрес сервиса kubernetes - то смотреть
kubectl get ep kubernetes
если там нету ip адреса выключенного мастера - тогда смтреть в логи куб-прокси на том узле где корднс падает.
но в общем случае это все говорит о том, что у тебя не настроен HA-setup кластера.
а скорее всего нету прокси-балансировщика между кублетами и kube-proxy и API-серверами.
[root@5050k8s-master cp]# kubectl get ep kubernetes
NAME ENDPOINTS AGE
kubernetes 10.50.80.50:6443 12d
Grisha
действтиельно всего 1 ендпоинт
Grisha
ааа не все ок
Grisha
это внешний балансер
Grisha
опять, не пверно, охрана тмена, это действительно не правильная завись
Grisha
NAME STATUS ROLES AGE VERSION LABELS
5050k8s-master Ready master 12d v1.14.0 beta.kubernetes.io/arch=amd64,beta.kubernetes.io/os=linux,kubernetes.io/arch=amd64,kubernetes.io/hostname=5050k8s-master,kubernetes.io/os=linux,node-role.kubernetes.io/master=
5051k8s-master Ready master 12d v1.14.0 beta.kubernetes.io/arch=amd64,beta.kubernetes.io/os=linux,kubernetes.io/arch=amd64,kubernetes.io/hostname=5051k8s-master,kubernetes.io/os=linux,node-role.kubernetes.io/master=
5052k8s-master Ready master 12d v1.14.0 beta.kubernetes.io/arch=amd64,beta.kubernetes.io/os=linux,kubernetes.io/arch=amd64,kubernetes.io/hostname=5052k8s-master,kubernetes.io/os=linux,node-role.kubernetes.io/master=
Grisha
но мастеров у меня 3
Grisha
вообщем я понял в какую сторону коать, завтра продолжу
Denis
А что за адрес 10.96.0.1 ?
Если это адрес сервиса kubernetes - то смотреть
kubectl get ep kubernetes
если там нету ip адреса выключенного мастера - тогда смтреть в логи куб-прокси на том узле где корднс падает.
но в общем случае это все говорит о том, что у тебя не настроен HA-setup кластера.
а скорее всего нету прокси-балансировщика между кублетами и kube-proxy и API-серверами.
Это адрес kubeapiserver.Точно когда kubeadm развертывание кластера делаешь, то он этот сервис по дефолту ставит.
Denis
[root@5050k8s-master cp]# kubectl get ep kubernetes
NAME ENDPOINTS AGE
kubernetes 10.50.80.50:6443 12d
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE
kubernetes ClusterIP 10.96.0.1 <none> 443/TCP 5d1h
У тебя что то подобное должно быть
Denis
[root@5050k8s-master cp]# kubectl get ep kubernetes
NAME ENDPOINTS AGE
kubernetes 10.50.80.50:6443 12d
А вот тут в эндпоинте этого сервиса должны быть адреса аписерверов:
NAME ENDPOINTS AGE
kubernetes 192.168.0.20:6443,192.168.0.21:6443,192.168.0.22:6443 5d1h
Denis
[root@5050k8s-master cp]# kubectl get ep kubernetes
NAME ENDPOINTS AGE
kubernetes 10.50.80.50:6443 12d
Получается у тебя где-то косяк на балансировщике. Проверяй его работу.
Grisha
у меня не верно указаны ендпоинты
Grisha
мне надо вкурить откуда он их берет и поправить
Grisha
руками
Grisha
и видимо где-то допустил ошибку
Grisha
kubeadm
Grisha
kubeadm
Grisha
[root@5050k8s-master opt]# kubectl describe svc kubernetes
Name: kubernetes
Namespace: default
Labels: component=apiserver
provider=kubernetes
Annotations: <none>
Selector: <none>
Type: ClusterIP
IP: 10.96.0.1
Port: https 443/TCP
TargetPort: 6443/TCP
Endpoints: 10.50.80.50:6443
Session Affinity: None
Events: <none>
Grisha
вот как сюдой добавить ендпоинтов
Grisha
руками?
Denis
[root@5050k8s-master opt]# kubectl describe svc kubernetes
Name: kubernetes
Namespace: default
Labels: component=apiserver
provider=kubernetes
Annotations: <none>
Selector: <none>
Type: ClusterIP
IP: 10.96.0.1
Port: https 443/TCP
TargetPort: 6443/TCP
Endpoints: 10.50.80.50:6443
Session Affinity: None
Events: <none>
Теперь чуть подробнее как развертывал кластер? через kubeam-config.yaml файл задавал конфигурации?
Grisha
сейчас попробую найти файл
Grisha
я уже нашел где я налажал
Grisha
spec:
containers:
- command:
- kube-apiserver
- --advertise-address=10.50.80.50
Grisha
а должен быть указан мой екстернал балансер
Denis
Смотри как поправить можна
Denis
сек
Denis
spec:
containers:
- command:
- kube-apiserver
- --advertise-address=10.50.80.50
Создаешь файл, к примеру: ClusterStatus.yaml cо следующим содержимым(беру из своего примера):
apiEndpoints:
kubernetes-master-0:
advertiseAddress: 192.168.0.20
bindPort: 6443
kubernetes-master-1:
advertiseAddress: 192.168.0.21
bindPort: 6443
kubernetes-master-2:
advertiseAddress: 192.168.0.22
bindPort: 6443
apiVersion: kubeadm.k8s.io/v1beta1
kind: ClusterStatus
Grisha
controlPlaneEndpoint: 10.50.80.241:6443 стоит верный
Denis
Потом kubeadm config upload from-file —config ClusterStatus.yaml
Grisha
[root@5050k8s-master home]# kubeadm config view
apiServer:
certSANs:
- 10.50.80.241
extraArgs:
apiserver-count: "3"
authorization-mode: Node,RBAC
timeoutForControlPlane: 4m0s
apiVersion: kubeadm.k8s.io/v1beta1
certificatesDir: /etc/kubernetes/pki
clusterName: kubernetes
controlPlaneEndpoint: 10.50.80.241:6443
controllerManager: {}
dns:
type: CoreDNS
etcd:
external:
caFile: /etc/etcd/ca.pem
certFile: /etc/etcd/kubernetes.pem
endpoints:
- https://10.50.80.50:2379
- https://10.50.80.51:2379
- https://10.50.80.52:2379
keyFile: /etc/etcd/kubernetes-key.pem
imageRepository: k8s.gcr.io
kind: ClusterConfiguration
kubernetesVersion: v1.14.0
networking:
dnsDomain: cluster.local
podSubnet: 10.244.0.0/16
serviceSubnet: 10.96.0.0/12
scheduler: {}
Grisha
мой мой конфиг, может я чего-то тут заблы?
Denis
controlPlaneEndpoint: 10.50.80.241:6443 > 10.50.80.50:6443 ?
Grisha
не 241 это адрес балансера