 Vadim


И редкий CI выдержит столько же реквестов как обычный кубернетес на 3х нодах
 Oleg
ну вот на вид клиенту надо передавать какой-то маленький запускатор в роли CI/CD, доступ к репо с конфигами приложения и доступ к докер-реджистри приложения. Деплоер узнает текущую версию системы, ищет в гитовом репо с конфигурациями следующую по тегу и применяет пока не нальется самая актуальная. Внутри каждой версии конфигурации прописана джоба с миграцией.
 𝚔𝚟𝚊𝚙𝚜
Не делайте миграции в init 🙈 Только землю греть лишними запусками, подумайте про экологию
Можно init'ом генерить джобу, Фть-ха!
Oleg
или паковать конфиги миграций с джобами отдельно и пускать их в первую очередь
 Anton
ну вот на вид клиенту надо передавать какой-то маленький запускатор в роли CI/CD, доступ к репо с конфигами приложения и доступ к докер-реджистри приложения. Деплоер узнает текущую версию системы, ищет в гитовом репо с конфигурациями следующую по тегу и применяет пока не нальется самая актуальная. Внутри каждой версии конфигурации прописана джоба с миграцией.
Какой то миграционный велосипед. Есть вроде взрослые решения, которые до актуального состояния приводят схему. Но это может быть вовсе не без остановки. Мало ли что там решат менять в бд.
Oleg
так просвяти
Anton
так просвяти
https://en.m.wikipedia.org/wiki/Schema_migration
Инструментов куча, может быть частью orm
 Ilya
Господа, подскажите, я могу как-нибудь в конфиг просунуть имя image при деплое?
Ilya
Оно у меня с версией меняется
𝚔𝚟𝚊𝚙𝚜
kubectl set image -f ./deploy.yaml nginx=nginx:1.9.1 --local -o yaml
давайте конкурс на самый извращенный пример)
Oleg
ты не понял про что я. я не про инструменты миграции базы как таковой а про организацию конфигураций для zero-downtime deployment. понятно что под капотом джобы liquibase или flyway
Anton
ты не понял про что я. я не про инструменты миграции базы как таковой а про организацию конфигураций для zero-downtime deployment. понятно что под капотом джобы liquibase или flyway
В чем проблема ее запустить, если известно что миграции не блокируют работу 💯
Oleg
Не то чтобы проблема, но вдруг появились стандартизированные практики и инструменты, на вид-то задача нужная каждому первому, кто делает софт с деплоем в кубер
Anton
Это какой то мутный кейс, когда приложение деплоят в частный цод, куда доступа нет? Стараюсь не думать о таких вариантах
Anton
И ещё нужно снабжать софт инструкцией, чтобы любой мог его развернуть, желательно через визард?
Oleg
Ну вот ты атлассиан к примеру и делаешь джиру. Дистрибутив под кубер. Хочешь чтобы у клиента все разворачивалось без единого разрыва.
Vadim
клиент их сразу пошлет, ибо у него уже какая-то система из говна и палок есть и менять её дорого
Oleg
У него в проде дистриб годовой давности
Vadim
максимум могут показать PoC на джобах в надежде что на новом проект клиент применит
Oleg
Ладно, это все оффтоп
Oleg
Спасибо всем
 Rainbow
У него в проде дистриб годовой давности
у gitlab открытая документация по всем процессам компании, можно смотреть. обновляется нормально. https://about.gitlab.com/handbook/
 Roman
Может у кого была такая проблема? https://github.com/terraform-providers/terraform-provider-helm/issues/20
* helm_release.dashboard: error creating tunnel: "could not find a ready tiller pod"
Roman
ладно хрен сним это только в первый раз произходит но вот это что:
secrets is forbidden: User "system:serviceaccount:default:dashboard-kubernetes-dashboard".
update: оказывается namespace прописать надо было
 Andrey
Доброго времени суток,
прикручиваю EFK (на fluentd) логирование на кубернет, видит/собирает/парсит логи не всегда.. не во всех неймспейсав.. и не со всех подов.
Подскажите куда смотреть?
 Nikolay
Доброго времени суток,
прикручиваю EFK (на fluentd) логирование на кубернет, видит/собирает/парсит логи не всегда.. не во всех неймспейсав.. и не со всех подов.
Подскажите куда смотреть?
Лог fluentd смотри. Там по умолчанию 2мб буфер.
Было такое же, пока не увеличил до 128, после этого все логи подтянулись очень быстро(больше 100кк записей)
 Olka
ещё бывает, что логов очень много, и если в конфиге флюента указано читать с начала файла, он из-за маленького буфера и размера очереди делает это очень долго, а иногда вообще с ошибкой падает
Andrey
Лог fluentd смотри. Там по умолчанию 2мб буфер.
Было такое же, пока не увеличил до 128, после этого все логи подтянулись очень быстро(больше 100кк записей)
2019-04-02 05:12:14 +0000 [warn]: Size of the emitted data exceeds buffer_chunk_limit.
2019-04-02 05:12:14 +0000 [warn]: This may occur problems in the output plugins `at this server.`
2019-04-02 05:12:14 +0000 [warn]: To avoid problems, set a smaller number to the buffer_chunk_limit
2
увеличил, теперь он говорит сделай меньше 😅
Andrey
ещё бывает, что логов очень много, и если в конфиге флюента указано читать с начала файла, он из-за маленького буфера и размера очереди делает это очень долго, а иногда вообще с ошибкой падает
не подскажешь что это за параметр? не читать сначала
Olka
read_from_head false
Nikolay
FLUENTD_BUFFER_CHUNK_LIMIT в env даемонсета добавь
Nikolay
До скольки увеличивал?
И версия флюентд какая?
 Denis
Всем привет! В kube-state-metrics увидел метрику:
kube_endpoint_address_not_ready
А если у меня к примеру в service указан external endpoint, то на него тоже будет эта метрика распространятся?
Andrey
по дефолту
- name: FLUENT_ELASTICSEARCH_BUFFER_CHUNK_LIMIT_SIZE
value: "2M"
- name: FLUENT_ELASTICSEARCH_BUFFER_QUEUE_LIMIT_LENGTH
value: "64"
было, увеличивал до 128 и 256, потом уменьшал, чем меньше ставил тем меньше подобных ошибок было
Andrey
image: fluent/fluentd-kubernetes-daemonset:elasticsearch
Nikolay
На версии 1.14 с размером чанка 256 - все ок, размер очереди не трогал.
Вообще плохо указывать имаджи без указания конкретной версии, если он рестартанет, а там imagepullpolicy: always - получишь другую версию latest сборки. А потом искать по хешу имаджей почему что-то сломалось или не так работает, такое себе занятие.
Andrey
конфиг был составлен до меня.. я вот привожу в порядок, но опыта мало..
Nikolay
Конфиг кастомный в конфигмапе?
Nikolay
Или только энв настроен?
Andrey
ещё такой вопрос.. в логах пишет
2019-04-02 05:31:00 +0000 [info]: reading config file path="/fluentd/etc/fluent.conf"
при этом идёт паттерн для парсинга логов и задаётся параметр:
read_from_head true
конфиг видимо тоже дефолтный.. где он может сидеть? чтобы править
Andrey
Конфиг кастомный в конфигмапе?
в конфиг-мап перенёс с другого сервера, но шаблоны не те что идут при ините пода..
Nikolay
Там написано же, все в /fluentd/etc
Туда и подключай. Вот только версия может быть разная и того что было, и того что у тебя сейчас, по этому надо отрывать руки тем кто latest имаджи указывает и маунтит кастомный конфиг.
Какая версия флюентд была, а какая сейчас?
Ищи старую и пиши тег явно
Andrey
буду пробовать на image: fluent/fluentd-kubernetes-daemonset:v0.12-debian-elasticsearch запустить
Andrey
Там написано же, все в /fluentd/etc
Туда и подключай. Вот только версия может быть разная и того что было, и того что у тебя сейчас, по этому надо отрывать руки тем кто latest имаджи указывает и маунтит кастомный конфиг.
Какая версия флюентд была, а какая сейчас?
Ищи старую и пиши тег явно
а вот где это /fluentd/etc? не совсем понимаю.. в под таких волумов не монтируется, нигде такого пути нет, в самой системе тоже не существует
Andrey
при этом конфиг оттуда есть
Nikolay
Он в поде, внутри
Andrey
т.е. нужно подмонтировать туда конфигмап загруженный в кубере?
Nikolay
Ага
Nikolay
Но я бы сначала посмотрел чем он от дефолтного отличается, хотя бы диффом
Andrey
Andrey
фигово когда пока ещё мало что понимаешь 😅
Andrey
на первый взгляд другие пути до pos_file /var/log/es-containers.log.pos -> pos_file /var/log/fluentd-containers.log.pos
Nikolay
Если нет документации и возможности узнать что и зачем было сделано, то делай сам сначала. Остальное допилишь по ходу дела, когда выяснится чего не хватает или когда вкуришь дифф конфигов
Andrey
спасибо, хоть какие-то логи побежали, есть куда дальше смотреть
Andrei
в облаке отвалилась одна нода, вопрос как в k8s вывести ее пока
 Sergei
kubectl cordon?
Andrei
kubectl cordon?
There are pending nodes to be drained:
aks-nodepool1-42616560-7
error: pods with local storage (use --delete-local-data to override): mongodb-mongodb-replicaset-0;
Andrei
ну и с --delete-local-data и с --ignore-daemonsets не вынести ноду
 Artyom
@SinTeZoiD
 Михаил
 Artyom
👌
Anonymous
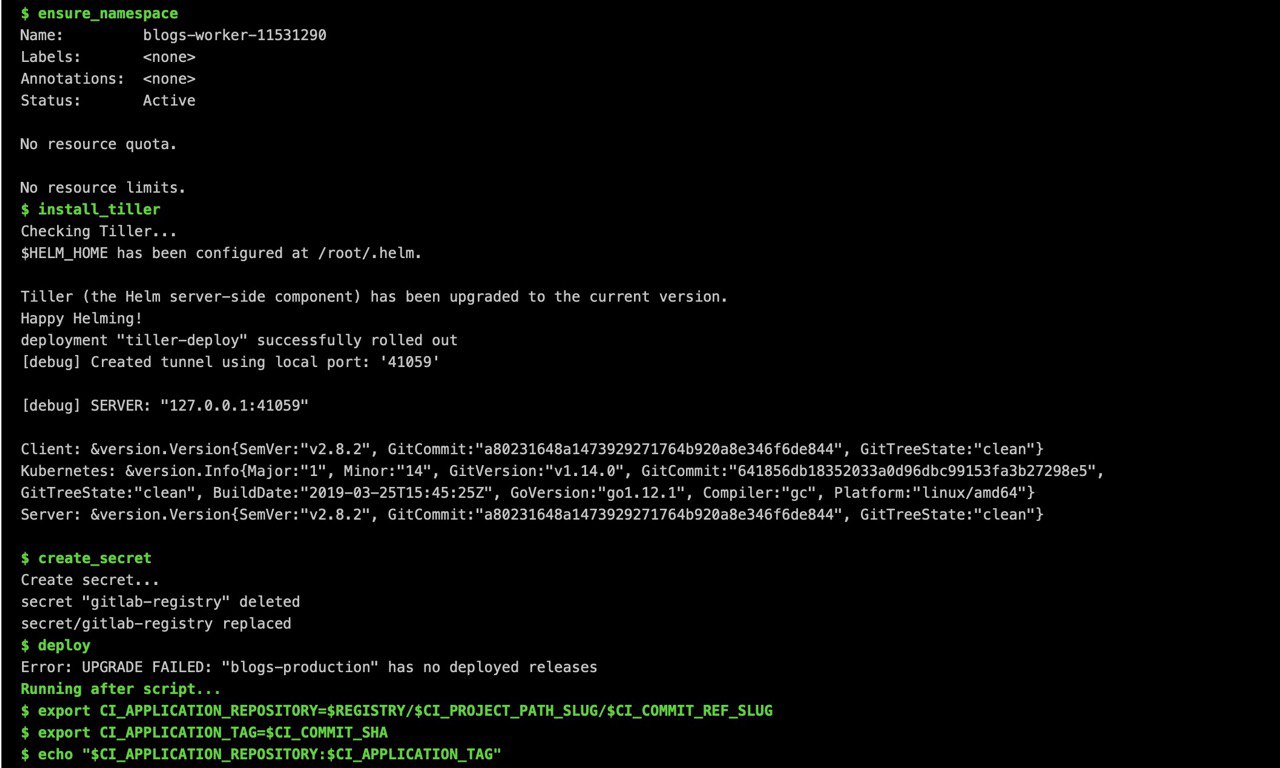
Кто кубик с гитлабом юзает. Возникла странность. При создании все ок а когда апгрейд делается вываливает ошибку.
Anonymous
 G72K
ну вот на вид клиенту надо передавать какой-то маленький запускатор в роли CI/CD, доступ к репо с конфигами приложения и доступ к докер-реджистри приложения. Деплоер узнает текущую версию системы, ищет в гитовом репо с конфигурациями следующую по тегу и применяет пока не нальется самая актуальная. Внутри каждой версии конфигурации прописана джоба с миграцией.
Если надо отдавать на сторону, то мне кажется все должно быть максимально примитивно: отдаем только образы и какие-нибудь примеры конфигов. Приложение при старте само делает миграцию. Многие (все?) миграторы берут правильные локи в базе сами , так что больше одного за раз базу месить не будет
G72K
G72K
у gitlab открытая документация по всем процессам компании, можно смотреть. обновляется нормально. https://about.gitlab.com/handbook/
А ещё они сломали всем нетривиальные пайплайны: https://gitlab.com/gitlab-org/gitlab-ce/issues/59703
Andrei
парни помогите плиз одна нода из за перегруза ресурсов отвалилась с кластера, я ее отправил в ребут но в облаке она пока не ало. Сейчас проблема в том что daemonsets что были на нем в состоянии NodeLost как их передеплоить если их pvc был тоже пожмонтирован к проблемной ноде
 Grigorii
парни помогите плиз одна нода из за перегруза ресурсов отвалилась с кластера, я ее отправил в ребут но в облаке она пока не ало. Сейчас проблема в том что daemonsets что были на нем в состоянии NodeLost как их передеплоить если их pvc был тоже пожмонтирован к проблемной ноде
зачем даемонсеты передеплоивать?
они на то и демонсеты
Andrei
зачем даемонсеты передеплоивать?
они на то и демонсеты
чтоб работали пока проблемной ноды нет в строю
Grigorii
они же на других нодах норм работают?
Grigorii
тогда проблема в чем не понял
Denis
парни помогите плиз одна нода из за перегруза ресурсов отвалилась с кластера, я ее отправил в ребут но в облаке она пока не ало. Сейчас проблема в том что daemonsets что были на нем в состоянии NodeLost как их передеплоить если их pvc был тоже пожмонтирован к проблемной ноде
в этом вопросе с pvc возможно @kvaps поможет
Andrei
тогда проблема в чем не понял
я вижу проблему в том что из за того что проблемная нода не была выведена даймонсеты пытаються на ней подняться а его нету
 Serega
ребят, это багафича такая, что переменные окружения видны всем подам в пределах неймспейса? даже если в самом деплойменте никаких переменных нет. Есть варианты отключить?
 Maksim
ребят, это багафича такая, что переменные окружения видны всем подам в пределах неймспейса? даже если в самом деплойменте никаких переменных нет. Есть варианты отключить?
В смысле? Переменные окружения вроде подключаются в деплоймент е
Serega
похоже что я затупил. Вопрос снят. Всё нормально ) переменные уникальные для каждого деплоя.