а можете рабочие how to посоветовать?
Могу поделиться скриптами. Но наверное уже не сегодня.
 Gennadiy

 Artem
О, было бы замечательно
Nikolay
а есть у кого-то под рукой утилитка, которая ивенты пересылает в эластик?
Евгений
а есть у кого-то под рукой утилитка, которая ивенты пересылает в эластик?
Fluent-bit, fluentd?
Sergey
curl
Nikolay
fluent цепляет логи, а к ивентам его подвязать у меня не получилось
Incognito
Я fluentd пересылаю эвенты и логи в спланк
Incognito
И метрики тоже
 Tadeusz
Incognito
Контора платит, почему быт нет :)
G72K
 Vadim
https://medium.com/@dominik.tornow/inside-kubernetes-rbac-9988b08a738a
G72K
https://medium.com/@dominik.tornow/inside-kubernetes-rbac-9988b08a738a
Какой то формализм ненужный. Не пейпер хаскелистов же
 Nik
Можно ли используя network policy ограничить трафик между неймспесами? или надо задать им сегменты сети напрямую и городить заборы между сегментами?
Sergey
 Rainbow
https://www.cncf.io/wp-content/uploads/2018/03/CNCF-Presentation-Template-K8s-Deployment.pdf
Rainbow
canary deployment, green/blue и тп техники в кубе.
G72K
 𝚔𝚟𝚊𝚙𝚜
 Andrey
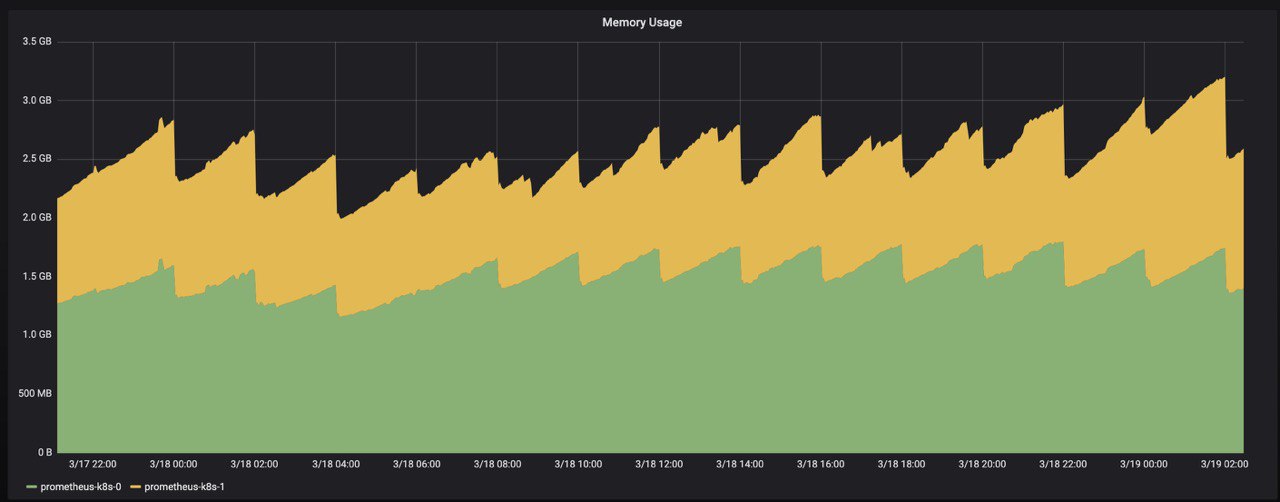
Ребят, кто юзает prometheus-operator в кубере. Сколько оперативы он у вас жрет?
Nikolay
Ребят, кто юзает prometheus-operator в кубере. Сколько оперативы он у вас жрет?
в мегабайтах под рукой нет, но меньше, чем энвои от istio
 Andor
Ребят, кто юзает prometheus-operator в кубере. Сколько оперативы он у вас жрет?
а сколько у тебя метрик?
Nikolay
иии... речь про сам оператор или в целом про весь его выводок? =)
Andrey
а сколько у тебя метрик?
Так сходу не скажу. Ставил тупо манифестов с гита.
Из стороннего в этом кластере только 22 пода. Т.е почти голый кластер.
Andrey
иии... речь про сам оператор или в целом про весь его выводок? =)
речь именно про поды прометея. У меня они жрут 1-2 гига оператвы и продолжают расти. Вот понять не могу, нормально ли это.
Andor
в церкви метрик лучше спрашивать
Andrey
 Andor
не про кубер вопрос
Andrey
в церкви метрик лучше спрашивать
ну вопрос скорее про то, нормально ли это. Мож там настроен он в стоке так чтобы жрать. Если не норм, пойду тогда мучать народ в метриках.
Andor
короткий ответ: это нормально
Andrey
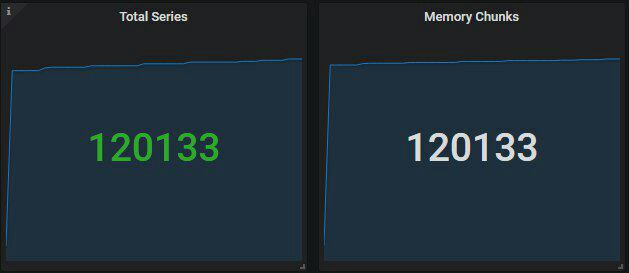
Интересно еще узнать, сколько он потребляет на более менее нагруженных кластерах, где штук 500-1000 подов. Неужели так и продолжает расти?
 Denis
Интересно еще узнать, сколько он потребляет на более менее нагруженных кластерах, где штук 500-1000 подов. Неужели так и продолжает расти?
У меня с такой статой почти 3 гига потребляет на пике.
Andor
а в секунду у тебя сколько сэмплов?
Andor
ну и запросы видимо на малое количество сэмплов и/или простые
Andor
тогда объяснимо
 Sergey
У меня с такой статой почти 3 гига потребляет на пике.
потребление памяти как и диска под базу индивидуально
Sergey
какого то шаблона для метрик по размерам нет
 Andrey
Интересно еще узнать, сколько он потребляет на более менее нагруженных кластерах, где штук 500-1000 подов. Неужели так и продолжает расти?
Самая большая проблема у прометея с потреблением памяти во время отрисовки графиков (раскушивался до 20гб), в этом случае хорошо помогает https://github.com/Comcast/trickster
 Отделение Bereke Bank
речь именно про поды прометея. У меня они жрут 1-2 гига оператвы и продолжают расти. Вот понять не могу, нормально ли это.
Ну так прометей пытается засунуть весь датасет в память же
 Stefan
https://www.cncf.io/wp-content/uploads/2018/03/CNCF-Presentation-Template-K8s-Deployment.pdf
а rollingupdate применим к поду, у которого одна реплика?
Rainbow
ну да. Если такое не нужно - есть recreate
Stefan
ну да. Если такое не нужно - есть recreate
то есть maxsurge должно быть 1, а maxunavailable 0?
Stefan
правильно я понимаю?
Rainbow
без понятия, оно так по-умолчанию сделает.
Rainbow
В смысле доку нужно читать. Меня по-умолчанию устраивает в 99% случаев.
Rainbow
Только readinessprobe нужны
Stefan
В смысле доку нужно читать. Меня по-умолчанию устраивает в 99% случаев.
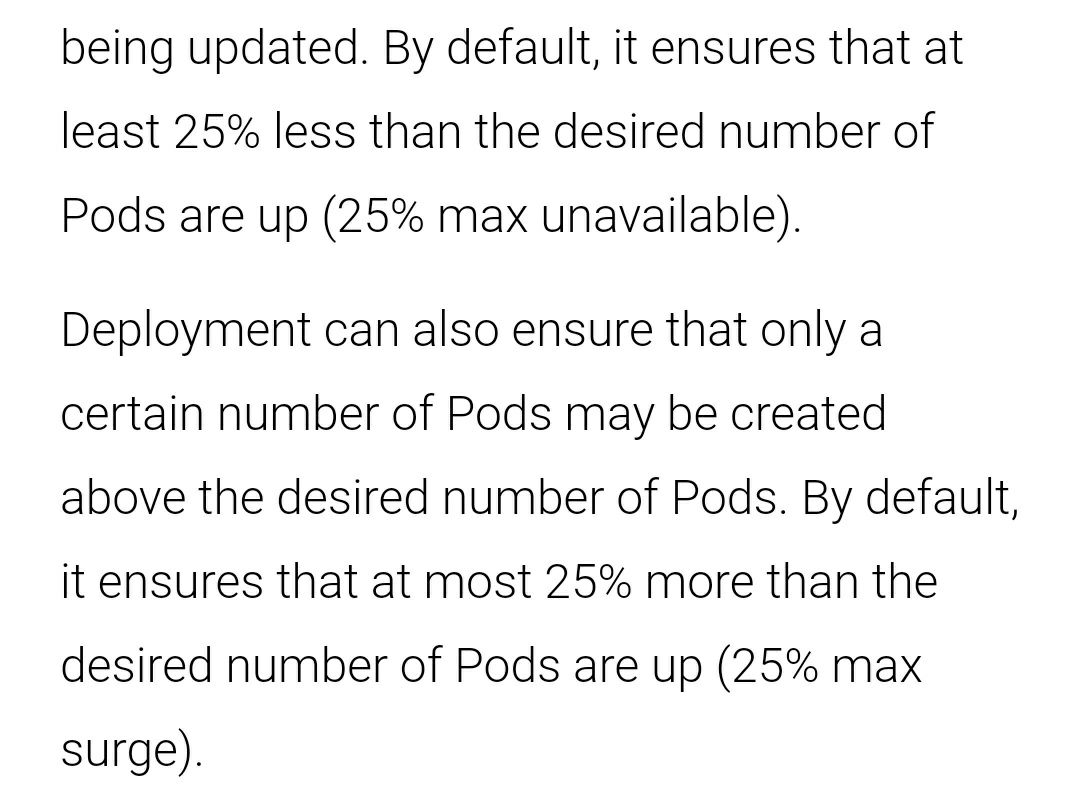
но ведь если читать тот материал, то там описано, что при обычном recreate приложение падает на определенное время
Stefan
а при роллинге аккуратно
Rainbow
recreate это не стратегия по-умолчанию
Stefan
recreate это не стратегия по-умолчанию
да ну, если ниче не указывать в делойменте, то таки дефолтная
 Stefan
пардон, не прав
Rainbow
Я не понимаю о чем ты. Стратегия по умолчанию RollingUpdate. Если сделать readiness, то будет zerodowntime
Stefan
Я не понимаю о чем ты. Стратегия по умолчанию RollingUpdate. Если сделать readiness, то будет zerodowntime
думал что recreate дефолтное
Stefan
а recreate == kubectl delete pod? а то вот я когда так делаю с подами, то как раз в таком случае появляется даунтайм
Rainbow
а recreate == kubectl delete pod? а то вот я когда так делаю с подами, то как раз в таком случае появляется даунтайм
чуть сложнее. Он будет ждать, пока все помрут. kubectl delete pod не остановит возрождение.
Stefan
Alexey
Всем привет. Поделитесь опытом, пожалуйста. У меня в проекте примерно 40 микросервисов, сейчас у каждого в своей репе helm chart. Количество сервисов растет неуклонно, они все очень связаны, то есть чтобы протестировать один из сервисов надо запустить как минимум 2-3 зависимости. Есть qa, которые пишут стабы чтобы тестировать конкретные сервисы изолированно. У меня задача построить пайплайн, конечная точка в пайплайне установка в окружение stage. Пока мысли такие, по киммиту для конкретно модуля создаем namespase запускаем там стабы и автотесты, далее если ок ставим в перманентное окружение dev в нем опять тесты и шаг review, после которого уже по кнопке в stage если версия компонента релизная. И ещё нормально ли пошарить чарты между репами сервисов через git submudules, хочется видеть их в одном месте, так же по сути в этом отдельном репе определить env vars для конкретных окружений. Если у вас что-то похожее прошу поделиться опытом пожалуйста.
R2
Всем привет. Поделитесь опытом, пожалуйста. У меня в проекте примерно 40 микросервисов, сейчас у каждого в своей репе helm chart. Количество сервисов растет неуклонно, они все очень связаны, то есть чтобы протестировать один из сервисов надо запустить как минимум 2-3 зависимости. Есть qa, которые пишут стабы чтобы тестировать конкретные сервисы изолированно. У меня задача построить пайплайн, конечная точка в пайплайне установка в окружение stage. Пока мысли такие, по киммиту для конкретно модуля создаем namespase запускаем там стабы и автотесты, далее если ок ставим в перманентное окружение dev в нем опять тесты и шаг review, после которого уже по кнопке в stage если версия компонента релизная. И ещё нормально ли пошарить чарты между репами сервисов через git submudules, хочется видеть их в одном месте, так же по сути в этом отдельном репе определить env vars для конкретных окружений. Если у вас что-то похожее прошу поделиться опытом пожалуйста.
Есть такая боль
Юзаем еще хелм чарт репу
При деплое основного сервиса на дев, остальные подливаются циклом из хелм репы
Alexey
мы по MR создаем изолированные стенды в раздельных namespace. Тоже хелм-репы используем
То есть обновился сервис один какой-то, сработал триггер и пошло создание свежего неймспейс куда ставится вся система?
 Slava
Коль уж пошла такая пьянка, связанная с хельмом и разными окружениями, может у кого найдётся годный ман по хельм чартам, где на одно приложение/систему надобно развернуть несколько деплойментов, зависящих друг от друга, и чтобы основные бизнесовые сервисы не апались, пока служебные не апнутся (пока что готовность служебных сервисов мониторим глазами и деплоимся kubectl'ом через темплейты и envsubst )
Alexander N.
То есть обновился сервис один какой-то, сработал триггер и пошло создание свежего неймспейс куда ставится вся система?
не совсем, у нас задача несколько проще. В основном для нужд разработки и qa - надо поднимать кучу стендов с продуктами параллельно, с разницей в ветке из которой собирались проекты. Для независимой разработки\тестирования новых фич. К примеру - создается новая ветка (master branch + feature) -> после MR в нее срабатывает триггер и либо создается копия инфраструктуры в новом namespace, либо он обновляется до новой версии
G72K
Stefan
народ, поделитесь опытом, пожалуйста
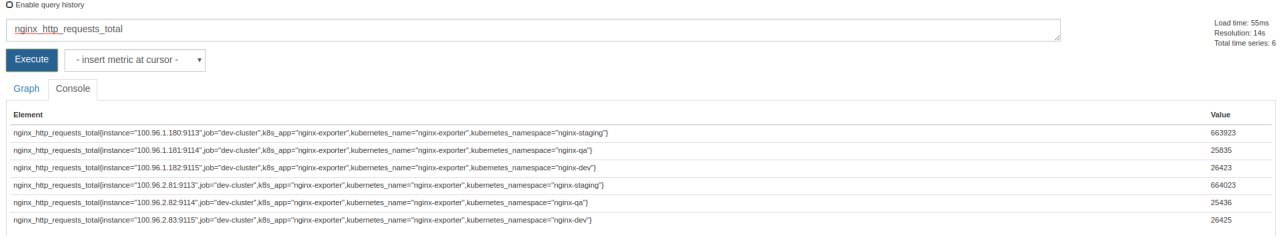
а как вы собираете метрики в прометее с двух и более nginx-ingress контроллеров, при помощи nginx-exporter?
есть такой аргумент у экспортера: -nginx.scrape-uri
как я понял, он подходит только если у меня один ингресс будет
есть такой вот daemonset и service:
https://pastebin.com/VRj7VTR9
но не заводится из-за ошибки(stub-status локейшен если че есть в конфигах ingress-cintroller-ов и слушается на 8080 порту):
Nginx Client: Failed to create NginxClient: failed to get http://127.0.0.1:8080/stub_status: Get http://127.0.0.1:8080/stub_status: dial tcp 127.0.0.1:8080: connect: connection refused
Stefan
народ, поделитесь опытом, пожалуйста
а как вы собираете метрики в прометее с двух и более nginx-ingress контроллеров, при помощи nginx-exporter?
есть такой аргумент у экспортера: -nginx.scrape-uri
как я понял, он подходит только если у меня один ингресс будет
есть такой вот daemonset и service:
https://pastebin.com/VRj7VTR9
но не заводится из-за ошибки(stub-status локейшен если че есть в конфигах ingress-cintroller-ов и слушается на 8080 порту):
Nginx Client: Failed to create NginxClient: failed to get http://127.0.0.1:8080/stub_status: Get http://127.0.0.1:8080/stub_status: dial tcp 127.0.0.1:8080: connect: connection refused
в общем решил так.. не знаю на сколько это правильный способ, но хотя бы добился того, что нужно было
1. добавил в каждый неймспейс ingress контроллеров nginx-exporter(у каждого разные порты)
2. указал в -nginx.scrape-uri название сервиса контроллера и порт 8080(который открыл в сервисе контроллера)
3. подкрутил в конфигмапе нжинкса allow 127.0.0.1 на 0.0.0.0 в локейшене stub_status, на который ходит экспортер
4. в каждом сервисе экспортера указал аннотацию prometheus.io/scrape: "true"
Stefan