Но CoreDNS — это cloud-native. Чем парируешь?
Тоже такое себе... Аргументный аргумент
 Oleg


 Alexey
 G72K
коду бинда - 35 лет
А башу 45 наверняка наберется :) бинд не кеширующий резолвер, а соверешенно из другой области, хоть и тоже про DNS
 Andrey
Не буду парировать, промолчу
У меня началась рефлексия по поводу выбора CoreDNS просто. Ты виноват.
Oleg
А башу 45 наверняка наберется :) бинд не кеширующий резолвер, а соверешенно из другой области, хоть и тоже про DNS
Ну отчего же. Его можно использовать как кеширующий ДНС
G72K
Ну отчего же. Его можно использовать как кеширующий ДНС
Ну вот и баш с его /dev/tcp можно, но зачем?
Oleg
Клауд нейтив баш?
 Aleksander
ребята, есть ли в кубернетесе встроенный функционал по отправке email'ов, если у pod'ы не срабатывает health check?
G72K
ребята, есть ли в кубернетесе встроенный функционал по отправке email'ов, если у pod'ы не срабатывает health check?
С fail2ban легко делается, но нынче вам посоветуют Prometheus + alertmanager
 Даня
😂
Aleksander
нужен именно встроенный, заказчик не желает видеть прометея
G72K
нужен именно встроенный, заказчик не желает видеть прометея
Поставьте Прометей, скажите был встроен, а заказчик будет видеть емайлы
Aleksander
Поставьте Прометей, скажите был встроен, а заказчик будет видеть емайлы
невозможно к сожалению
Aleksander
вообще у нас openshift, но как я понимаю, он в данном случае не дает преимущества - там все равно нет встроенного функционала
G72K
Ну так и встроенными средствами невозможно. Итого перед заказчиком две невозможности, он может выбирать любую
Aleksander
 Kirill
Заказчик не желает и хочет, чтобы придумали какой-нибудь другой вариант взамен стандартного...
Aleksander
я им предложил кастомное приложение, которое внутри опрашивает kubernetes api, там можно будет накрутить подходящую логику. Но добро тоже не дали 😔
Kirill
:DDDD
Aleksander
ребят, а какие разрешения нужны, чтобы используя kubernetes api получить список всех под?
вот тут например они получают все поды в примере в ридми
Aleksander
https://github.com/kubernetes-client/java
G72K
ребят, а какие разрешения нужны, чтобы используя kubernetes api получить список всех под?
вот тут например они получают все поды в примере в ридми
apiversion "", resources: [nodes], verbs: [list]
G72K
поясни пожалуйста, я не понял
https://kubernetes.io/docs/reference/access-authn-authz/rbac/#api-overview
Anonymous
Коллеги. а подскажите, кто знает - а для чего kubernetes api доступно по 443 порту ?
Что мешает его оставить на "почти стандартном порту 6443" ?
Суть проблемы:
Имею мастер ноду, на которую ставлю traeik-ingress
ingress вешается на все интерфейсы, это блокирует доступ подов к API кубера (tcp://10.233.0.1:443)
Вот хочу понять - нормально ли такое поведение.
R2
ничего не мешает
R2
{
"kind": "APIVersions",
"versions": [
"v1"
],
"serverAddressByClientCIDRs": [
{
"clientCIDR": "0.0.0.0/0",
"serverAddress": "10.20.10.61:6443"
}
]
}
R2
вопрос по трафику (traefik)
кто-то конфижил, чтобы он кушал большие посты ?
бо отвечет 413 entity too large
дока не очень помогла
R2
дока говорит в сервисе на который пуляем большие запросы добавить
ингресс должен скушать
apiVersion: v1
kind: Service
metadata:
annotations:
kubernetes.io/ingress.class: traefik
traefik.ingress.kubernetes.io/buffering: |-
maxrequestbodybytes: 104857600
memrequestbodybytes: 20971530
maxresponsebodybytes: 104857610
memresponsebodybytes: 20971520
retryexpression: IsNetworkError() && Attempts() <= 2
что-то типа того, но не работает
Anonymous
{
"kind": "APIVersions",
"versions": [
"v1"
],
"serverAddressByClientCIDRs": [
{
"clientCIDR": "0.0.0.0/0",
"serverAddress": "10.20.10.61:6443"
}
]
}
Это к /apis/ запрос ?
через kubectl get apiservices v1. -o yaml не вижу serverAddressByClientCIDRs
 Alex
Привет, всем! Может кто нибудь поделиться плейбуком по установке кубера (двухузловой кластер - один мастер и 2-ве ноды)
Anonymous
Alex
плейбук)
Kirill
Или хочется готовый просто?)
Alex
ну может у кого готовый есть) был бы благодарен)
 Cутулая
Кто юзает k8s от DO?
Сейчас проблемы какие-то есть? По-моему регион FRA1 тупит)
Даня
🙂🙂🙂
 Alex
Кто юзает k8s от DO?
Сейчас проблемы какие-то есть? По-моему регион FRA1 тупит)
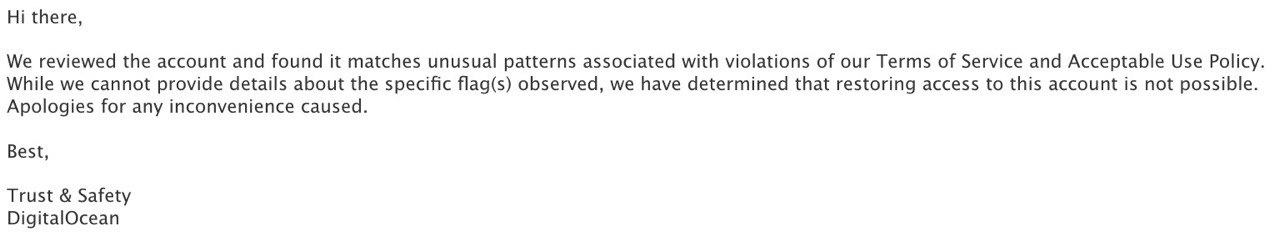
немного их похейчу - забанили без объяснения причин аккаунт, зареганный через TOR =/
Cутулая
немного их похейчу - забанили без объяснения причин аккаунт, зареганный через TOR =/
Представь себе сколько у них таких аккаунтов для спама и всяких порнухи.. ах, еще телеграм прокси :D
Alex
Представь себе сколько у них таких аккаунтов для спама и всяких порнухи.. ах, еще телеграм прокси :D
 Edouard
Еще хорошо что они с РФ работают в-целом. Часто бывает
due to legal trade restrictions with your country of residence,
we currently cannot process your order
и привет
Alex
ну блин, у hetzner cloud например таких проблем нет =/
 Eduard
Кто юзает k8s от DO?
Сейчас проблемы какие-то есть? По-моему регион FRA1 тупит)
я юзаю, просадок сегодня не было
Eduard
я ж алертинг получаю )
Leo
эм, как же Германия?
Nikolay
так fra это франкфурт
Leo
пора спать)
Eduard
Го лабать 😄
 Rainbow
> к слову о хезнере, у нас вся проблема с игровой базой из за них, мы в пятницу тикет написали о том что проблемы с сетью
> буквально через 10 мин нам перезагружают сервер
> с рабочим сервером
> мы им пишем какого фига, а они "это не мы"
> это у вас само так
Из последних приколов.
 Etki
у знакомого железо начало отказывать, они попросили прийти, когда даунтайм будет шесть-восемь часов
Alex
Rainbow
dedicated
Alex
а, ну там да, потенциально такое может быть )
Alex
хотя я с перерывами (иногда на пару лет) уже лет 8 юзаю – в принципе ни разу проблем не было, но учитывая специфику – реально как повезет
Alex
cloud юзаю примерно год – пока всё хорошо, как-то рандомно ребутнули, но это не страшно
 A1EF
Ха, у меня недавно тоже в хецнере история веселая была (правда, в Финляндии дедик). Стал смарт ругаться, ну я вижу, что хотсвапа в админке нет. Вывел из рейда сбойный диск и тикет завел на замену с ребутом. Заменили и пишут -- сделали. Я смотрю, а у меня ssh-сессия не отвалилась. Смотрю диски новый есть -- заменили, а старый (второй рабочий) -- отсутствует! Ну и системе резко поплохело, конечно. Я пишу, мол, что за дела? Ответ -- мы заменили хотсвапом, но некоторым системам нужно ребут делать. Ребутнулся -- старый диск появился, разбил новый на разделы и вернул в рейд... но осадочек остался:))
 Anton
хотсвапы, хотсвапы. В IBM просто присылают сообщение: "чуваки, у вас диск сдох, пересоздайте VM с нуля"
 🦠
История про то, как люди в хецнере кайфуют
Edouard
Недавно, Хетцнер. Дедик, хардварный raid.
У вас умер райд и все диски. Ничего не выжило. Не благодарите. Прощай, один из dev-серверов)
Anonymous
хотсвапы, хотсвапы. В IBM просто присылают сообщение: "чуваки, у вас диск сдох, пересоздайте VM с нуля"
Именно в самом IBM или в Водафоне?
mb
Ха, у меня недавно тоже в хецнере история веселая была (правда, в Финляндии дедик). Стал смарт ругаться, ну я вижу, что хотсвапа в админке нет. Вывел из рейда сбойный диск и тикет завел на замену с ребутом. Заменили и пишут -- сделали. Я смотрю, а у меня ssh-сессия не отвалилась. Смотрю диски новый есть -- заменили, а старый (второй рабочий) -- отсутствует! Ну и системе резко поплохело, конечно. Я пишу, мол, что за дела? Ответ -- мы заменили хотсвапом, но некоторым системам нужно ребут делать. Ребутнулся -- старый диск появился, разбил новый на разделы и вернул в рейд... но осадочек остался:))
Ах-ха-ха, в хетцнере хоть меняют, если основания есть (вывод smart-а запрашивают). Родного нашего хостера уговаривать пришлось пару дней, чтобы подыхающий хард заменили. В брендовом млять серваке.
 Dmitry
> к слову о хезнере, у нас вся проблема с игровой базой из за них, мы в пятницу тикет написали о том что проблемы с сетью
> буквально через 10 мин нам перезагружают сервер
> с рабочим сервером
> мы им пишем какого фига, а они "это не мы"
> это у вас само так
Из последних приколов.
На одном из наших серверов кнопка выключения так разболтана (оказывается), что срабатывала, если сотрудник датацентра открывал стойку и делал что-то с каким-нибудь другим сервером в ней (нам показывали видео после того шума, который мы подняли видя выключения по кнопке в логах ipmi)
Alexander
Привет
Кто-то сталкивался с подобной ошибкой?
error: arguments in resource/name form must have a single resource and name
ERROR: Job failed: exit code 1
Anonymous
не совсем понимаю, причём тут водафон. Да, в самом IBM
У них очень интересные отношения. Например в индии водафоном рулит IBM.
Oleh
Привет
Кто-то сталкивался с подобной ошибкой?
error: arguments in resource/name form must have a single resource and name
ERROR: Job failed: exit code 1
Была такая когда yaml криво сгенерился
Oleh
Скомпилируйте ваши тимплейты и посмотрите что там получается, можно еще вручную их подеплоить для теста
Alexander
Была такая когда yaml криво сгенерился
Понять бы ещё в каком месте он криво сгенерился. Скоро сяду за комп, буду разбираться
Oleh
Ну вот kubectl apply -f конкретные строчки говорил