Alexey Yurchenko - секретарь домохазяек ;)
https://liganews.net/images/news/ae0c3e42c2db1e2af6664389a034b6f7.jpg завидую интеллекту
 Rainbow


 Dmitrii
Кто-нибудь недавно кластер kubespray'ем раскатывал, натыкались на проблемы с DNS в alpine-имейджах? Похоже из-за ndots:5 все еле резолвится, cert-manager и nginx-ingress не работают.
 Andrey
Кто-нибудь недавно кластер kubespray'ем раскатывал, натыкались на проблемы с DNS в alpine-имейджах? Похоже из-за ndots:5 все еле резолвится, cert-manager и nginx-ingress не работают.
Это долгоиграющая бага в ведре линуха
https://github.com/kubernetes/kubernetes/issues/56903
 Andrey
Неа. https://www.weave.works/blog/racy-conntrack-and-dns-lookup-timeouts
Ух ты. Не resolver, а netfilter. Спасибо.
 Antlar
 Andrey
Ух ты. Не resolver, а netfilter. Спасибо.
Один патч из этой статьи уже смерджили, но второй уже несколько месяцев застрял в статусе "under review" и, похоже, это навсегда
yolkov
там несколько статей есть)
yolkov
в калико без ipvs таже проблема
Andrey
у меня калико с ipvs и таки этой проблемы нет, да
yolkov
https://tech.xing.com/a-reason-for-unexplained-connection-timeouts-on-kubernetes-docker-abd041cf7e02
https://blog.quentin-machu.fr/2018/06/24/5-15s-dns-lookups-on-kubernetes/
Dmitrii
Я просто поднял на aws'е с aws-ной cni - проблема вылезла, хотя на хетцнерклауде с калико такого не наблюдается. Думал может кто воркэраунды знает.
Andrey
Я просто поднял на aws'е с aws-ной cni - проблема вылезла, хотя на хетцнерклауде с калико такого не наблюдается. Думал может кто воркэраунды знает.
дык по ссылкам выше воркэраундов сколько хочешь
Andrey
Я просто поднял на aws'е с aws-ной cni - проблема вылезла, хотя на хетцнерклауде с калико такого не наблюдается. Думал может кто воркэраунды знает.
Попробуй первым делом ipvs заюзать, кстати
 Никита
 Max
Может с сетью, но на бриджах? Тогда у каждого пода будет свой ИП, но не будет оверхедов от оборачивания пакетов в другие пакеты. У @kvaps так все настроено
интересно узнать, что kvaps использует у себя для этого
 Denis
интересно узнать, что kvaps использует у себя для этого
Если не ошибаюсь, то вот
https://github.com/kvaps/bridget
Vladimir
Коллеги, а что порекомендуете для вот такого кейса ?
Сама kubernetes инфраструктура размещена в приватном облаке, вычислительный ресурсы для нее хочется подключать динамически из публичных облаков (amazon, gcp итд), по требованию.
Vladimir
Нужно чем-то автопровижинить новые ноды и включать их в класте пока они нужны, если потребность исчезла в них - отключать.
 Vladimir
тухлая идейка
Max
Если не ошибаюсь, то вот
https://github.com/kvaps/bridget
вряд ли это подойдет для моего юзкейса.
Все cni для куба динамически выдают ip-адреса из одной, указанной при запуске куба подсети.
А у меня этих сетей может быть несколько.
Vladimir
Коллеги, а что порекомендуете для вот такого кейса ?
Сама kubernetes инфраструктура размещена в приватном облаке, вычислительный ресурсы для нее хочется подключать динамически из публичных облаков (amazon, gcp итд), по требованию.
при обрыве связи поды остаются наедине друг с другом без контроля
Vladimir
без контроля = без восстановления, без масштабирования
Vladimir
при обрыве связи поды остаются наедине друг с другом без контроля
Да, такой риск не исключить. Также не ясно на чем оверлейную сеть строить
Vladimir
А так, terraform, packer, ansible вот это всё
Max
а можно ли запустить куб вообще без оверлейной сети?
Max
если не нужна связь между подами
Max
именно подами нод, а не мастеров
 𝚔𝚟𝚊𝚙𝚜
вряд ли это подойдет для моего юзкейса.
Все cni для куба динамически выдают ip-адреса из одной, указанной при запуске куба подсети.
А у меня этих сетей может быть несколько.
ты хочешь назначать контейнерам адреса статически? - я тебе уже несколько раз предлагал использовать pipework для этого. Какой у тебя CRI?
Max
я посмотрел pipework
𝚔𝚟𝚊𝚙𝚜
ну так в чем проблема?
Max
я слишком тупой, чтобы понять, как это работает(
Max
хочу нанять сисадмина для вот таких вот задач, но я без понятия в какую сторону копать)
Max
чтобы он не разбирался с кубом месяц
𝚔𝚟𝚊𝚙𝚜
сначала запускаешь демонсет с pipework:
https://github.com/dreamcat4/docker-images/blob/master/pipework/3.%20Examples.md#kubernetes
он запускается на всех нодах и слушает docker сокет, как только он видит контейнер с переменной
pipework_cmd="br0 @CONTAINER_NAME@ 192.168.1.101/24@192.168.1.1"он пробрасывает интерфес в него и конфигурит ip: 192.168.1.101/24, gateway: 192.168.1.1
𝚔𝚟𝚊𝚙𝚜
вместо бриджа br0 можно указать обычный мнтерфес - eth0, тогда вместо veth-пары будет создан macvlan, но по опыту скажу, что в виду динамической природы Kubernetes, бриджи работают чуть стабильнее, ибо их проще диагностировать в случае возникновения каких-либо сетевых проблем
Олег
подскажите, что в анотациях ингрес нужно указать
при отправке POST запроса, если тело ~1K, то получаю 504
Max
вместо бриджа br0 можно указать обычный мнтерфес - eth0, тогда вместо veth-пары будет создан macvlan, но по опыту скажу, что в виду динамической природы Kubernetes, бриджи работают чуть стабильнее, ибо их проще диагностировать в случае возникновения каких-либо сетевых проблем
огромное спасибо, попробую сейчас поиграться с этим
𝚔𝚟𝚊𝚙𝚜
@Maxpain177 кстати, мой bridget + ipvs + metallb очень даже годное решение получается и без оверлеев
𝚔𝚟𝚊𝚙𝚜
т.к. speaker будет анонсить айпишник всегда с той же ноды где и workload
Max
@Maxpain177 кстати, мой bridget + ipvs + metallb очень даже годное решение получается и без оверлеев
круто) а ты замерял разницу в производительности по сравнению с calico, например?
𝚔𝚟𝚊𝚙𝚜
я особо не юзал calico, у меня была romana, потом я переключился полностью на bridget, тоже искал решения без оверлейных сетей
𝚔𝚟𝚊𝚙𝚜
у бриджей производительность почти нативная
 Михаил
если лютого хайлоада нет, то норм
Max
т.к. speaker будет анонсить айпишник всегда с той же ноды где и workload
сорри за тупой вопрос. а как именно оно анонсит ip-адрес, arp-пакетами?
Михаил
я про них же
Михаил
из бонусов бриджа - железобетонность)
Михаил
и простота
𝚔𝚟𝚊𝚙𝚜
Ну мы юзаем в 10G сети, проблем с производительностью у нас нет. У нас хостинг - вполне себе хайлоад.
𝚔𝚟𝚊𝚙𝚜
сорри за тупой вопрос. а как именно оно анонсит ip-адрес, arp-пакетами?
вопрос вовсе не тупой, да, как только speaker видит что пришел запрос на определенный IP и если нужный workload запущен на этой ноде, то отвечает
Max
вопрос вовсе не тупой, да, как только speaker видит что пришел запрос на определенный IP и если нужный workload запущен на этой ноде, то отвечает
мне надо будет еще поднапрячь наших ребят сделать возможность менять маршруты по требованию. то есть мы анонсим по bgp наши блоки ip-адресов с разных дц. и я хочу деплоймент с некоторым ip-адресом удалить и создать на другом дц с тем же ip-адресом
𝚔𝚟𝚊𝚙𝚜
𝚔𝚟𝚊𝚙𝚜
потому что pipework это конечно тот еще костыль, но тем не менее он вполне рабочий
𝚔𝚟𝚊𝚙𝚜
ну вот, на роутинг все и уходит
 Vadim
 Andrey
А, вижу. Картинка не грузилась.
Vadim
Мы пользовались. А какой кейс?
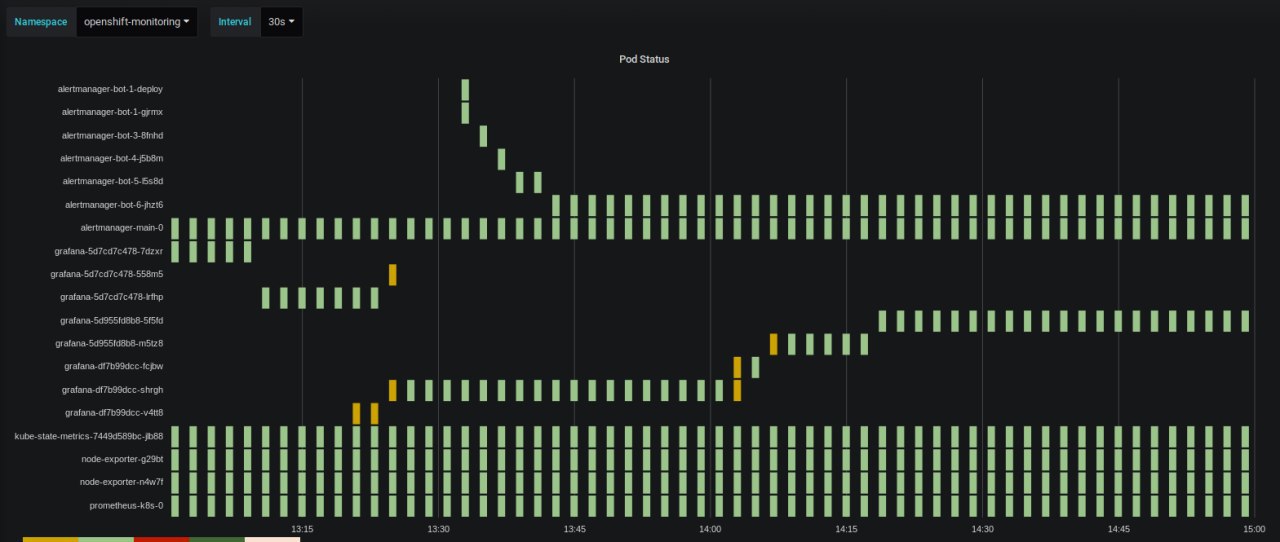
показывать статус подов. Вроде разобрался, для этого потребовалось забыть README
Andrey
Vadim
потому что там какая-то отвлеченная ерунда про кофемолки
Vadim
Т.е. мне не звать разработчика? :)
сам сделаю пулреквест если допилю такую же для статуса контейнера :)
Andrey
сам сделаю пулреквест если допилю такую же для статуса контейнера :)
Окей, пишите, делайте issue и pull request'ы. Мы всё поддерживаем в нашем github.
(почти всё)
Vadim
Окей, пишите, делайте issue и pull request'ы. Мы всё поддерживаем в нашем github.
(почти всё)
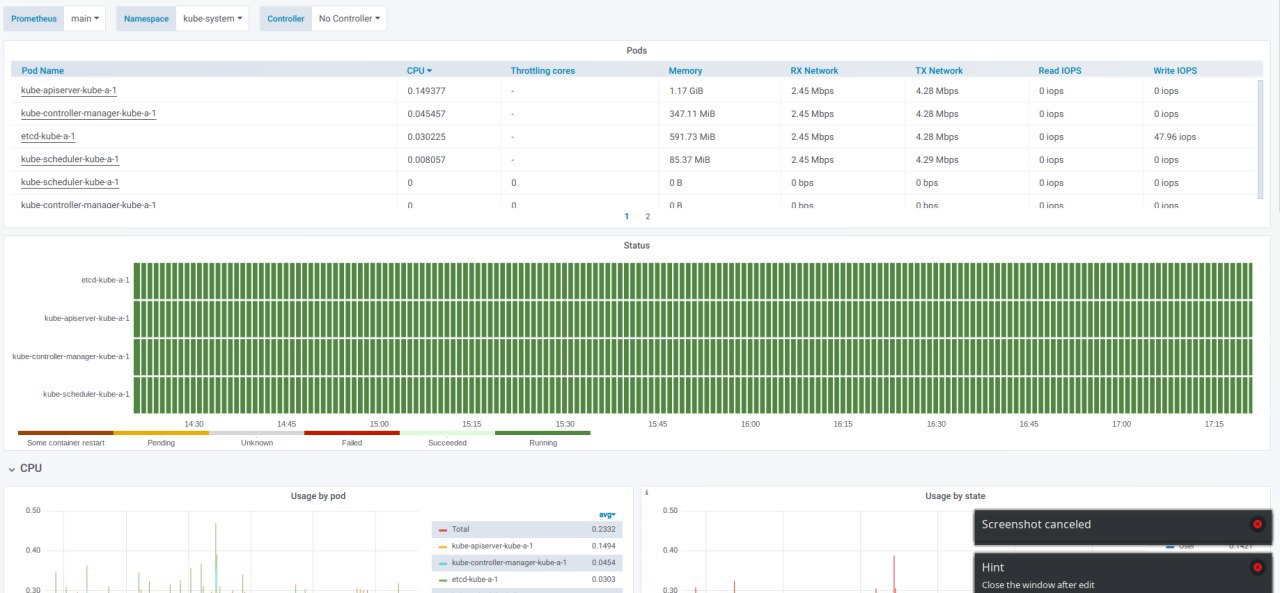
Спасибо. Мой вариант - это просто дашборда для дефолтного prometheus + kube-state-metrics, не знаю подойдет ли оно для репозитория с плагином
Andrey
Спасибо. Мой вариант - это просто дашборда для дефолтного prometheus + kube-state-metrics, не знаю подойдет ли оно для репозитория с плагином
 Vadim
Andrey
ага, у меня примерно такое же (только статистика по контейнерам более показательная имхо, Completed от OOMKill отличать)
С OOMKill'ом грустно, конечно. Ибо детектится только смерть PID 1 от SIGKILL.
Vadim
С OOMKill'ом грустно, конечно. Ибо детектится только смерть PID 1 от SIGKILL.
зачем, прометеус об этом сообщит, будет другой reason для смерти контейнера.
Итого https://github.com/flant/grafana-statusmap/pull/39
Andrey
зачем, прометеус об этом сообщит, будет другой reason для смерти контейнера.
Итого https://github.com/flant/grafana-statusmap/pull/39
Не будет, если умрёт другой процесс внутри контейнера. Не PID 1.
Vadim
а хмм, ну вот не надо так
 dmitriy
Подскажите как в ингресс поменять заголовки. В частности очень беспокоит proxy_set_header X-Real-IP $remote_addr;. Через сниппет он добавляется второым в nginx и похоже игнорится по этому. Через configmap пробовал use-proxy-protocol:true. Вообще падает ингрес почему-то.
Andrey
С форкающимися вещами очень некрасиво это всё работает. А это, зачастую, чище, чем 1000 подов плодить за одним сервисом.
G72K
Не будет, если умрёт другой процесс внутри контейнера. Не PID 1.
Если умер другой процесс и liveness check не пострадала, то приложение справилось и можно продолжать считать его здоровым :)
Andrey
Если умер другой процесс и liveness check не пострадала, то приложение справилось и можно продолжать считать его здоровым :)
Вот только реквест вывалиться с 500 или message вернётся в message queue. В любом случае, крутить resources нужно, но чистой метрики пока нет. У меня есть идея, что нужно напилить в cAdvisor, но времени пока нет.