Да пофиг на аписервера, мне б что б нормально работающие контейнеры продолжали светиться в ингресе/ендпоинтах. Например чтобы поды NotReady не делать, но тогда внутренние запросы буду через раз работать для "законно" отвалившихся нод. Похоже надо вешать финалайзеры на endpoints и убирать их только когда нода из NotReady выходит (или удаляют ее совсем) вобщем относиться к endpoints как к персистент вольюмам :)
смысл в том чтобы не давать лезть в сломанный аписервер, вот только определить что ему плоховато трудно
 Vadim


 G72K
Но это же и есть локалхост, если грубо.
Завернет туда где есть ендпоинты на момент когда местный куб-прокси последний раз общался с аписервером
 Andrey
Завернет туда где есть ендпоинты на момент когда местный куб-прокси последний раз общался с аписервером
Так получилось, что последний раз он как раз и был на локальной ноде. :3
G72K
смысл в том чтобы не давать лезть в сломанный аписервер, вот только определить что ему плоховато трудно
Ну разные подходы могут быть. По мне так спасать аписервер или думать о нем надо после того как обеспечили что б приложения работали. Проеб был что сертификаты обновил но не те, а те просрочились тихо и разом везде. Пока паниковал обновил все так, что сервис аккаунт публичный ключ перезатер :) короче там волнами пиздец набегал и в перерывах что-то где-то прорвалось :)
Vadim
для любителей совать свои серты у нас есть https://github.com/openshift/service-serving-cert-signer, правда я еще только догоняю как оно правильно работает
G72K
Vadim
back to docker-compose!
Vadim
двигающиеся части автоматизированы однако
Leo
Добрый, кто что под prometheus persistent volume юзает?
 Oleg
Leo
скажем так, терять метрики не очень желательно, все будет на bare metal
Leo
с другой стороны, что то жирное держать не очень хочется)
Leo
потому что почти все кроме прометея stateless)
G72K
Вобщем, пока не уснул план такой, как посплю может пойму что хуйню сморозил:
- на нодах для кублетов и kube-proxy сделать нормальный L7 балансер до аписервер
- развешивать финалайзеры на всех endpoints, удалять их только когда нода выходит из NotReady или ее удаляют , это сохранит записи в ингресе. Сам ингресс хелсчекит поды и подвешенные записи не будут мешать, если под жив на самом деле
- "зависшие" из-за финалайзера ендпоинты будут мешать общаться внутри кластера, надо L7 балансер внутри подов сайдкаром (но без istio, кажется были менее инвазивные штуковины на енвое)
Leo
видел как то, что раскатывают ceph + kuber на одной ноде, не пробывал никто?
Andrey
видел как то, что раскатывают ceph + kuber на одной ноде, не пробывал никто?
Изоляция так себе получается. Мы, обычно, отделяем Kubernetes ноды в виртуалки, а на гипервизоре ставим Ceph (ограниченный).
Leo
Vadim
Вобщем, пока не уснул план такой, как посплю может пойму что хуйню сморозил:
- на нодах для кублетов и kube-proxy сделать нормальный L7 балансер до аписервер
- развешивать финалайзеры на всех endpoints, удалять их только когда нода выходит из NotReady или ее удаляют , это сохранит записи в ингресе. Сам ингресс хелсчекит поды и подвешенные записи не будут мешать, если под жив на самом деле
- "зависшие" из-за финалайзера ендпоинты будут мешать общаться внутри кластера, надо L7 балансер внутри подов сайдкаром (но без istio, кажется были менее инвазивные штуковины на енвое)
кто-то делал haproxy как локальный балансер, но имя уже не вспомню, вроде работало
G72K
G72K
Evil martians
 Andrey
ceph-mds только по памяти разжирается, но там сколько дашь, столько и набьёт, ибо кэш.
Andrey
Да и то не факт, что тебе CephFS нужен.
Leo
что то мне кажется в моем случае лучше взять 3 лишних блейда и забить по 2/4 ssd)
Andrey
что то мне кажется в моем случае лучше взять 3 лишних блейда и забить по 2/4 ssd)
Тогда можно и NFS. И быстрый и гораздо менее прихотливый.
Leo
Тогда можно и NFS. И быстрый и гораздо менее прихотливый.
вроде nfs не очень сильно стыкуется с “не терять метрики”)
Andrey
Но management overhead там дикий в начале пути.
Leo
glasterfs попроще вроде
Leo
или очень уныл?
Andrey
Честно говоря, не пробовали. Ceph решил все виды network storage на бюджетных инсталляциях.
Олег
подкжите, как победить такую ошибку
2018-12-06 03:46:02.992 [info] <0.203.0> Failed to get nodes from k8s - {failed_connect,[{to_address,{"kubernetes.default.svc.cluster.local",443}},
{inet,[inet],nxdomain}]}
2018-12-06 03:46:02.992 [error] <0.202.0> CRASH REPORT Process <0.202.0> with 0 neighbours exited with reason: no case clause matching {error,"{failed_connect,[{to_address,{\"kubernetes.default.svc.cluster.local\",443}},\n {inet,[inet],nxdomain}]}"} in rabbit_mnesia:init_from_config/0 line 164 in application_master:init/4 line 134
2018-12-06 03:46:02.992 [info] <0.33.0> Application rabbit exited with reason: no case clause matching {error,"{failed_connect,[{to_address,{\"kubernetes.default.svc.cluster.local\",443}},\n {inet,[inet],nxdomain}]}"} in rabbit_mnesia:init_from_config/0 line 164
Олег
этот же конфиг, в другом кластере нормально работает
 Rainbow
вроде nfs не очень сильно стыкуется с “не терять метрики”)
... два Прометея на разные ноды и все, не?
 Egor
Доброго дня. Случайно никто не в курсе, в след. году не намечаются ли курсы по куберу?
 Mikhail
Не вырулил капитан
 Victor
Б
yolkov
кто-то делал haproxy как локальный балансер, но имя уже не вспомню, вроде работало
Букинг(envoy), авито
 Михаил
кто-то делал haproxy как локальный балансер, но имя уже не вспомню, вроде работало
все периодически делают)
G72K
Я дважды перечитал и не понял нахуя
Меры по предотвращению пиздеца, когда control plane штормит.
Vadim
https://github.com/gravitational/cve-2018-1002105
 Vadim
Почему-то не могу найти поды после того, как запустил их в statefulSet. можете глянуть, что не так?
headless service
apiVersion: v1
kind: Service
metadata:
name: couchnode1
labels:
name: couchnode1
spec:
selector:
name: couchnode1
clusterIP: None
ports:
- port: 30985
name: client
statefulSet
apiVersion: apps/v1beta1
kind: StatefulSet
metadata:
name: couchnode1
spec:
serviceName: "couchnode1"
replicas: 1
template:
metadata:
labels:
name: couchnode1
spec:
terminationGracePeriodSeconds: 10
containers:
- name: couch1
image: hyperledger/fabric-couchdb
env:
- name: COUCHDB_USER
value: "couch"
- name: COUCHDB_PASSWORD
value: "couchpass"
- name: DB_URL
value: "http://0.0.0.0:20192/member_db"
- name: couch2
image: hyperledger/fabric-couchdb
env:
- name: COUCHDB_USER
value: "couch"
- name: COUCHDB_PASSWORD
value: "couchpass"
- name: DB_URL
value: "http://0.0.0.0:20193/member_db"
volumeMounts:
- mountPath: /shared
name: sharedvolume
- mountPath: /host/var/run/docker.sock
name: dockersocket
ports:
- containerPort: 30985
name: client
Vadim
просто kubectl get pod -l name=couchnode1 ничего не находит
 stempher
а если kubectl get po,statefulsets --all-namespaces
 blkmrkt
Так это короче, если у меня кластер из 7 залуп и других пользователей нет, то можно не апгрейдиться от CVE-2018-1002105?
 Puma
Нет
Vadim
скинь сюда IP, мы сами проапгрейдим
Mentat
Так это короче, если у меня кластер из 7 залуп и других пользователей нет, то можно не апгрейдиться от CVE-2018-1002105?
Сегодня нет, завтра есть. Там не страшно :)
blkmrkt
хммм
blkmrkt
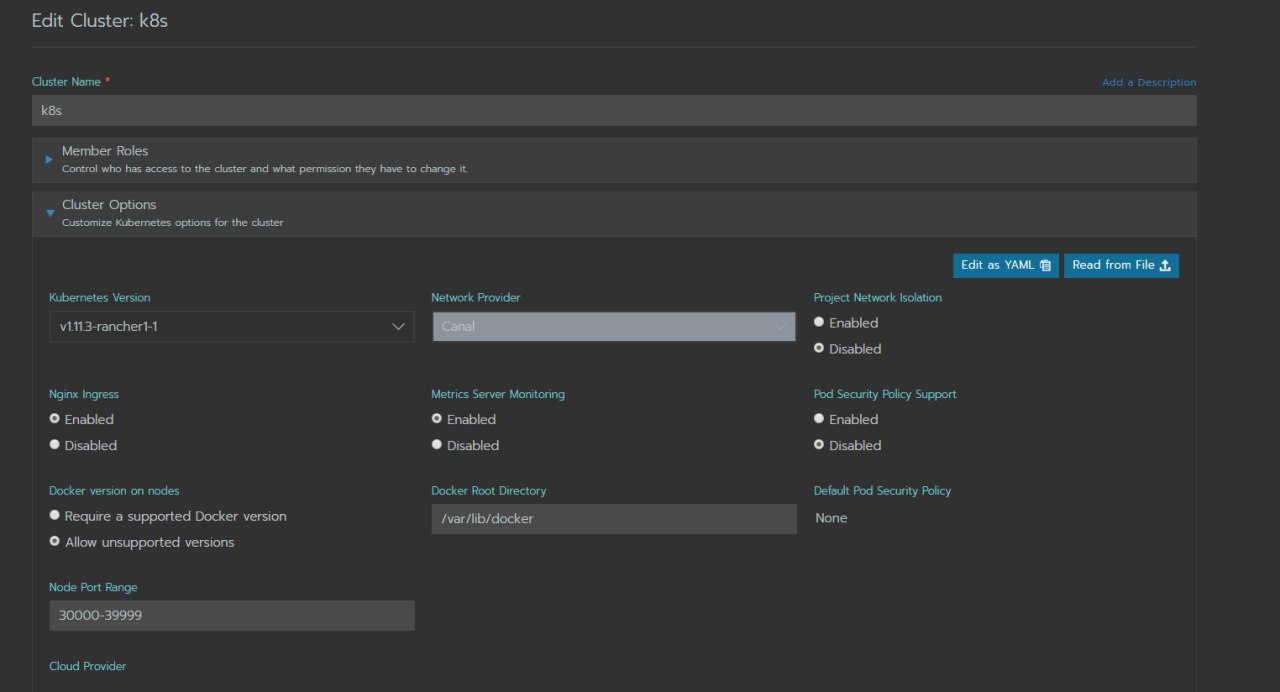
на сайте Ранчера написано что он может апгрейдить кластеры, а в доках v2 ни слова о таком функционале нет
blkmrkt
 Семён
ну ранчер в принципе можно прямо с даунтаймом апдейтить
Семён
к8с без него нормально проживёт )
blkmrkt
будет чем заняться сегодня
Vadim
тогда kubectl describe statefulset couchnode1
да, так видно контейнеры в сете. но почему не видно поды?
Vadim
PSP выключены, metrics server включен, мммм
Семён
тык это вообще тестовый стенд )
Mik
Кто использует Fluentbit для публикации логов напрямую в ES?
 Andrey
Ребят, а кто в курсе, у kubernetes-dashboard отпилили метрики из heapster, а что-то дали взамен?)
Anton
Ребят, а кто в курсе, у kubernetes-dashboard отпилили метрики из heapster, а что-то дали взамен?)
metrics server не поддерживается чтоли? я dashboard уже наверное год не видел
Andrey
metrics server не поддерживается чтоли? я dashboard уже наверное год не видел
да чот хер проссышь. В гите у них помойка какая-то
Sergio
Привет всем. При использовании annotations fluentbit.io/parser: docker
Ничего не проиcходит, возможно потому что fluent-bit в неймспейсе logging, а не в kube-system? Как это исправить?